Внутри Cilium CNI: расследование загадочных таймаутов при создании подов в Kubernetes
Глубокое погружение в то, как команда инженеров платформы данных Adyen расследовала и устранила узкое место с линейной сложностью в сборке мусора таблицы отслеживания соединений Cilium CNI, из-за которого на высоконагруженных узлах таинственно зависало создание новых подов.
Год назад я прекрасно понимал, что одна строчка конфигурации способна сломать сетевой стек Kubernetes. Но если бы мне тогда сказали, что завершившиеся несколько часов назад поды могут заблокировать запуск новых — я бы решил, что это шутка.
В высокопроизводительных сетях 35 секунд — это целая вечность. Именно столько требовалось, чтобы обойти таблицу отслеживания соединений (connection tracking table) из 7 миллионов записей при максимальной скорости около 200 000 записей в секунду. На пиковых 16 миллионах записей последовательный обход занимал до 80 секунд, что приводило к таймаутам Cilium CNI и блокировало запуск новых подов на затронутых узлах.
Это линейное поведение мы обнаружили в Adyen, трассируя системные вызовы, изучая исходный код и анализируя внутреннее устройство eBPF. Расследование показало, как разнообразие наших рабочих нагрузок превратило алгоритм сборки мусора таблицы отслеживания соединений в критическое узкое место.
Наша среда: в чём наша особенность
В Adyen Cilium CNI развёрнут на всех наших 100+ кластерах Kubernetes. Когда мы переходили с Calico на Cilium, мы понимали, что адаптация под наши рабочие нагрузки будет непростой. Наши продуктовые кластеры Kubernetes для больших данных используются совсем иначе, чем остальные кластеры внутри Adyen.
Извлечение данных из HDFS. Наша инфраструктура включает более 500 узлов данных (datanodes). Trino — одна из наших самых требовательных нагрузок на HDFS: она выполняет аналитические запросы к данным, хранящимся в HDFS. Из-за распределённой природы HDFS каждое скачивание файла требует нового соединения с одним из этих 500 узлов. В часы пик один под может создавать около 50 000 соединений в минуту.
Высокая текучесть подов (pod churn). Многие поды в наших кластерах выполняют пакетные задания — например, задания Spark. Они живут от нескольких секунд до пары часов.
Широкое разнообразие нагрузок. Одни нагрузки крайне требовательны к CPU, как поды Spark, выполняющие сложные соединения и трансформации при относительно небольшом количестве сетевых соединений. Другие создают огромный сетевой трафик, как поды Trino, запрашивающие тысячи небольших файлов в HDFS, — каждый файл требует нового соединения. Это порождает множество короткоживущих соединений, создающих нагрузку на таблицу отслеживания соединений.
Кроме того, наши машины мощнее большинства узлов Kubernetes-кластеров внутри Adyen:
-
Машины с 64 физическими ядрами и 512 ГБ ОЗУ
-
Машины с 128 физическими ядрами и 2 ТБ ОЗУ
На момент расследования мы использовали Kubernetes 1.31.7 и Cilium 1.16.5. Эти версии указаны специально, чтобы читатели, которым интересны детали, могли сопоставить наши находки с соответствующими кодовыми базами.
Чтобы поддерживать наши специфические нагрузки, мы постепенно настраивали Cilium: увеличивали таймауты DNS-прокси, расширяли ёмкость таблицы отслеживания соединений, повышали лимиты API и упрощали «метки безопасности». Эта конфигурация помогала нам решать одну проблему за другой — кроме одной:
Failed to create pod sandbox: rpc error: code = Unknown desc = failed to setup network for sandbox "0fecf4844d3f8f2df218f09d91f9698bb424e2166551952f46fd7638f4757cf2": plugin type="cilium-cni" failed (add): unable to create endpoint: Cilium API client timeout exceeded
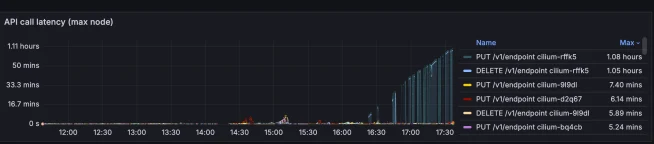
Kubernetes создавал под, поднимал песочницу (sandbox), а затем пытался настроить сеть через Cilium. Эта операция завершалась по таймауту. После этого на том же узле таймаутом заканчивался запуск любого другого пода. Кроме того, мы заметили, что на затронутых узлах увеличилась задержка API-вызовов DELETE /v1/endpoint и PUT /v1/endpoint — маршрутов, отвечающих за добавление и удаление Cilium-эндпоинта. На графике ниже хорошо видно, как задержки вызовов эндпоинтов начинают линейно расти с 16:20, — создание и удаление эндпоинтов так и не завершаются.
Важно отметить, что эти кластеры используются исключительно для аналитической обработки и работы с большими данными. Проблема была выявлена, проанализирована и полностью устранена до нарушения каких-либо SLO. Поскольку наши среды для больших данных изолированы от основных транзакционных потоков, проблема не затронула ни наш конвейер обработки платежей в реальном времени, ни транзакции мерчантов.
Симптом: что-то не так, но что именно?
Для начала мы обнаружили, что в логах агента Cilium нет никаких связанных таймаутов. Мы включили отладочное логирование в надежде найти скрытые ошибки. Безрезультатно. Логи давали общую картину, но не указывали на узкое место.
Тем не менее, отлаживая сломанные узлы, мы узнали кое-что полезное:
-
Вывод списка всех эндпоинтов на сломанном узле завершался по таймауту:
cilium endpoint list -
Просмотр логов конкретного эндпоинта работал нормально и показывал, что эндпоинт завис на фазе регенерации:
cilium endpoint log <ENDPOINT_ID> -
Запрос состояния эндпоинта через
kubectl get ciliumendpointпоказывал, что он всё ещё регенерируется, тогда как манифест Kubernetes сообщал о готовности. -
В файловой системе по пути
/var/run/cilium/stateбыли папки эндпоинтов с суффиксом_next, что указывало на незавершённое выполнение.
Это подтвердило нашу гипотезу: проблема была в агенте Cilium, а не на уровне kubelet или CNI-плагина. Но мы по-прежнему не понимали, почему.
Как Cilium настраивает сеть для пода
Прежде чем перейти к самому расследованию, полезно разобраться, что происходит при запуске пода и настройке его сети через Cilium.
Процесс начинается с того, что Kubernetes назначает под конкретному узлу. Kubelet инициирует настройку пода и вызывает настроенный CNI-плагин (в нашем случае — Cilium). CNI-плагин Cilium выполняет несколько операций:
Выделяет IP-адрес с помощью IPAM (управление IP-адресами). Создаёт сетевой интерфейс (в нашей конфигурации — пару veth: один конец в пространстве имён хоста, другой — в поде). Настраивает сеть пода: задаёт IP-адрес, настраивает маршруты и параметры sysctl. Создаёт Cilium-эндпоинт через API агента Cilium. Запрашивает или выделяет идентификатор безопасности по меткам пода. Вычисляет сетевую политику для данного эндпоинта. Генерирует, компилирует и внедряет код eBPF в ядро. Возвращает успешный статус kubelet-у.
Ключевой момент: при создании пода и, следовательно, эндпоинта CNI-плагин обращается к агенту Cilium, который работает как DaemonSet на каждом узле. Именно агент берёт на себя основную работу: управляет eBPF-картами, обрабатывает таблицу отслеживания соединений, применяет сетевые политики и многое другое.
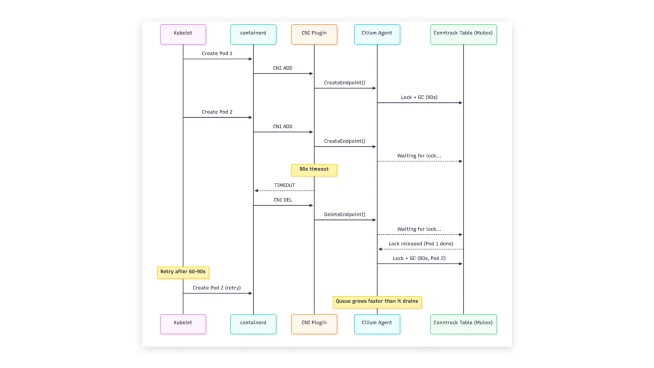
Упрощённая схема этого процесса:
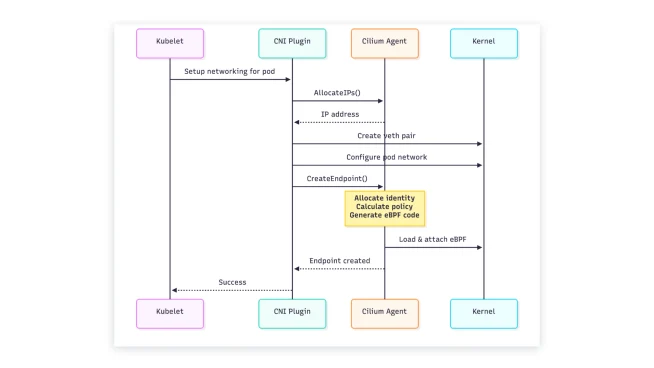
Важная часть процесса происходит при создании эндпоинта: Cilium запускает сборку мусора таблицы отслеживания соединений, чтобы убедиться, что IP-адрес пода не содержит остаточных соединений от предыдущего запуска. Эту операцию выполняет функция scrubIPsInConntrackTable — она сканирует всю таблицу conntrack и удаляет соответствующие записи.
Последствия сбоя сборки мусора весьма серьёзны. Устаревшие записи накапливаются без ограничений: хотя наша таблица вмещает до 16 миллионов записей, настоящим узким местом становится обязательное сканирование при каждом создании нового пода. Эта очистка необходима, чтобы избежать конфликтов при повторном использовании IP-адресов: свежий под не должен унаследовать открытые соединения от предыдущего.
Здесь и начинается наша история.
Примечание: Превосходное глубокое погружение Артура Чао в реализацию CNI Cilium во многом определило наше понимание потока CNI. Несмотря на то что статья написана несколько лет назад, основные концепции по-прежнему актуальны и станут бесценным ресурсом для всех, кто хочет понять, как Cilium работает изнутри.
В глубину: поиск первопричины
Что вообще делает агент?
Нам нужно было понять, чем занимается агент Cilium, когда зависает. На помощь пришёл pprof — встроенный профилировщик Go. Мы включили pprof в конфигурации Cilium и сняли трассировки со сломанного узла сразу после запуска 50 подов.
Профили CPU и памяти поначалу ничего особенного не показали. Зато когда мы открыли трассировки выполнения (execution traces), временна́я шкала наглядно показала, чем занималась каждая горутина, — и всё сразу стало ясно.
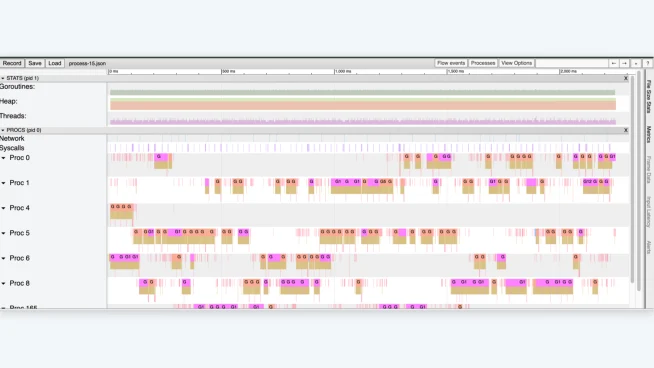
Мы увидели долго работающие горутины, всё время которых уходило на системные вызовы. При более детальном рассмотрении проявился характерный паттерн:
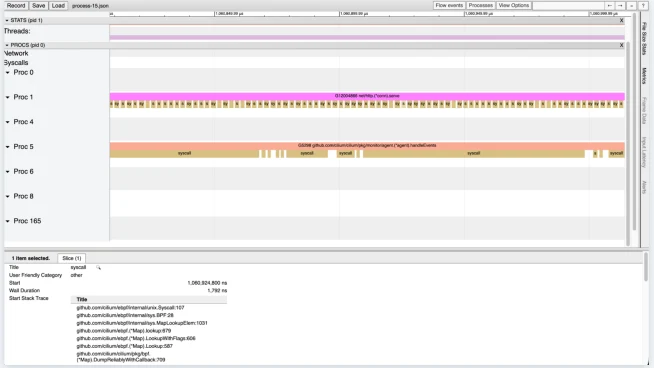
Агент выполнял BPF-системные вызовы в плотном цикле: nextKey(), lookup(), nextKey(), lookup() — снова и снова. Агент использует эти системные вызовы для итерации по eBPF-карте:
-
nextKey(currentKey)— возвращает следующий ключ в BPF-карте послеcurrentKey -
lookup(key)— возвращает значение, связанное сkey
Сделаем быстрый подсчёт «на салфетке». Мы взяли фрагмент длиной 35 миллисекунд и насчитали 14 916 системных вызовов. Это 426 171 вызов в секунду. Поскольку для получения каждого элемента eBPF-карты нужно два вызова (nextKey + lookup), мы проходили примерно 213 000 записей в секунду.
Поскольку Cilium — это процесс в пространстве пользователя (user space), обращение к карте или её изменение влечёт переключение контекста (context switch) при каждом системном вызове. Переключение контекста — это процесс, при котором CPU временно приостанавливает пользовательский процесс (Cilium), выполняет код в ядре (обрабатывает BPF-вызов) и затем возобновляет пользовательский процесс. Это требует сохранения и восстановления всего состояния регистров CPU и адресного пространства, что создаёт значительные накладные расходы и является главным источником задержки.
Вот ключевое наблюдение: это последовательная операция. Распараллелить её невозможно, потому что для получения следующего ключа нужен текущий. Даже на наших мощных серверных CPU это был максимум достижимой скорости. В трассировках было ещё одно важное обстоятельство: всё это происходило в функции scrubIPsInConntrackTable — той самой, которая очищает таблицу отслеживания соединений при создании эндпоинта.
Почему так много системных вызовов? Таблица отслеживания соединений
Тут мы вспомнили кое-что из вывода cilium status --verbose:
BPF Maps: dynamic sizing: on (ratio: 0.005000)
Name                       Size
TCP connection tracking    16777216
Non-TCP connection tracking 14232516
...
Наша таблица отслеживания TCP-соединений имела максимальный размер 16 миллионов записей — вдвое больше стандартных восьми миллионов для машины с 2 ТБ ОЗУ. Несколько месяцев назад мы намеренно задали cilium_bpf_map_dynamic_size_ratio: 0.0050 в нашем Helm Chart, рассчитывая, что ёмкость таблицы отслеживания соединений будет пропорционально масштабироваться с ростом объёма памяти на разных типах узлов. Тогда это было плановым масштабированием для предотвращения исчерпания таблицы на машинах с 512 ГБ ОЗУ при высокопроизводительных нагрузках. Конфигурация работала как задумано, поддерживая эволюцию наших нагрузок. Однако по мере роста трафика она создала новую проблему масштабирования: большая таблица на узлах с 2 ТБ ОЗУ начала нетривиально взаимодействовать с алгоритмом автомасштабирования сборки мусора CNI.
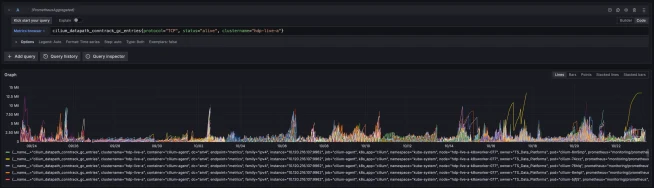
Но сколько записей находилось в таблице в действительности? Мы вывели их командой cilium bpf ct list global. Результат — около 7 миллионов записей. Интересная деталь: когда мы сравнили метки времени поля expires с временем работы системы (uptime), выяснилось, что подавляющее большинство записей уже истекло, некоторые — несколько часов назад. Это прямо указало нас на механизм сборки мусора.
Быстрые расчёты становятся показательными:
-
Максимальная скорость итерации: ~200 000 записей в секунду
-
Текущий размер таблицы: 7 миллионов записей
-
Время обхода текущей таблицы: 35 секунд
-
Максимальный размер таблицы: 16 миллионов записей (в худшем случае)
-
Время обхода полной таблицы: 80 секунд
Это означало, что при каждом создании или удалении эндпоинта мы тратили до 35 секунд на итерацию по таблице отслеживания соединений, а в худшем случае — до 80 секунд. Напомним, что таймаут CNI составляет 90 секунд.
Но позвольте: если записи истекли, почему сборщик мусора их не удалял?
Почему истекшие записи не удаляются? Сбой сборки мусора
В Cilium есть сборка мусора для таблицы отслеживания соединений. Судя по метрикам, GC (сборка мусора) запускалась довольно часто:
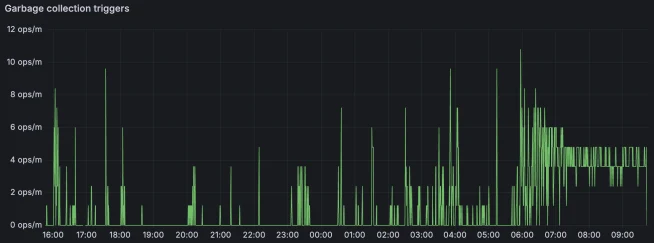
Однако когда мы посмотрели, что именно удалял сборщик мусора, обнаружилась проблема:
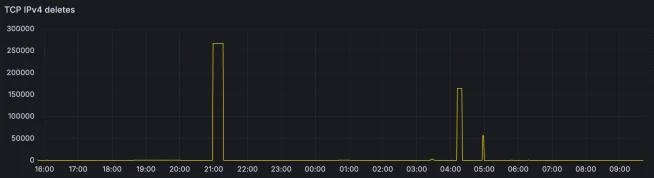
Сборщик мусора запускался часто, но практически ничего не удалял. Лишь изредка он удалял значительное количество записей.
Изучение исходного кода прояснило причину. В Cilium есть два типа операций GC:
Очистка, привязанная к эндпоинту: при создании или удалении эндпоинта удаляются записи, соответствующие IP-адресу этого эндпоинта. Периодическая очистка истекших записей: выполняется по интервалу и удаляет все истекшие записи.
Почти все частые запуски GC в метриках (первый тип — очистка по эндпоинту) были вызваны созданием и удалением подов. Периодическая очистка (второй тип), удаляющая истекшие записи, почти не выполнялась.
Почему? Потому что интервал GC автоматически масштабируется в зависимости от того, сколько записей было удалено:
// Упрощённо из исходного кода Cilium
func GetInterval(interval time.Duration, maxDeleteRatio float64) time.Duration {
    if maxDeleteRatio > 0.25 {
        // Удалено > 25% записей → GC запускается чаще
        interval = time.Duration(float64(interval) * (1.0 - maxDeleteRatio))
    } else if maxDeleteRatio < 0.05 {
        // Удалено < 5% записей → GC запускается реже
        interval = time.Duration(float64(interval) * 1.5)
    }
    if interval > ConntrackGCMaxLRUInterval {
        interval = ConntrackGCMaxLRUInterval // 12 часов
    }
    return interval
}
Вот в чём проблема для таблицы с 16 миллионами записей:
-
Чтобы удалить более 5% (и не замедлить интервал), нужно удалить 800 000+ записей
-
Чтобы удалить более 25% (и ускорить интервал), нужно удалить 4+ миллиона записей
-
Начальный интервал: 5 минут
-
Максимальный интервал: 12 часов
Представьте такой сценарий:
-
Узел изначально имеет небольшой объём соединений — он только что введён в работу или выполняет лёгкие нагрузки.
-
Сборщик мусора удаляет менее 5% записей за запуск, не достигая порога для более частых циклов.
-
Интервал сборки мусора постепенно растёт с нескольких минут до максимума в 12 часов: сначала 7,5 минут, затем 11,25, затем 16,875 и так далее.
-
На узел попадают тяжёлые нагрузки по обработке данных, генерирующие большой объём сетевого трафика.
-
Новые соединения заполняют таблицу отслеживания в течение до 12 часов до следующего запуска сборщика мусора.
К моменту, когда сборка мусора наконец выполняется, таблица отслеживания соединений может успеть накопить до 16 миллионов устаревших записей. Даже если один запуск GC удалит достаточно записей для временного восстановления скорости, сам по себе чрезмерно большой интервал между циклами создаёт серьёзную проблему. Это отставание позволяет таблице снова накапливать большое количество устаревших записей, и каждый под, создаваемый в длинном промежутке после предыдущего GC, вынужден оплачивать полную стоимость последовательного сканирования.
Почему проблема нарастает? Мьютексы, таймауты и повторные попытки
Один медленный запуск пода — это очень неприятно, но проблема резко усугублялась, когда несколько подов пытались запуститься одновременно.
Мы сняли дамп горутин агента Cilium с помощью gops и проанализировали его скриптом, группирующим похожие трассировки стека. Результаты оказались показательными:
- 57 случаев:
  createEndpoint() → WaitForFirstRegeneration() → ожидание RWMutex
- 57 случаев:
  regenerateBPF() → runPreCompilationSteps() → вызов запущен
- 56 случаев:
  scrubIPsInConntrackTable() → garbageCollectConntrack() → ожидание Lock
На таблицу отслеживания соединений установлен глобальный мьютекс. Когда мы запускали 50 подов одновременно:
-
Под 1 захватывает блокировку и начинает 80-секундную итерацию по таблице
-
Поды 2–50 выстраиваются в очередь, ожидая блокировки
-
Под 1 завершает работу через 80 секунд
-
Под 2 захватывает блокировку, начинает ещё одну 80-секундную итерацию
-
Но таймер пода 2 отсчитывает уже 80 секунд → таймаут на 90-й секунде
-
Под 2 завершается по таймауту
-
Подам 3–50 нет никаких шансов
Дальше — хуже. Когда CNI завершается по таймауту через 90 секунд:
-
Таймаут возвращает ошибку вызывающей стороне
-
Но нижележащая работа не останавливается — агент продолжает итерацию
-
Среда выполнения контейнеров (containerd) немедленно вызывает
DeleteEndpoint() -
Удаление тоже требует обхода таблицы conntrack
-
В системе накапливается очередь из операций создания и удаления
Затем Kubernetes начинает повторные попытки:
-
Цикл
podWorkerLoopkubelet-а повторяет попытку через 60–90 секунд (с дрожанием — jitter) -
Каждая повторная попытка добавляет в очередь новые запросы на создание и удаление эндпоинта
-
Очередь растёт быстрее, чем опустошается
Это было видно в логах. Для одного пода (cilium-node-breaker-5) мы наблюдали следующее:
-
15:54:30 — Создание эндпоинта (попытка 1)
-
15:56:00 — Удаление эндпоинта (таймаут)
-
15:57:12 — Создание эндпоинта (попытка 2)
-
15:59:57 — Создание эндпоинта (попытка 3)
-
16:02:39 — Создание эндпоинта (попытка 4)
Узел входил в цикл конкуренции: новые задачи поступали быстрее, чем выполнялись старые, и очередь так и не опустошалась.
Полная картина происходящего:
Исправление: одна строка, чтобы всем управлять
После столь долгого расследования само исправление оказалось обескураживающе простым. Мы не могли полагаться на автомасштабирование интервала GC, потому что на малоактивных узлах этот интервал неизбежно вырастал до неприемлемых значений. Поэтому мы отключили автомасштабирование, задав фиксированное значение:
conntrackGCInterval: 60sВсё. Одна строка конфигурации гарантирует, что сборка мусора запускается не реже чем раз в минуту — вне зависимости от того, сколько записей удаляется. Мы применили изменение в 9:00 и завершили обновление DaemonSet к 10:00. Результаты говорят сами за себя:
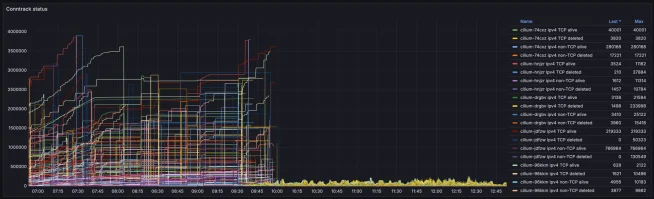
Размер таблицы conntrack резко упал и стабилизировался. Что ещё важнее, задержки API-вызовов вернулись к нормальным значениям:
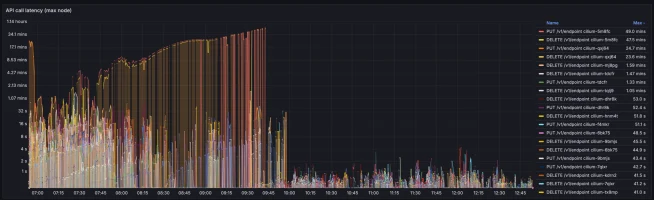
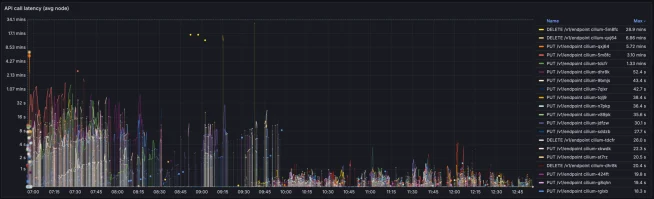
С момента исправления ошибка с таймаутом не возникала ни разу. Время запуска подов снова стабильно.
Выводы
Параметры масштабирования могут взаимодействовать с долгим запозданием. Наша превентивная настройка bpf_map_dynamic_size_ratio для поддержки масштабирования нагрузок на машинах с 512 ГБ ОЗУ успешно решила исходные проблемы с ёмкостью. Однако по мере эволюции аналитических нагрузок и роста трафика больший размер таблицы, динамически выделяемый на машинах с 2 ТБ ОЗУ, выявил нетривиальное взаимодействие с алгоритмом автомасштабирования GC в CNI. Последствия таких параметров масштабирования могут проявляться спустя месяцы по мере роста трафика — особенно в средах с адаптивными фоновыми циклами.
Наблюдаемость и понимание всего стека критически важны. Логи показывали симптомы, но для выявления первопричины нам потребовались профилирование и трассировка всего стека. Среда выполнения контейнеров (таймауты, поведение при удалении), CNI-плагин (значения таймаутов), агент Cilium (мьютексы, логика GC) и ядро Linux (eBPF-карты, производительность системных вызовов) — все эти уровни были необходимы для понимания того, почему возникли таймауты при создании подов. К тому же быстрые расчёты с реальными числами оказались очень мощным инструментом. Как только у нас были ключевые цифры — 200 000 системных вызовов в секунду, 12 миллионов записей в таблице и 90-секундный таймаут — мы определили первопричину задолго до того, как поняли всю цепочку. Всегда измеряйте реальные характеристики производительности вашей системы, а не только теоретические пределы.
У алгоритмов автомасштабирования должны быть ограничения. Автомасштабирование интервала GC в Cilium логично для большинства развёртываний: если удаляется много записей — запускать GC чаще; если мало — экономить CPU, запуская реже. Но алгоритм не учитывал переменные нагрузки, когда машина долго работает с малым объёмом соединений, а потом с появлением одного пода получает резко возросший трафик. Алгоритм также не принимал во внимание очень большие таблицы, где «5% записей» — это огромное абсолютное число. Максимальный интервал в 12 часов оказался слишком большим для наших нагрузок. Автомасштабирование без тщательного анализа граничных случаев может обернуться против вас.
Таймауты не останавливают работу. Когда CNI завершился по таймауту, мы предположили, что работа прекратится. Но нет — агент продолжал обработку в фоне, пока новые запросы выстраивались в очередь. Это типичная ситуация в распределённых системах: таймаут защищает вызывающую сторону, но не обязательно отменяет операцию. Там, где нужна отмена, будьте явными в её реализации.
Здоровье conntrack нужно мониторить как полноценную операционную метрику. Разница между здоровым кластером и циклом конкуренции была отчётливо видна в нескольких метриках, за которыми мы не следили:
-
Длительность GC —
cilium_datapath_conntrack_gc_duration_seconds— выросла с 1 с до 80 с -
Размер таблицы —
cilium_datapath_conntrack_gc_entries— 7 миллионов записей, большинство истекших
Мы теперь рекомендуем проактивно настраивать оповещения по этим метрикам для любого развёртывания Cilium с динамическими нагрузками — вместе с установкой conntrackGCInterval: 60s. Не жертвуйте надёжностью запуска подов в часы пик ради экономии CPU в тихие периоды.
Заключение
Таинственную ошибку с таймаутом, которая мешала запускать новые поды на нашей платформе больших данных, в итоге устранила одна строка конфигурации: conntrackGCInterval: 60s. Расследование показало, что первопричиной стал алгоритм автомасштабирования сборки мусора Cilium: он позволял интервалу очистки вырасти до 12 часов, что приводило к массовому накоплению устаревших записей и ловушке линейного времени итерации.
Этот опыт дал нам важнейшие уроки об устойчивости систем и необходимости понимать весь стек целиком. Мы убедились, что параметры масштабирования и распределения ресурсов могут давать отложенные эффекты, которые проявляются лишь спустя месяцы по мере эволюции нагрузок. Мы также выяснили, что алгоритмы автомасштабирования нуждаются в жёстких ограничениях — иначе в граничных случаях, как, например, переменный объём соединений на наших высокопроизводительных машинах, они могут деградировать непредсказуемо. Расследование также показало: таймауты зачастую защищают лишь вызывающую сторону, не останавливая нижележащую работу, и это способно запустить цикл конкуренции с повторными попытками, который можно диагностировать только через глубокую наблюдаемость — с анализом мьютексов, системных вызовов и внутреннего устройства eBPF.
Двигаясь вперёд, стоит задать себе вопрос: действительно ли адаптивное поведение нашей инфраструктуры нас защищает — или оно лишь скрывает неэффективности, которые обнаруживаются только на пиковой нагрузке? Относясь к здоровью conntrack как к полноценной операционной метрике и отдавая приоритет надёжности перед незначительной экономией CPU, мы можем строить более устойчивые системы. И запомните: если вы когда-нибудь увидите загадочные таймауты в вашем CNI — иногда ответ прячется в 426 000 системных вызовов в секунду.