Введение
Тысячи микросервисов Uber обслуживают трафик более 170 миллионов ежемесячно активных пользователей: пассажиров, пользователей Uber Eats, водителей и курьеров. В основе этой инфраструктуры лежат Docstore и Schemaless — собственные распределённые базы данных Uber, построенные поверх MySQL®. Эти базы данных охватывают тысячи кластеров, хранят десятки петабайт операционных данных и обрабатывают десятки миллионов запросов в секунду с миллиардами операций чтения и обновления строк. На них держатся самые латентно-чувствительные и критически важные рабочие нагрузки, обеспечивая работу всех бизнес-направлений Uber: от поездок и доставки до карт, платежей и многого другого.
При таком масштабе даже незначительные перегрузки не остаются изолированными событиями — они распространяются каскадом. Короткий всплеск в одной части системы расходится волнами: сервисы ниже по стеку начинают таймаутить, повторные запросы накапливаются, а деградация усиливается и превращается в масштабный сбой. В мультитенантной среде также критически важно обеспечивать справедливое распределение ресурсов и не позволять одному тенанту монополизировать их. Поскольку рабочие нагрузки различаются по характеру трафика, профилям задержек и влиянию на систему, построение эффективной защиты от перегрузок — задача исключительно сложная.
Цена ошибки при проектировании такой защиты очень высока. В этой статье мы расскажем, как построили интеллектуальный менеджер нагрузки (load manager), который обнаруживает перегрузку по нескольким сигналам и удерживает базы данных в стабильном и справедливом состоянии под давлением.
Docstore и Schemaless
Прежде чем перейти к менеджеру нагрузки, защищающему базы данных Uber, рассмотрим их архитектуру.
Docstore поддерживает транзакции с полным набором CRUD-операций, а Schemaless оптимизирован для append-only рабочих нагрузок, однако оба построены на общей архитектурной основе. Она включает три основных уровня: stateless-движок запросов (query engine), stateful-движок хранения (storage engine) и плоскость управления (control plane). В рамках этой статьи мы сосредоточимся на уровнях движка запросов и движка хранения.
Stateless-движок запросов отвечает за планирование запросов, маршрутизацию, шардирование, управление схемой, авторизацию, разбор и валидацию запросов. Он выступает маршрутизирующим уровнем: координирует и проверяет клиентские запросы перед передачей их на уровень хранения.
Stateful-движок хранения управляет транзакциями, пулингом соединений, консенсусом и репликацией. Данные шардируются по множеству партиций, каждая из которых состоит из одного лидера и двух фолловеров, скоординированных через Raft для обеспечения строгой согласованности. Каждая партиция опирается на узлы MySQL с локально подключёнными NVMe SSD, рассчитанными на высокопропускные и низколатентные нагрузки при любом масштабе.
Трудности
Ограничение запросов на основе квот в слое движка запросов
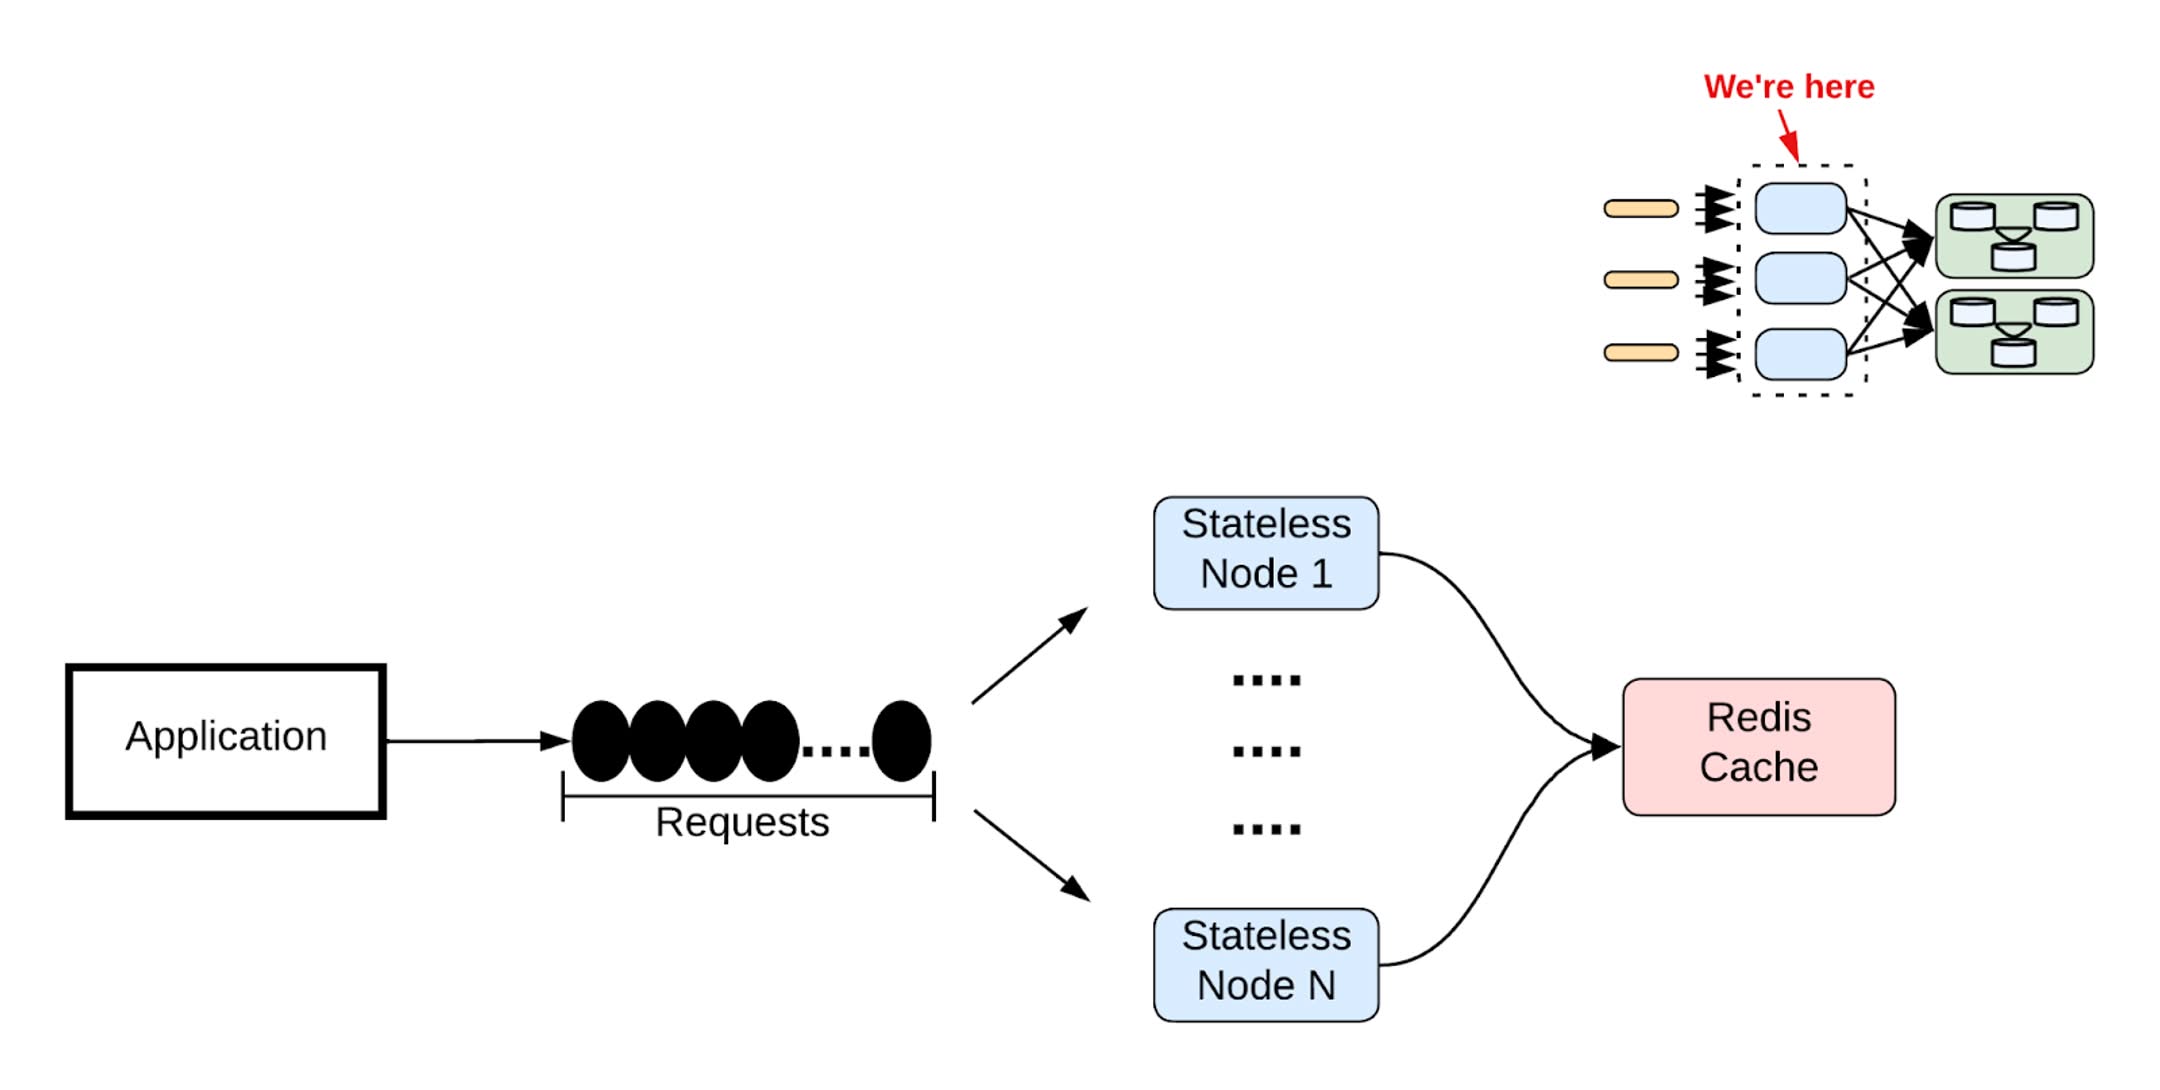
Изначально мы исследовали подход на основе квотного ограничения запросов (quota-based rate limiting) в рамках stateless-слоя движка запросов. Идея была простой: назначить каждому запросу на чтение и запись стоимость в единицах ёмкости (capacity unit) исходя из обрабатываемых байт, выдать пользователям фиксированные квоты и возвращать ответ 429 при их превышении. Поскольку узлы маршрутизации были stateless, мы хранили использование квот в централизованном кэше Redis®. Идея выглядела убедительно, однако на практике себя не оправдала.
Во-первых, она добавляла ненужную сложность. Каждый запрос требовал обращения к Redis, вводя новую точку отказа и накладные расходы лишнего сетевого хопа.
Кроме того, для точного сброса запросов к перегруженной партиции хранилища stateless-слою маршрутизации пришлось бы поддерживать актуальную информацию о здоровье и нагрузке тысяч партиций по всей системе. Это порождало значительные накладные расходы на отслеживание, что подрывало масштабируемость архитектуры.
Модель стоимости также оказалась слишком неточной. В Docstore и Schemaless из-за особенностей работы MySQL со сканированием и фильтрацией запрос, выполняющий полное сканирование таблицы, но возвращающий одну строку, получал ту же стоимость в единицах ёмкости, что и запрос, читающий одну строку напрямую. Этот принципиальный изъян в измерении нагрузки означал, что лёгкие и тяжёлые операции обращались одинаково, делая применение квот ненадёжным.
Наконец, квоты задавались статически, что порождало постоянные обращения стейкхолдеров с просьбами их скорректировать, — в мультитенантных средах такой подход оказывался неэффективным.
Несмотря на первоначальную привлекательность, этот подход провалился. Зато он дал нам ключевое понимание: управление перегрузкой должно располагаться как можно ближе к узлам хранения. Это осознание стало краеугольным камнем итогового дизайна на уровне stateful-хранилища.
Выбор правильного сигнала перегрузки
Центральная сложность при проектировании устойчивого менеджера нагрузки — выбор надёжного сигнала перегрузки. Простое ограничение по QPS слишком грубо: оно не учитывает вариативность нагрузки и нередко запускает сброс либо слишком поздно, либо слишком рано. Более эффективным сигналом может служить конкурентность (concurrency) — количество операций, одновременно находящихся в обработке. Она непосредственно отражает загрузку системы согласно закону Литтла: Конкурентность = Пропускная способность × Задержка. В stateful-системах конкурентность тесно соотносится с использованием ресурсов, что делает её более надёжным индикатором.
Баланс между устойчивостью и справедливостью
Баланс между устойчивостью и справедливостью — одна из ключевых задач в мультитенантных системах. При общесистемной нагрузке мы хотим сбрасывать трафик по приоритету, отбрасывая сначала низкоприоритетные запросы. Но когда один «шумный» тенант монополизирует ресурсы, не вызывая глобальной перегрузки, нам нужно и отдельное ограничение на уровне тенанта, работающее независимо от состояния системы. Это двойное требование привело нас к сочетанию динамических детекторов перегрузки с механизмами обеспечения справедливости, работающими параллельно.
Закладка фундамента единого менеджера нагрузки
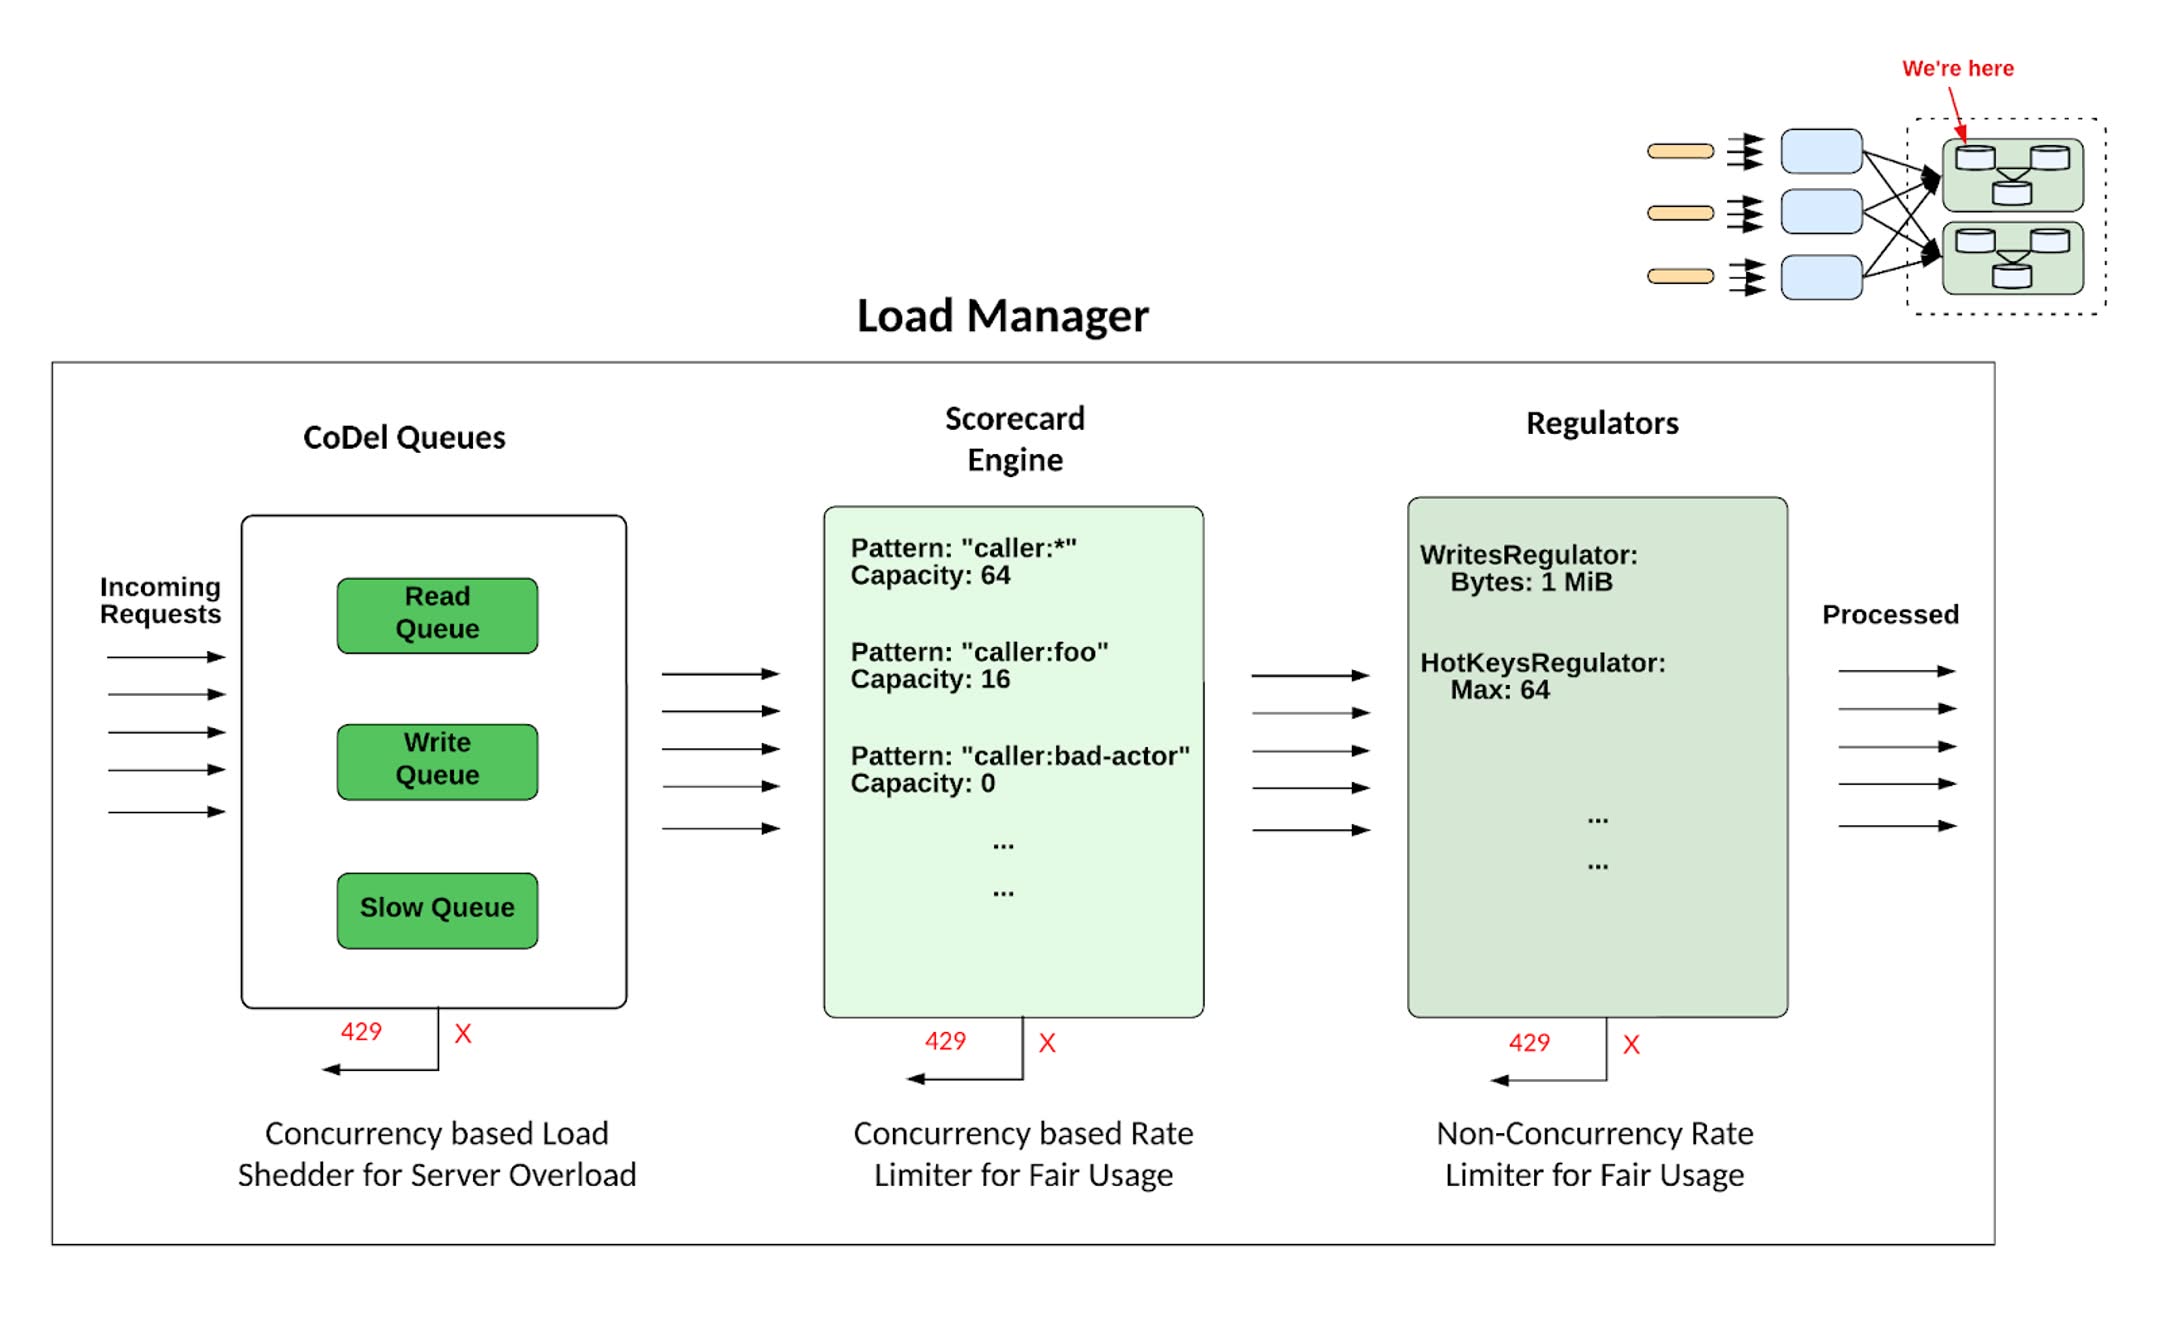
Controlled Delay: более умная очередь под давлением
Путь к сбросу нагрузки начался с CoDel (Controlled Delay) — концепции, заимствованной из сетевых технологий для борьбы с буферным раздуванием (bufferbloat). Вместо того чтобы сбрасывать запросы по длине очереди, CoDel смотрит на время ожидания запроса в очереди, отдавая предпочтение отзывчивости, а не объёму.
Мы реализовали отдельные очереди CoDel для каждого типа операций:
-
Очередь чтения: для точечных поисков и лёгких запросов
-
Очередь записи: для операций вставки, обновления и upsert
-
Медленная очередь: для длительных и фоновых операций, таких как сканирование, удаление или репликация
Каждая очередь управлялась независимо, что обеспечивало лучшую изоляцию между рабочими нагрузками.
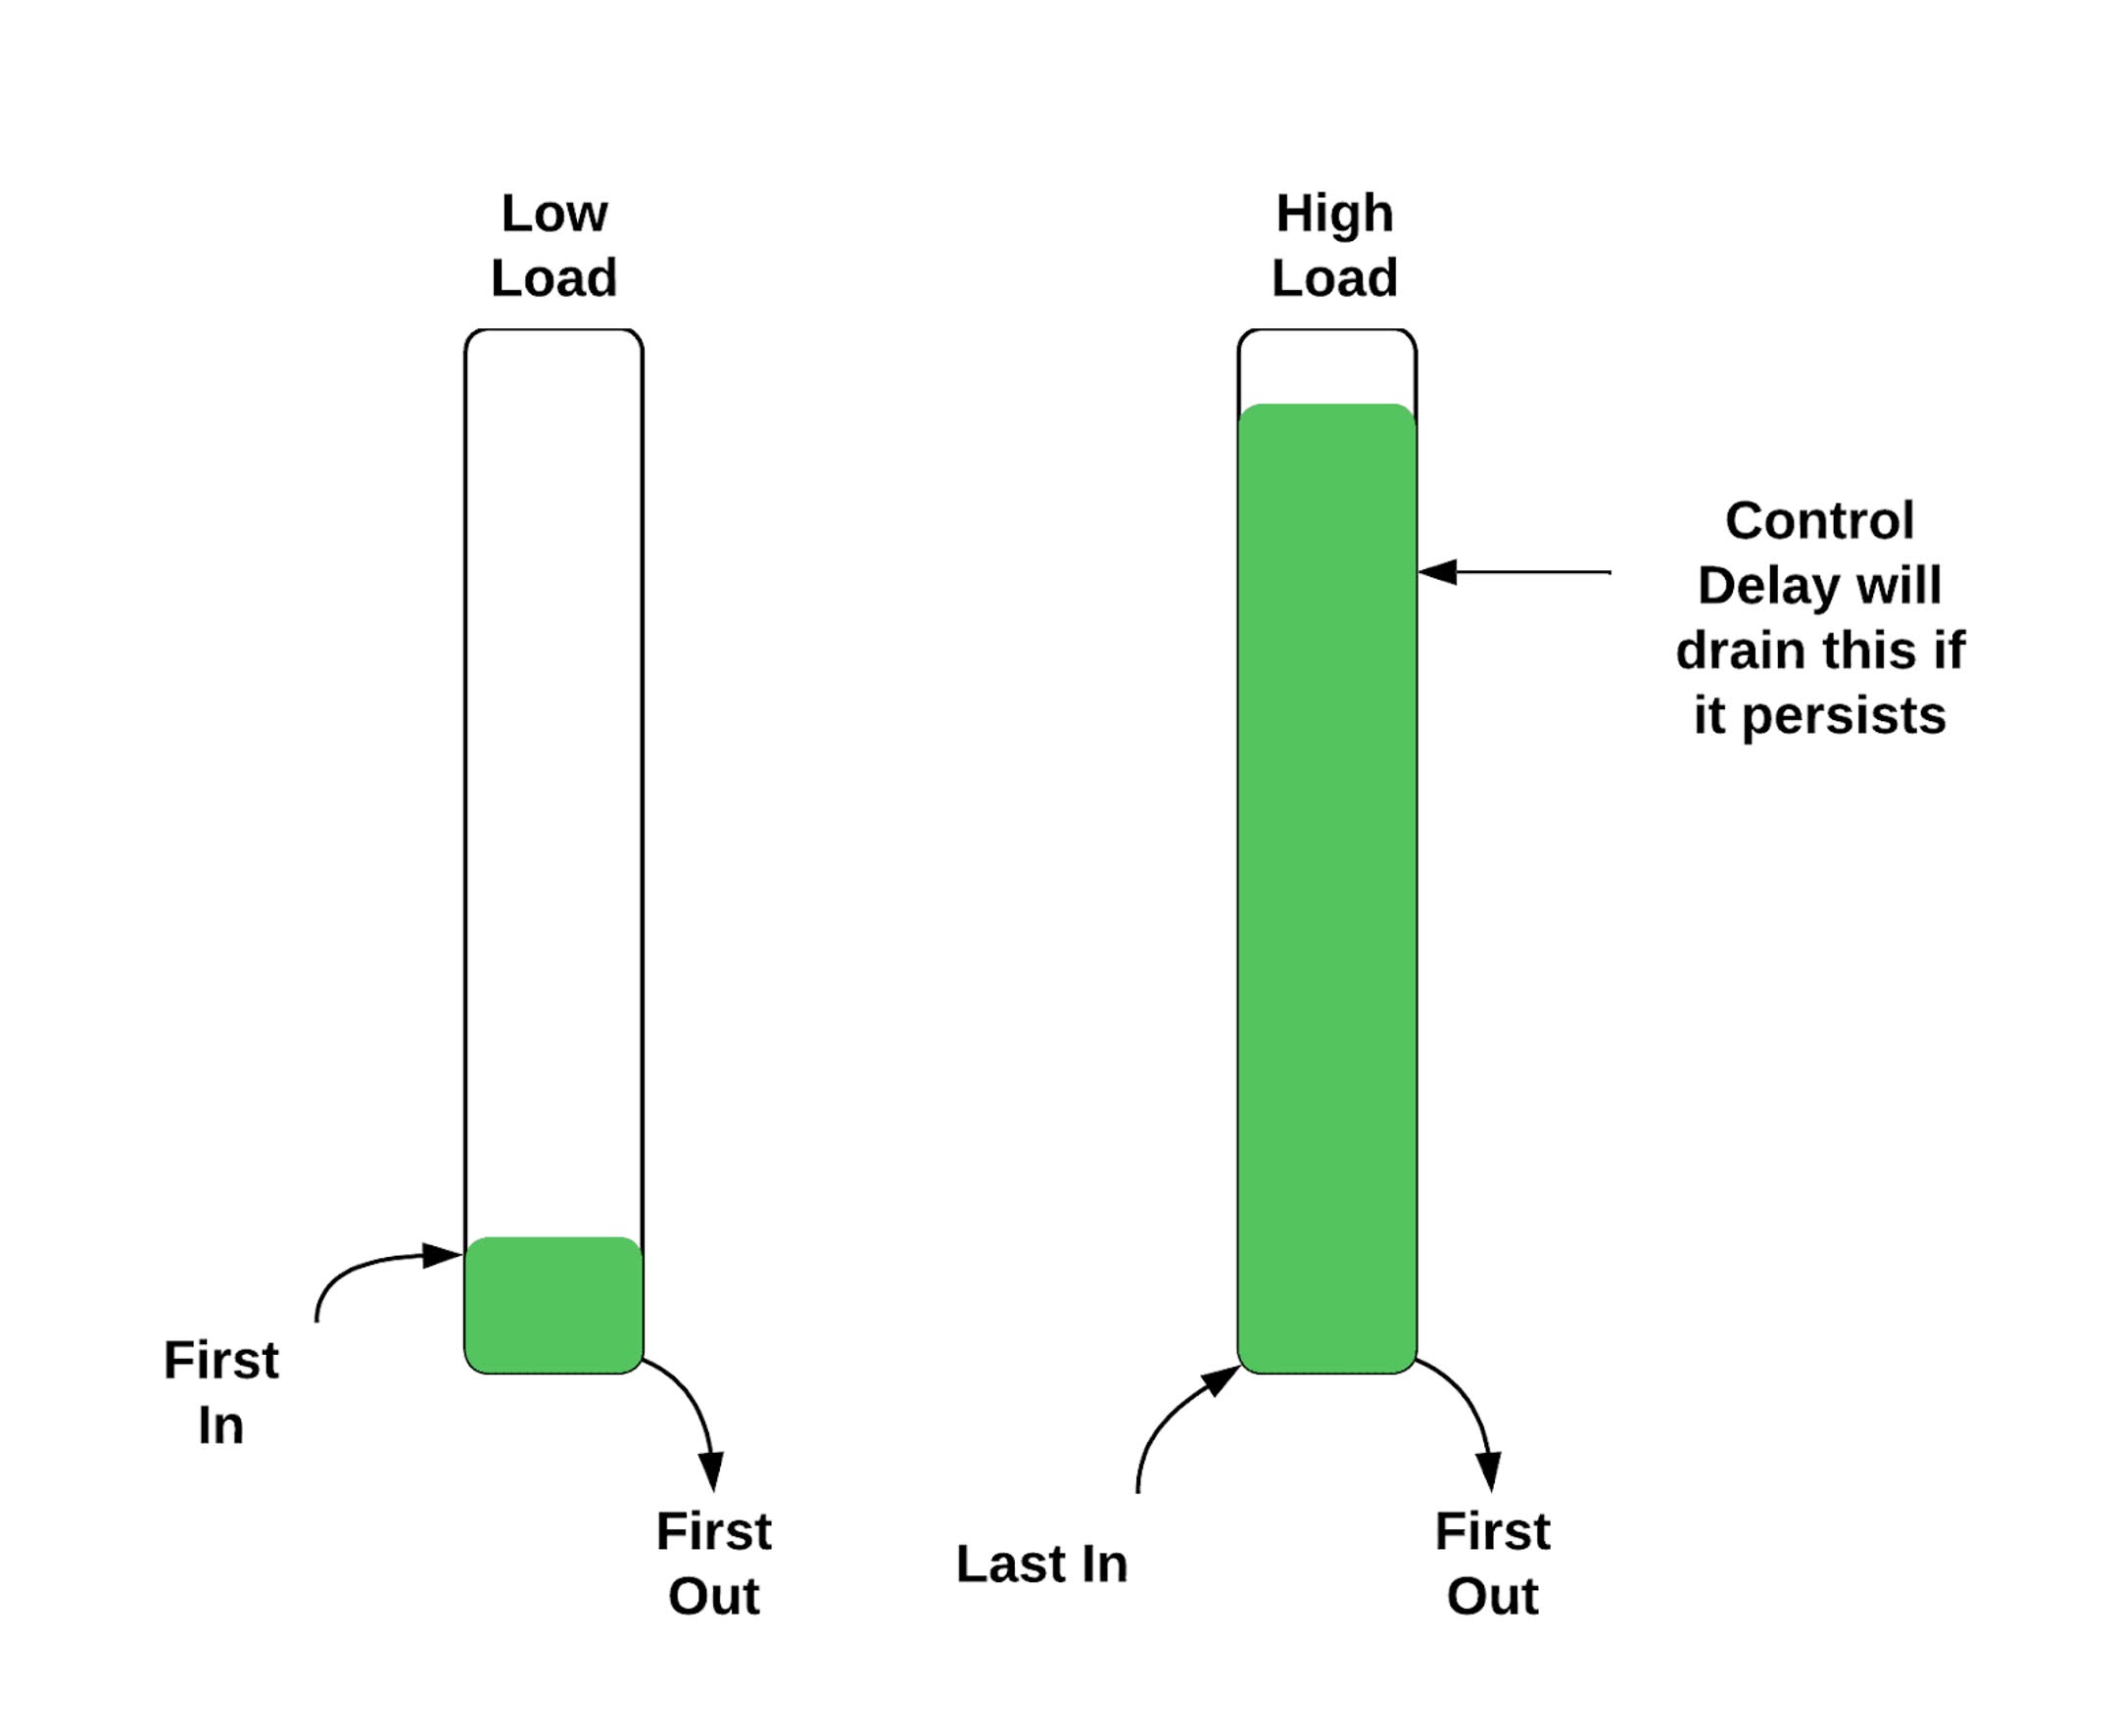
Обычной FIFO-очереди оказалось недостаточно: она обрабатывает запросы в порядке поступления, что хорошо работает при стабильном трафике. Но под перегрузкой FIFO создаёт ловушку: старые запросы накапливаются, долго ждут и нередко отбрасываются или повторяются клиентом. В итоге работа выполняется впустую, тогда как свежие запросы — ещё актуальные и с высоким шансом на успех — стоят в конце очереди.
CoDel решает эту проблему с помощью адаптивного LIFO. На рисунке 5 показан принцип его работы.
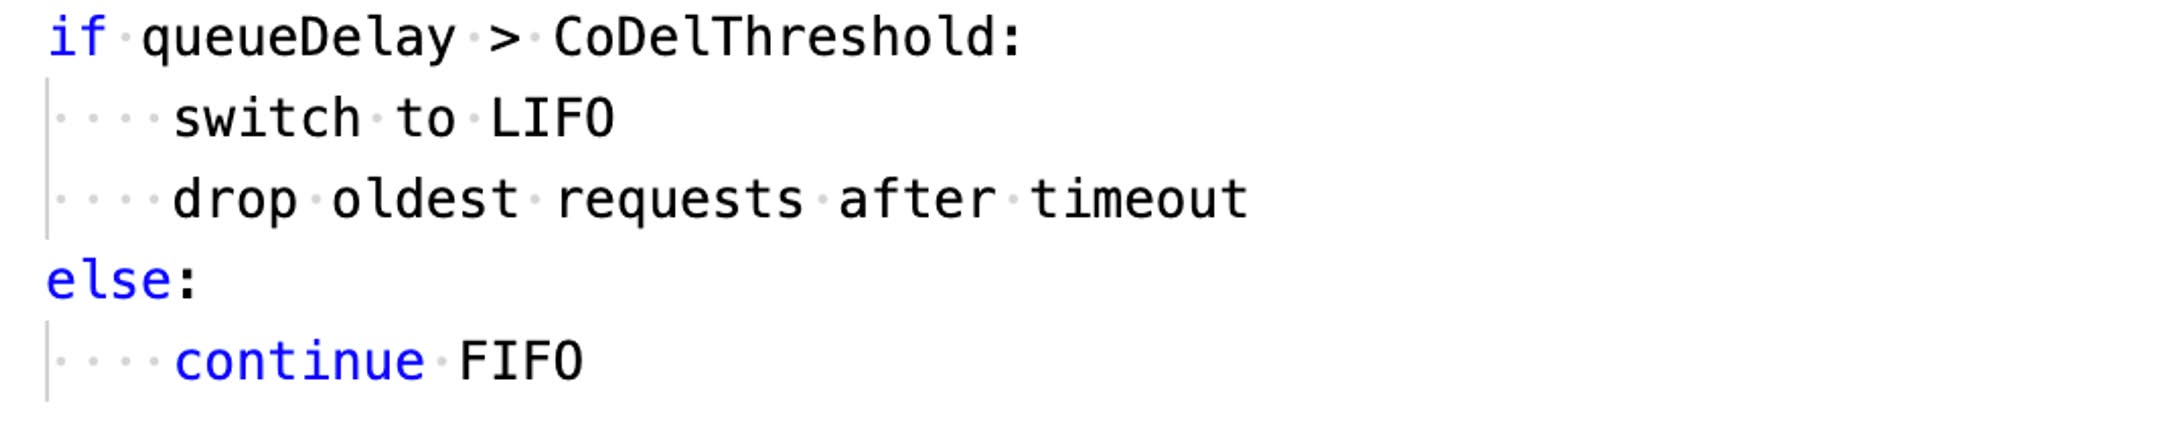
При нормальной нагрузке очередь работает как FIFO. Под давлением она переключается в режим LIFO, отдавая приоритет новым запросам, у которых ещё есть шанс на успех. Этот простой сдвиг повышает отзывчивость: устаревшие запросы быстро отклоняются, а свежие получают преимущество.
Движок Scorecard
Движок Scorecard (система показателей) — это компонент контроля допуска (admission control) на основе правил и лёгковесная система квот, предназначенная для применения ограничений конкурентности на уровне тенанта в мультитенантных средах. Пока сброс нагрузки защищает систему при перегрузке, Scorecard гарантирует, что ни один тенант не сможет монополизировать общую инфраструктуру даже в штатных условиях.
Конфигурация проста и детерминирована.
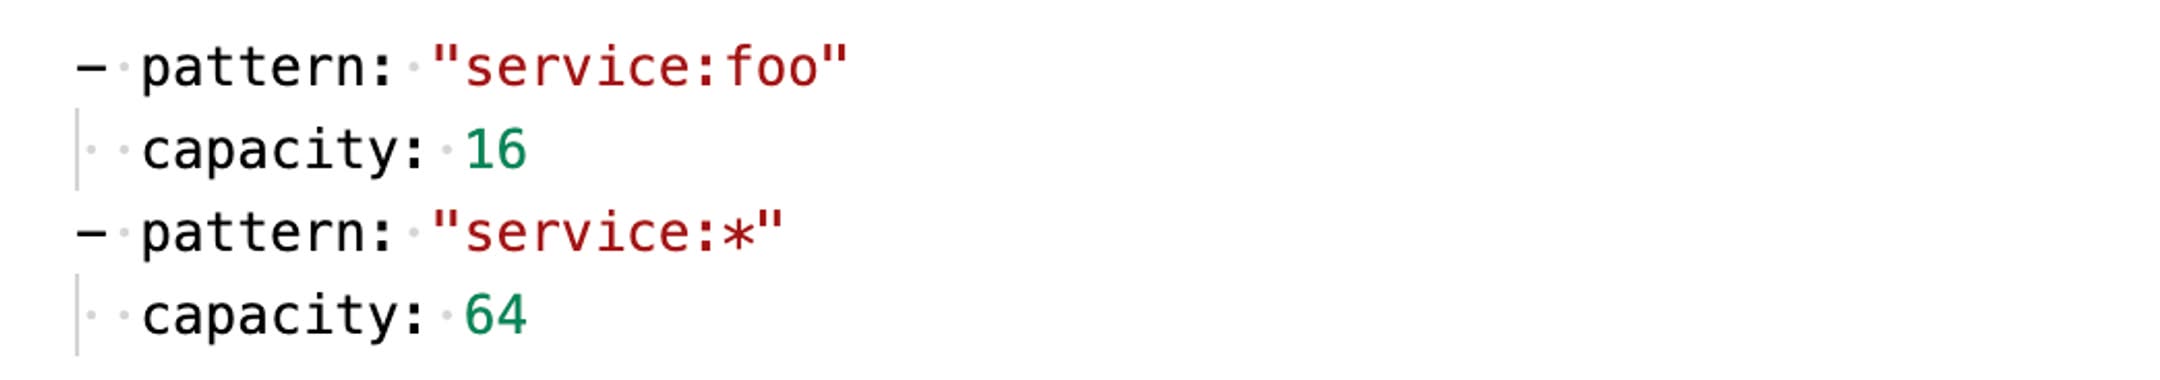
Главное преимущество Scorecard — сдерживание инцидентов. Во время аварий или всплесков трафика он помогает точно определить источник проблемы, изолирует и ограничивает некорректно ведущих себя тенантов, не затрагивая остальных, балансирует между стабильностью при нормальной нагрузке и жёсткими ограничениями под давлением, а также сокращает радиус поражения при перегрузках — быстро и предсказуемо.
Scorecard обеспечивает предсказуемую справедливость и контроль радиуса поражения, особенно когда несколько тенантов конкурируют за общие ресурсы.
Регуляторы
Scorecard защищает от чрезмерного использования конкурентности, однако не перекрывает все способы перегрузить stateful-систему баз данных. Некоторые виды перекосов проявляются тонко: они не выражаются в насыщении конкурентности, но при отсутствии контроля всё равно способны ухудшить производительность системы.
Например, клиент с низким QPS может перегрузить систему, отправляя большие полезные нагрузки на запись. Или трафик, сконцентрированный на одном ключе партиции, перегружает один кластер, пока остальные простаивают.
Для защиты от таких перекосов мы ввели подключаемые регуляторы (plug-in regulators) — локальные для узла детекторы перегрузки, которые соблюдают инварианты, нарушать которые система не должна. В нормальных условиях они срабатывают редко — так и задумано. Но когда пользователи случайно создают горячие точки или запускают массовую загрузку данных, регуляторы включаются и предотвращают каскадные сбои.
Мы используем следующие регуляторы:
-
Регулятор байт записи (Write bytes regulator): ограничивает одновременный объём записи, предотвращая насыщение I/O
-
Регулятор ключей партиции (Partition key regulator): замедляет трафик, нацеленный на горячие ключи партиций
-
Регулятор памяти (Memory regulator): отслеживает свободную память процесса и снижает нагрузку при её нехватке
-
Регулятор горутин (Goroutines regulator): отслеживает общее число горутин и снижает нагрузку при превышении порога
Что работало хорошо
Сбрасывая избыточные запросы, наши очереди CoDel предотвращали бесконтрольное исчерпание ресурсов, что привело к повышению стабильности и росту доли успешных принятых запросов. Этот подход особенно хорошо зарекомендовал себя в поддержании доступности базового функционала системы во время перегрузок.
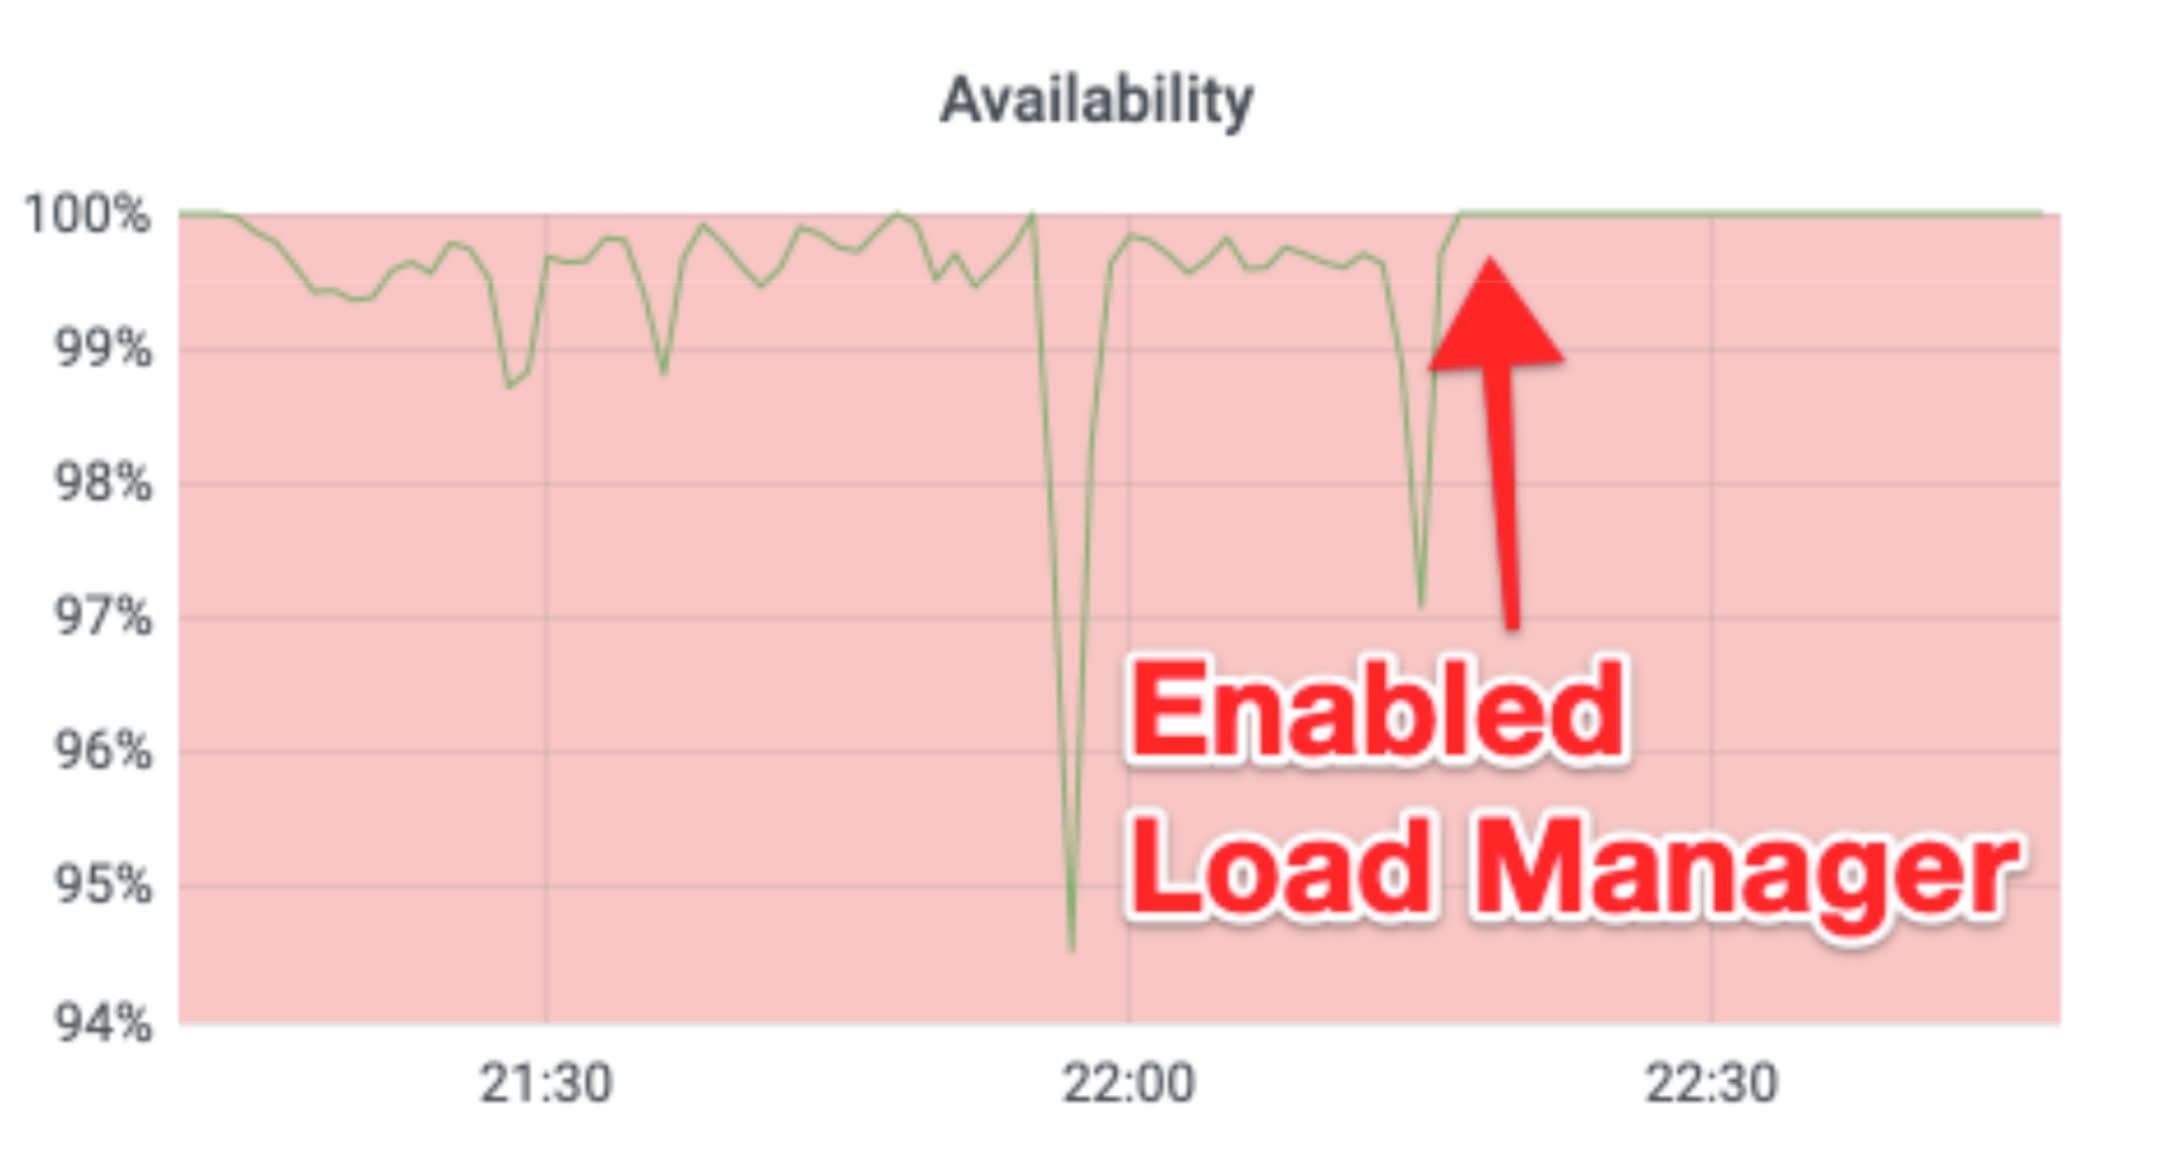
Движок Scorecard успешно изолировал некорректно ведущих себя тенантов, применяя ограничения конкурентности на уровне каждого из них. Это позволяло быстро сдерживать нарушителей спокойствия, не затрагивая других пользователей, и обеспечивать справедливое использование общих ресурсов.
Ограничения
Несмотря на то что первоначальная конфигурация заложила основу для защиты от перегрузок и обеспечения справедливости, у неё было несколько недостатков. Во-первых, CoDel обращался со всеми запросами одинаково, отбрасывая как низкоприоритетный трафик, так и пользовательские запросы — что ухудшало клиентский опыт и повышало дежурную нагрузку.
CoDel также полагался на фиксированные таймауты очереди и статические ограничения на количество одновременных запросов (inflight concurrency limits), что являлось низкоточным решением для динамической системы и требовало частой ручной настройки, порождая операционные накладные расходы.
Фиксированное время ожидания в CoDel приводило к проблеме «стада громовых коней» (thundering herd). Когда запросы в итоге отклонялись, все они повторялись одновременно, запуская повторяющиеся циклы перегрузки и отказов. В эти периоды отсутствие дифференциации трафика означало, что даже высокоприоритетные запросы отбрасывались, что вело к видимым пользователям ошибкам и усиливало радиус поражения.
В итоге такой подход не давал системе сломаться, однако ей не хватало тонкости и динамизма, необходимых для высококачественного пользовательского опыта. Это подчеркнуло необходимость в динамических и приоритетно-осведомлённых очередях.
Эволюция архитектуры
Cinnamon приходит на смену CoDel
Мы заметили, что многие перегрузки возникали из-за низкоприоритетных асинхронных задач: пайплайнов, агрегаторов и внутренних процессов сборки мусора. Такие задачи не должны иметь тот же приоритет выживаемости, что и запросы на поездки или запросы ценообразования в реальном времени.
Чтобы решить эту проблему, мы заменили CoDel на Cinnamon — приоритетно-осведомлённый сбрасыватель нагрузки (priority-aware load shedder), разработанный командой Delivery в Uber. Cinnamon принимает более взвешенные решения о сбросе, учитывая ранг запроса, динамическое состояние системы и относительную важность рабочих нагрузок.
Ранг запроса определяется на основе приоритета, прикреплённого к нему; если явный приоритет отсутствует, Cinnamon назначает значение по умолчанию исходя из вызывающего сервиса. Приоритет определяется по многоуровневой модели от tier 0 (t0) для наиболее критичного трафика до tier 5 (t5) для наименее важного. Уровень t0 зарезервирован для небольшого подмножества критически важных инфраструктурных сервисов, тогда как t1 представляет наиболее важный пользовательский онлайн-трафик — основные рабочие нагрузки, которые мы стремимся защитить при перегрузках. Эта система позволяет Cinnamon сначала сбрасывать низкоприоритетный трафик при перегрузке.
С введением осведомлённости о приоритетах запросов мы упростили структуру очередей до двух: очереди чтения и очереди записи. Длительные и фоновые операции вместо отдельной очереди стали помечаться более низким приоритетом.
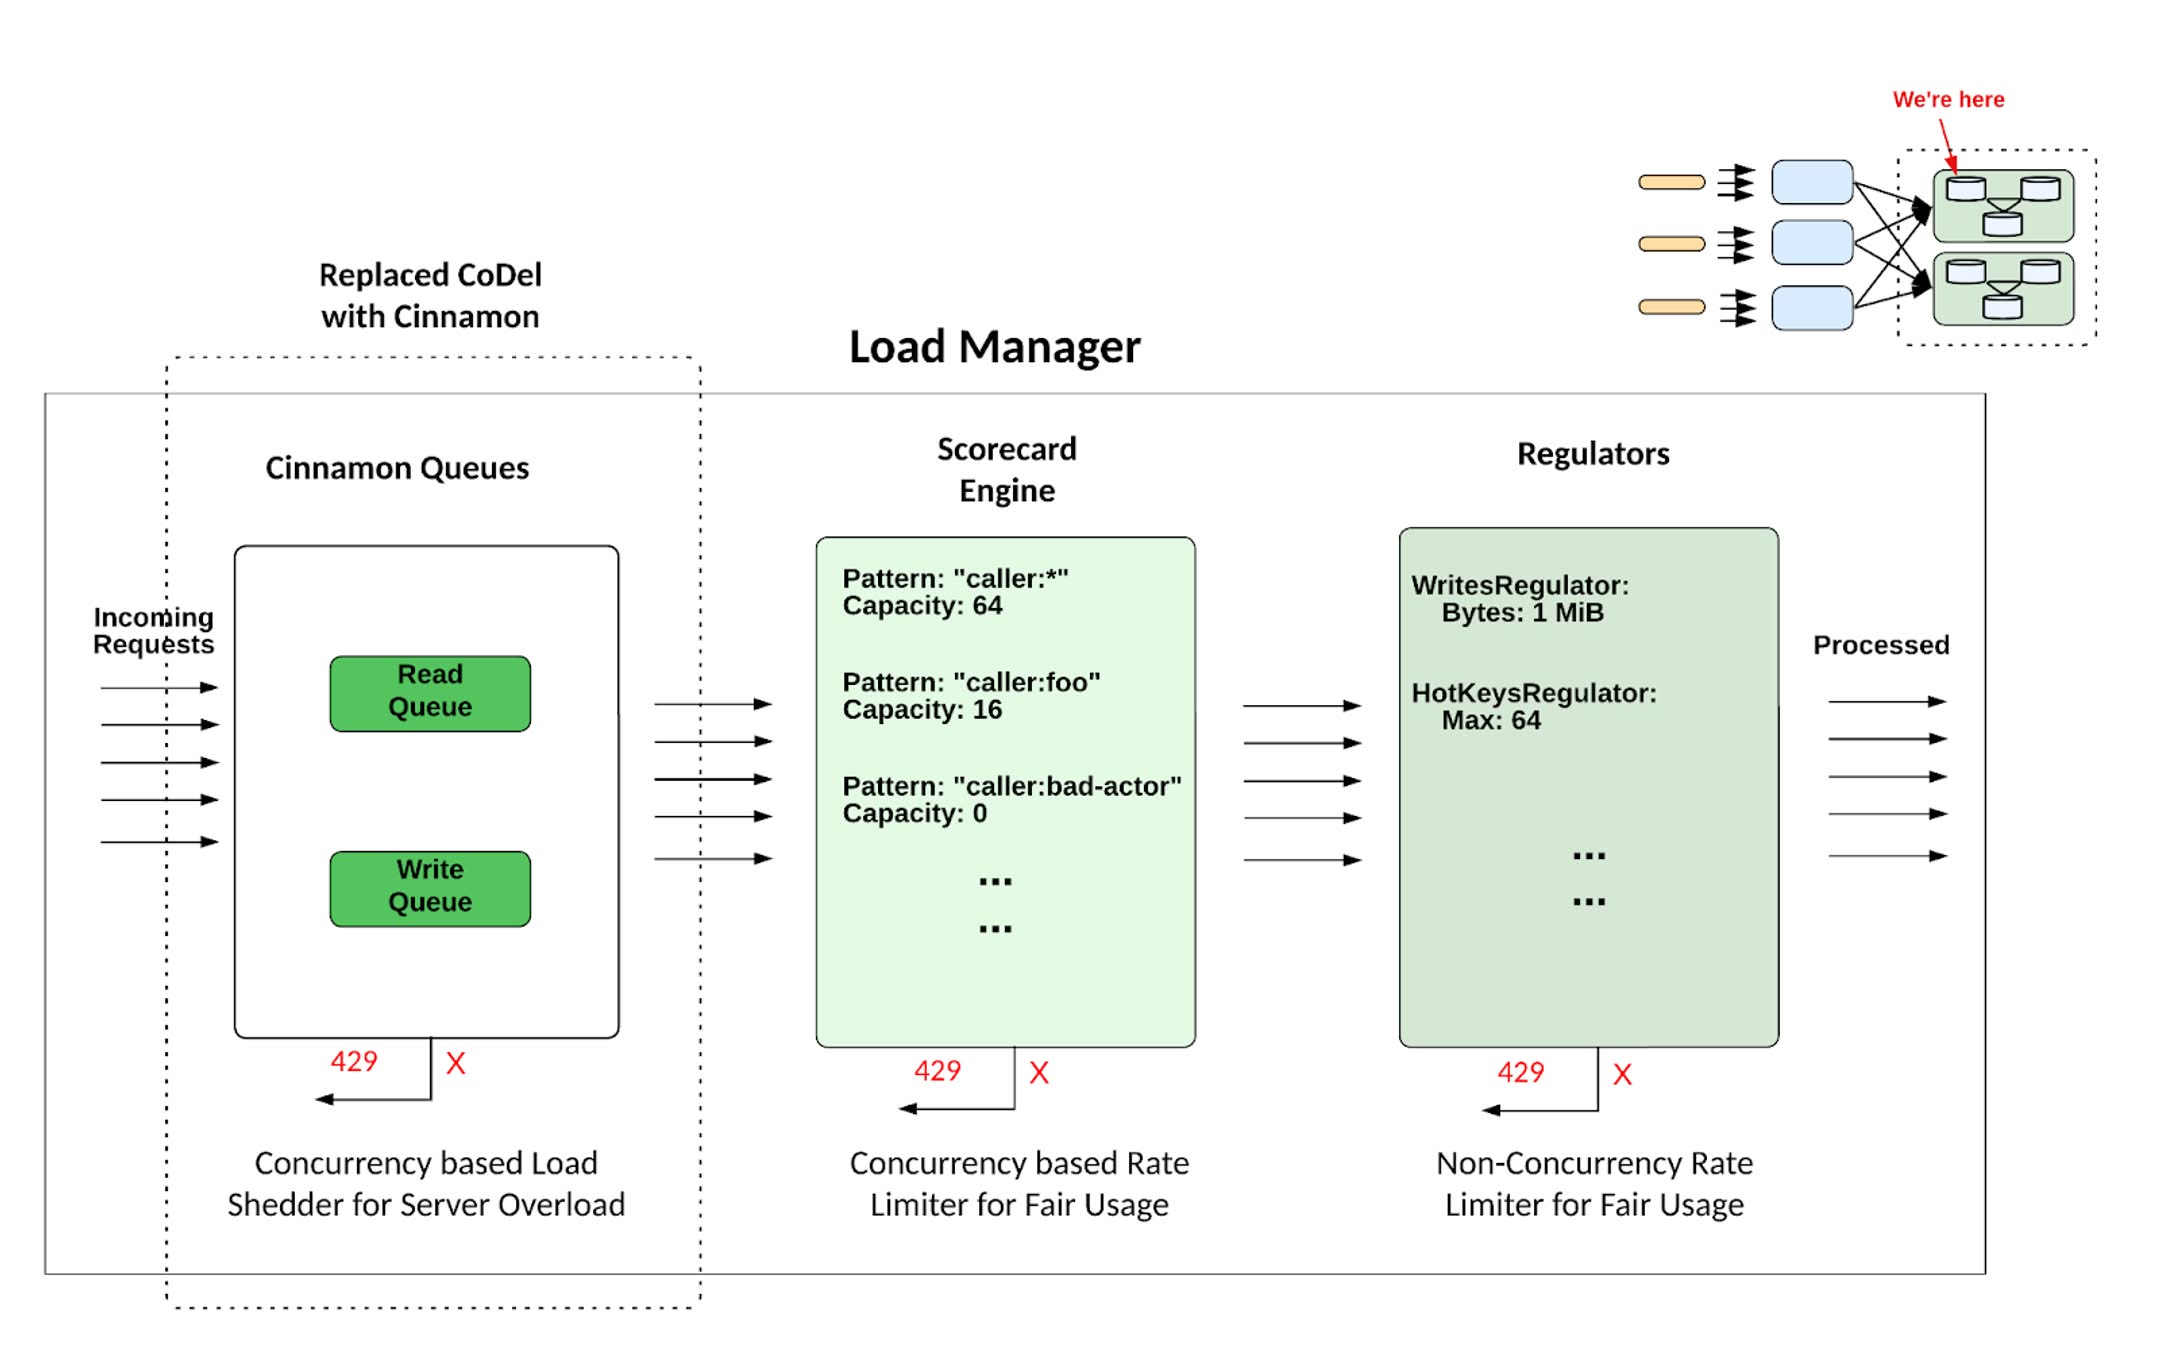
До Cinnamon сбрасыватель нагрузки на основе очереди CoDel не учитывал приоритеты, и сброс при перегрузке был произвольным.
После Cinnamon сбрасыватель нагрузки на основе очереди стал приоритетно-осведомлённым, и сброс при перегрузке происходит в порядке приоритета.
Выигрыш в производительности и стабильности
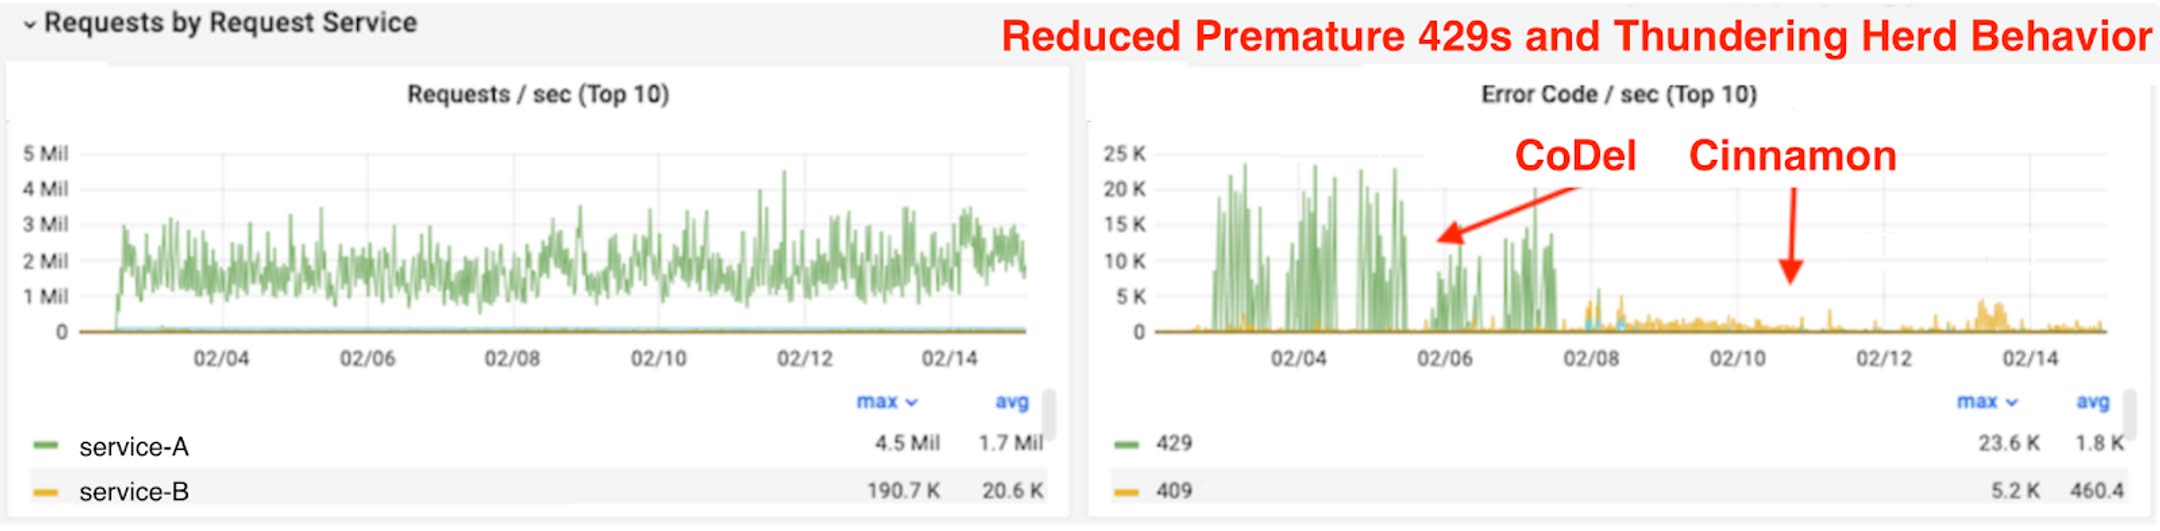
Дизайн на основе Cinnamon принёс ощутимые улучшения производительности и стабильности. Запросы ранжируются, что позволяет Cinnamon сначала сбрасывать низкоприоритетный трафик, защищая пользовательские потоки. Во время перегрузок критически важные пользовательские запросы лучше защищены и испытывают минимальное воздействие.
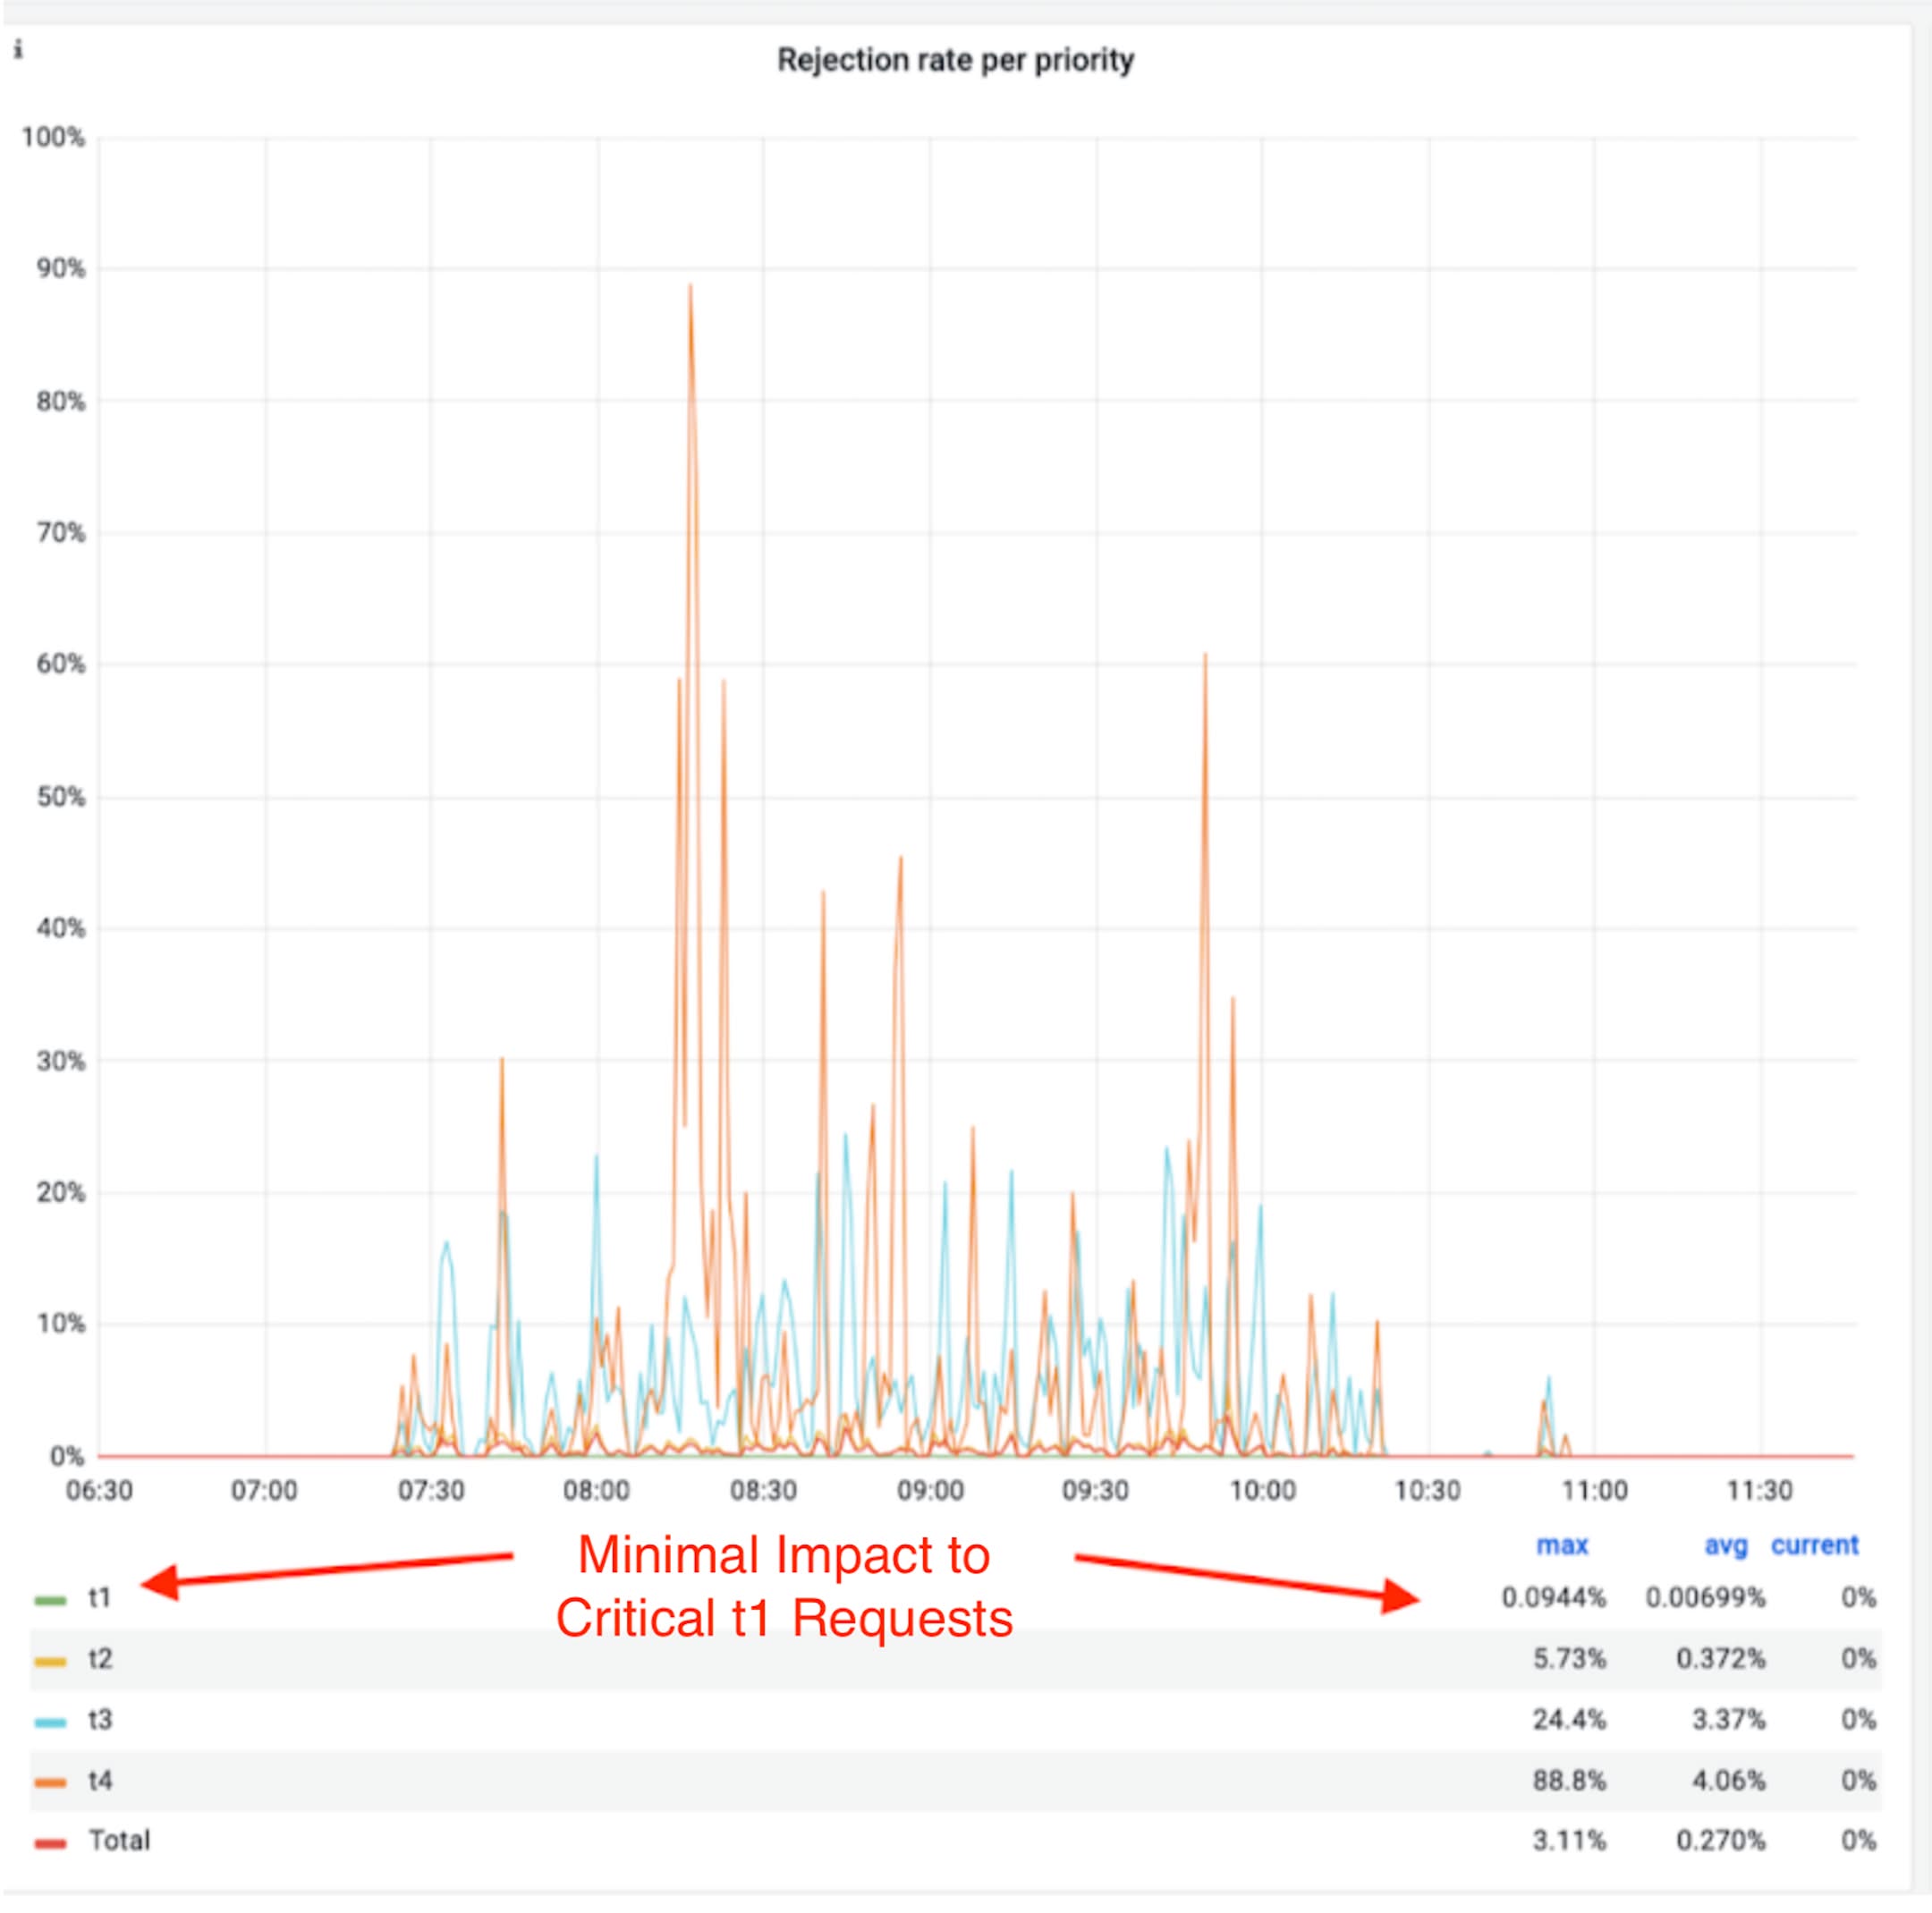
Cinnamon также адаптирует пороговые значения таймаутов очереди с использованием метрик задержки P90, устраняя необходимость в ручной настройке. Кроме того, его Auto Tuner динамически регулирует ограничения на одновременные запросы (inflight limits) — представленные доступными слотами в синем прямоугольнике на рисунке 10 — для максимизации пропускной способности. Это достигается непрерывным мониторингом и реакцией на сигналы задержки и частоты ошибок в реальном времени, что обеспечивает стабильный и эффективный сброс нагрузки.
В отличие от статичного подхода CoDel, который агрессивно отклоняет все запросы после фиксированного времени ожидания (например, 5 миллисекунд), ПИД-регулятор (PID-based control) Cinnamon позволяет системе поглощать давление без избыточных реакций. Он динамически регулирует таймауты очереди и ограничения на одновременные запросы на основе актуальных сигналов задержки и ошибок, выполняя сброс только при необходимости. Это предотвращает целый класс преждевременных сбросов, которые иначе приводили бы к лишним отказам, повторным запросам и эффекту громового стада. Результат — более плавное восстановление, меньше ответов 429 и стабильная доступность без ущерба для здоровья системы.
Что ещё требовало улучшения
Несмотря на достижения Cinnamon, ряд ключевых задач оставался нерешённым, что указывало на необходимость создания единой платформы.
Менеджер нагрузки действовал исходя из локального состояния сервера, отслеживая такие сигналы, как конкурентность в обработке, байты записи или использование памяти. Однако в распределённых системах перегрузка не всегда имеет локальный характер. Узел-лидер может быть вынужден сбрасывать трафик из-за отставания фолловеров, даже если сам находится в здоровом состоянии. Мы называем это отставанием индекса коммита (commit index lag). Традиционно такие удалённые решения о сбросе обрабатывались внешними компонентами с ограничителями на основе алгоритма «ведро с жетонами» (token bucket). Их было легко строить, но при масштабировании они оказались неэффективными, провоцируя состояния «расщеплённого мозга» (split-brain) и глобально субоптимальные решения о сбросе.
Первоначальный дизайн отлично справлялся со сбросом на основе конкурентности, однако не был рассчитан на то, чтобы стать переиспользуемой платформой для будущих сигналов перегрузки, которые неизбежно возникали по мере роста системы.
Эти наблюдения привели нас к финальной эволюции: превращению Cinnamon из сбрасывателя только на основе конкурентности в по-настоящему универсальный движок управления перегрузкой. Консолидировав все сигналы в единый модульный цикл принятия решений, мы достигли целостного и последовательного управления перегрузкой.
Единый движок сброса нагрузки
Централизация решений о перегрузке
Мы расширили Cinnamon поддержкой подключаемых внешних сигналов, таких как отставание фолловеров по индексу коммита, что позволило системе принимать глобально обоснованные, приоритетно-осведомлённые решения о сбросе в рамках того же пути контроля допуска. Этот переход объединил локальную и удалённую логику перегрузки в единый управляющий цикл, устранив пробелы, ранее вызывавшие нестабильность.
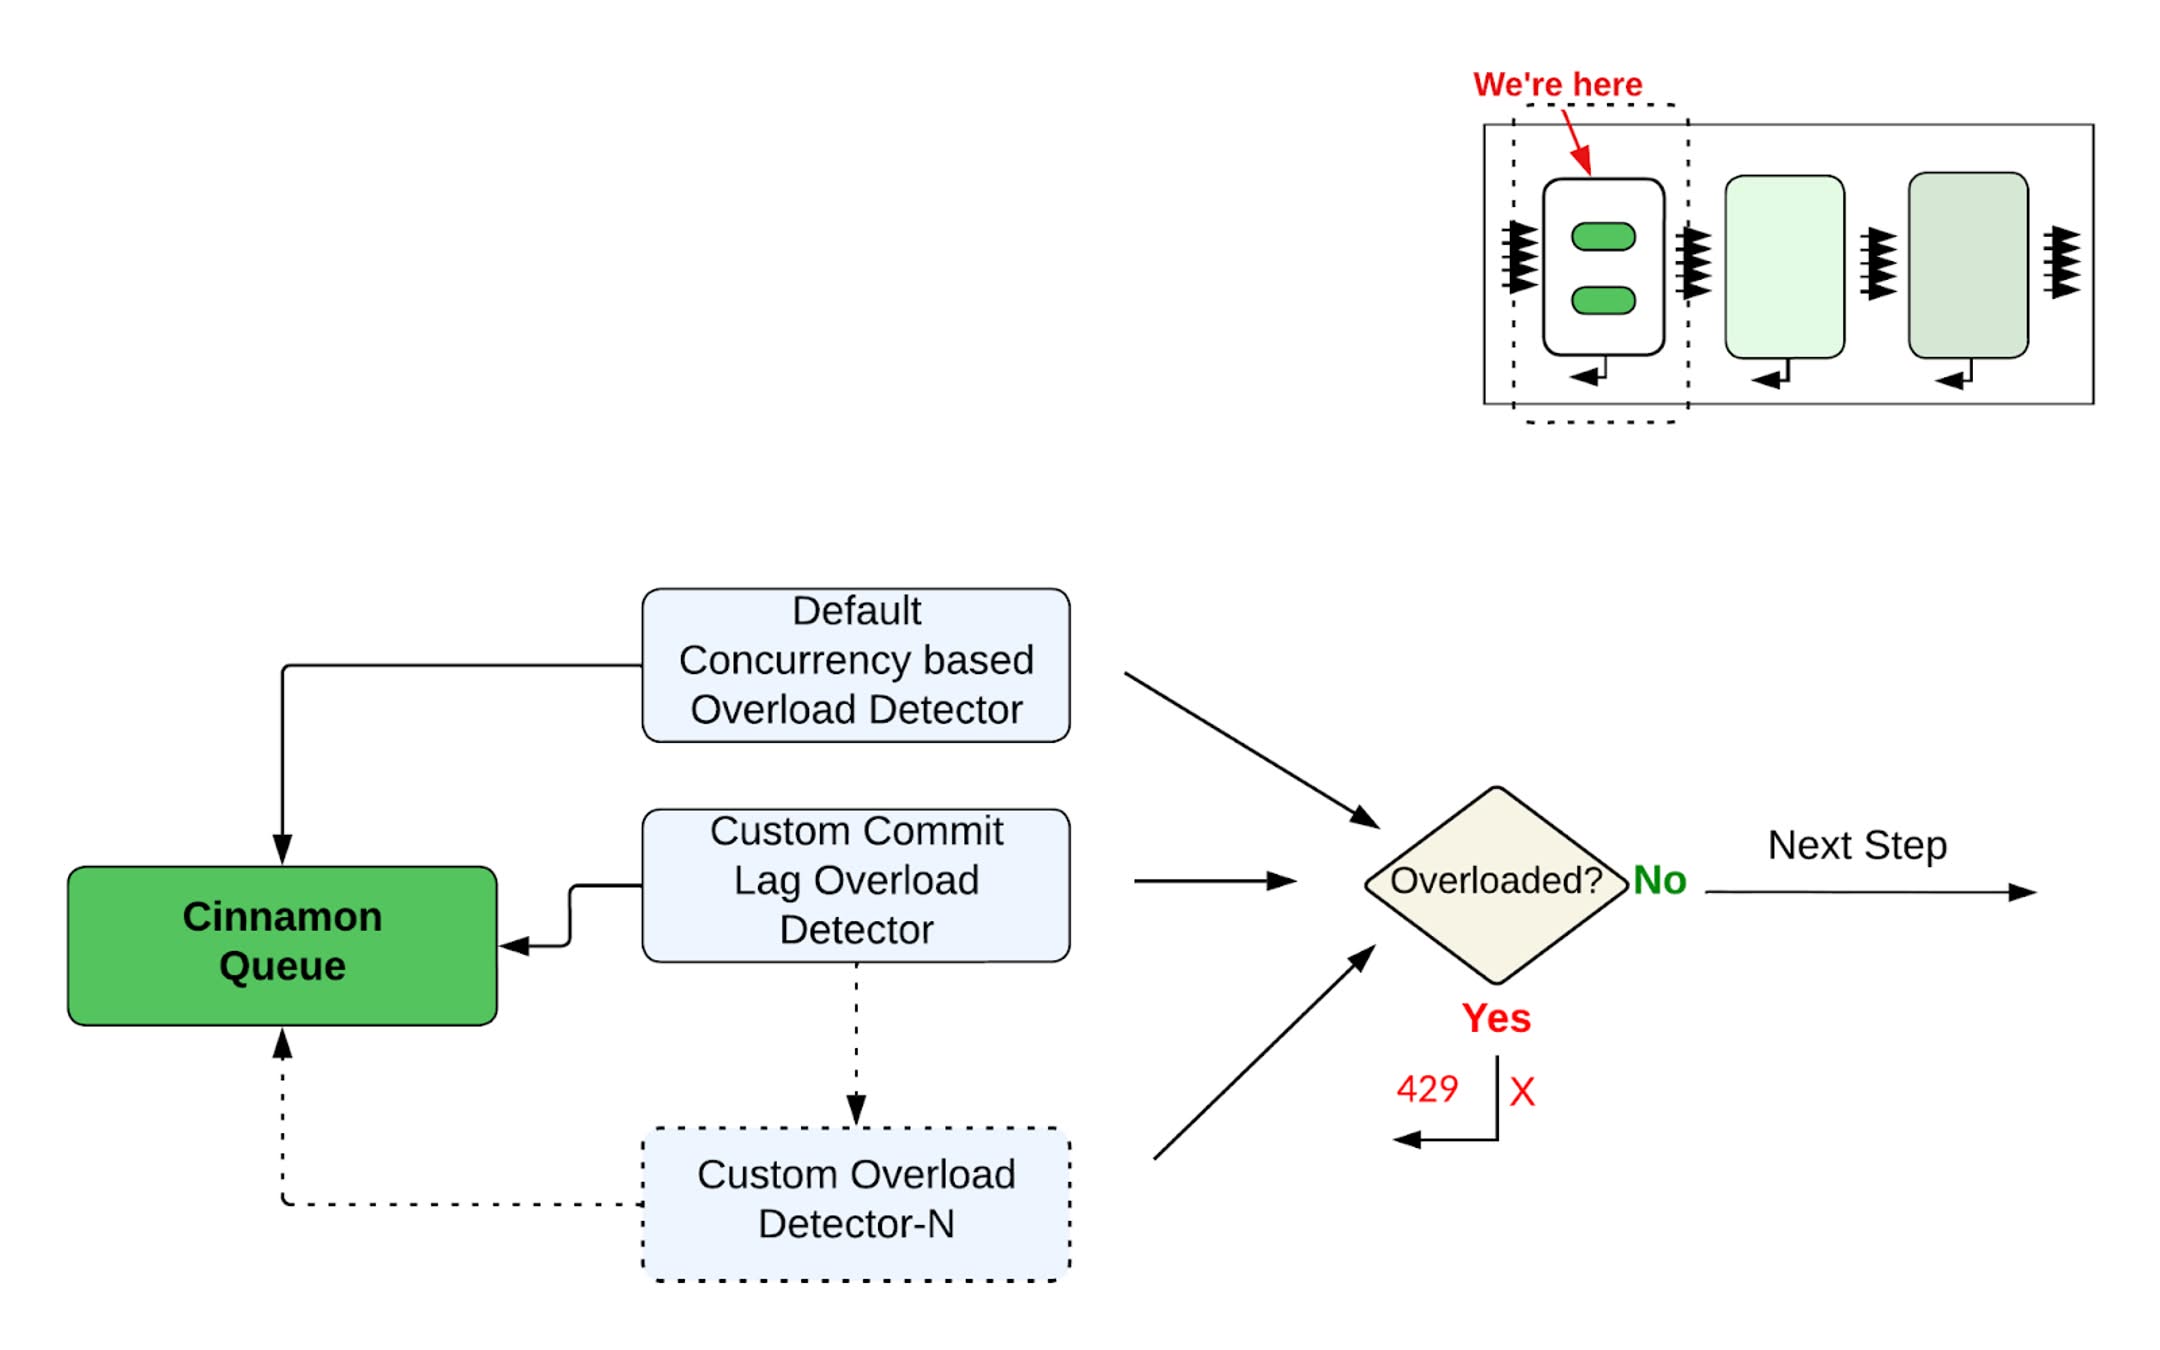
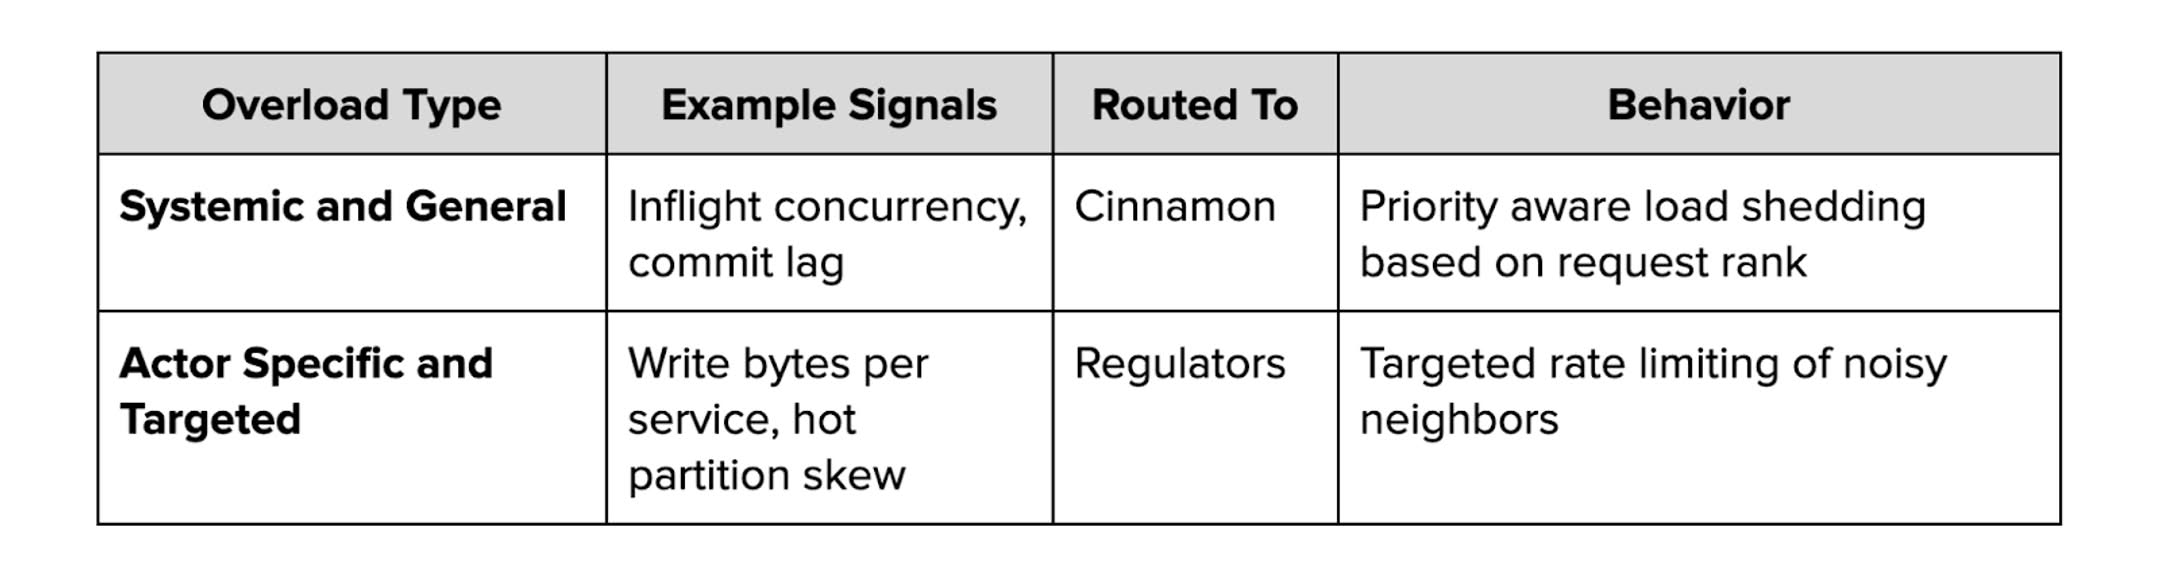
Однако сброс нагрузки не всегда подчиняется единому правилу — и именно здесь проявляется сила архитектуры менеджера нагрузки. Построенный на принципе BYOS (Bring Your Own Signal — «принеси свой сигнал»), он предоставляет подключаемый фреймворк, позволяющий команде встраивать новые сигналы перегрузки и направлять их в нужный управляющий путь. Независимо от того, имеет ли давление системный характер или связано с конкретным актором, менеджер нагрузки выполняет широкий сброс по приоритету или точечный — по вызывающей стороне, в зависимости от сигнала.
Результат: единое управление, упрощённый менеджмент нагрузки
Переход к централизованной, подключаемой архитектуре сделал систему более стабильной и предсказуемой, принеся вполне осязаемые результаты.
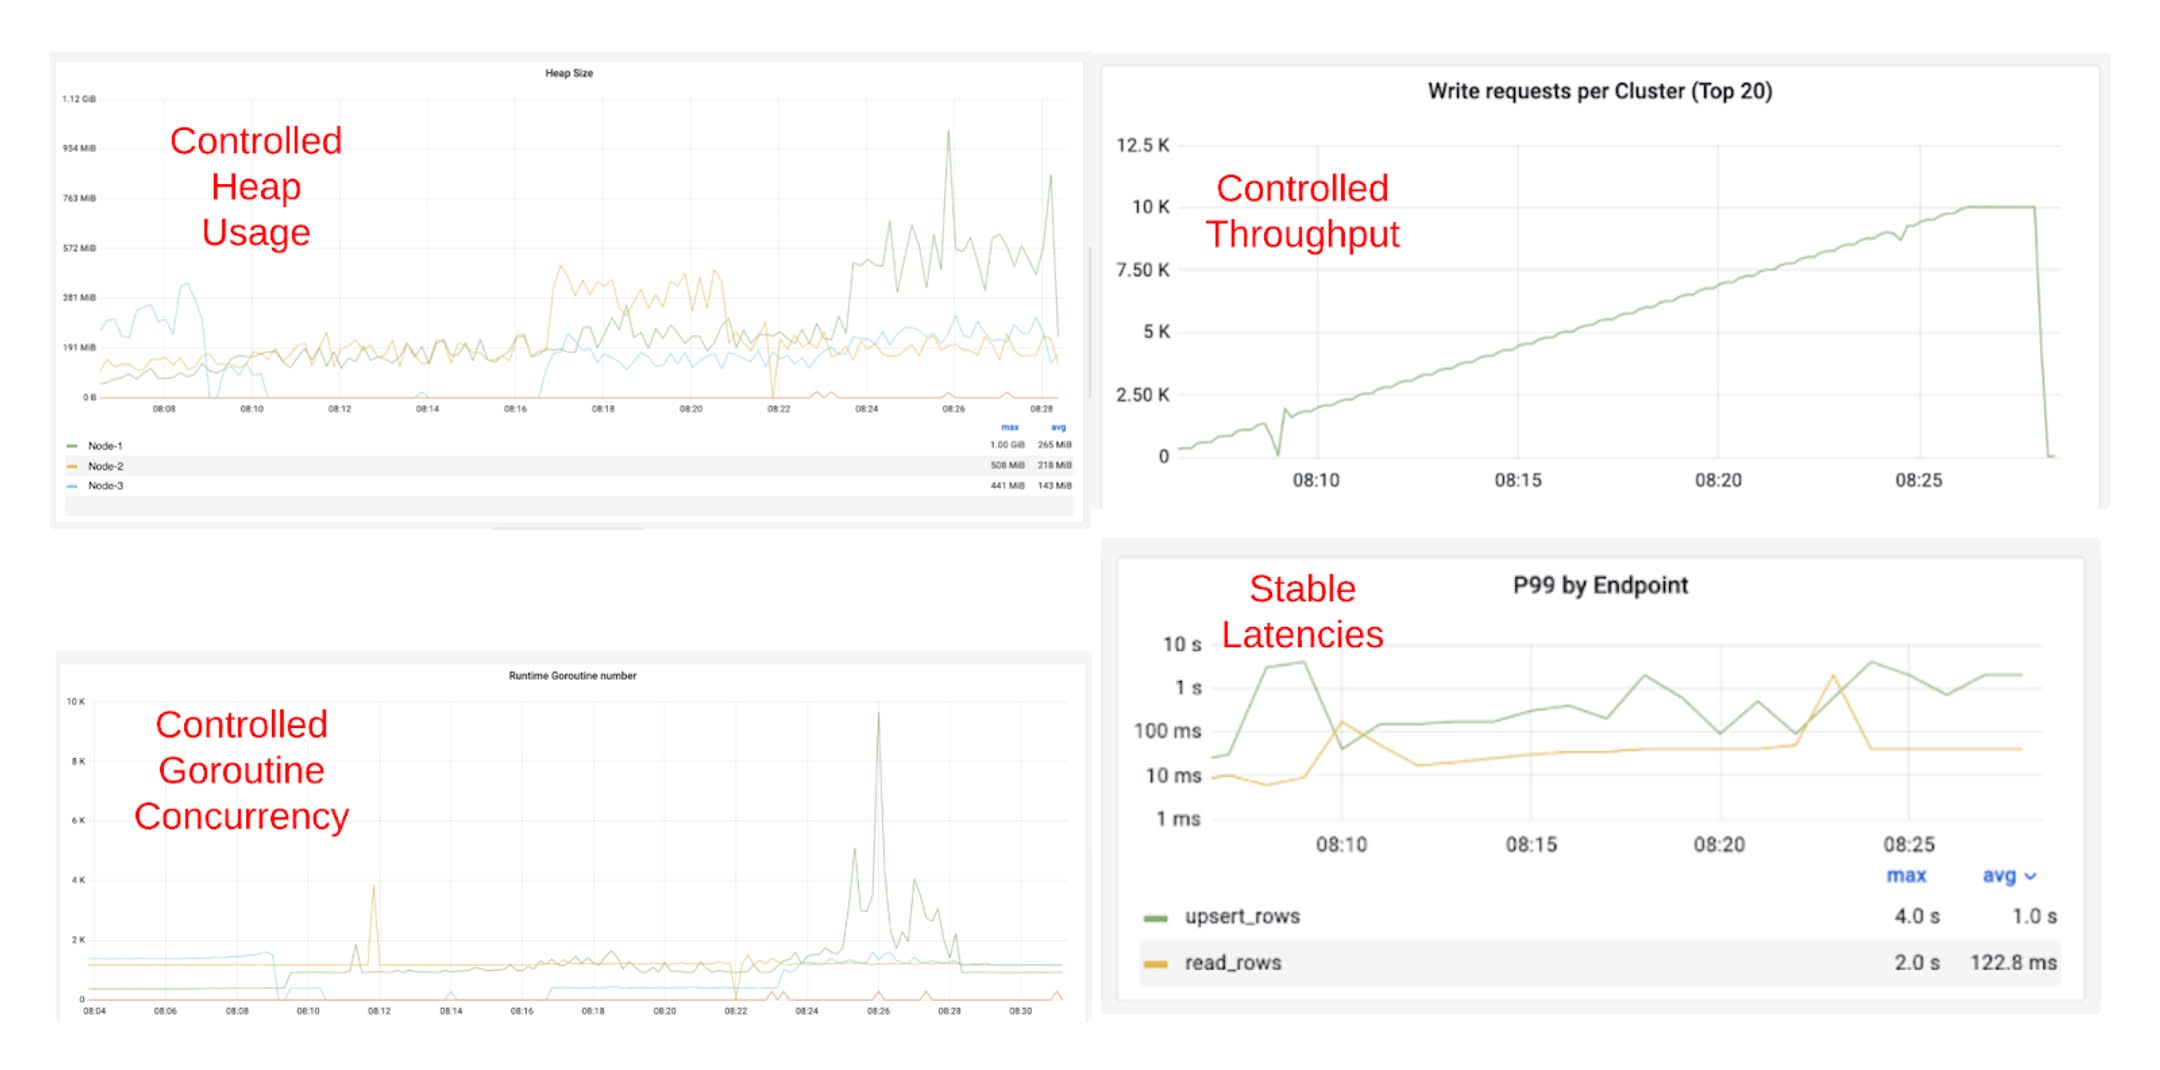
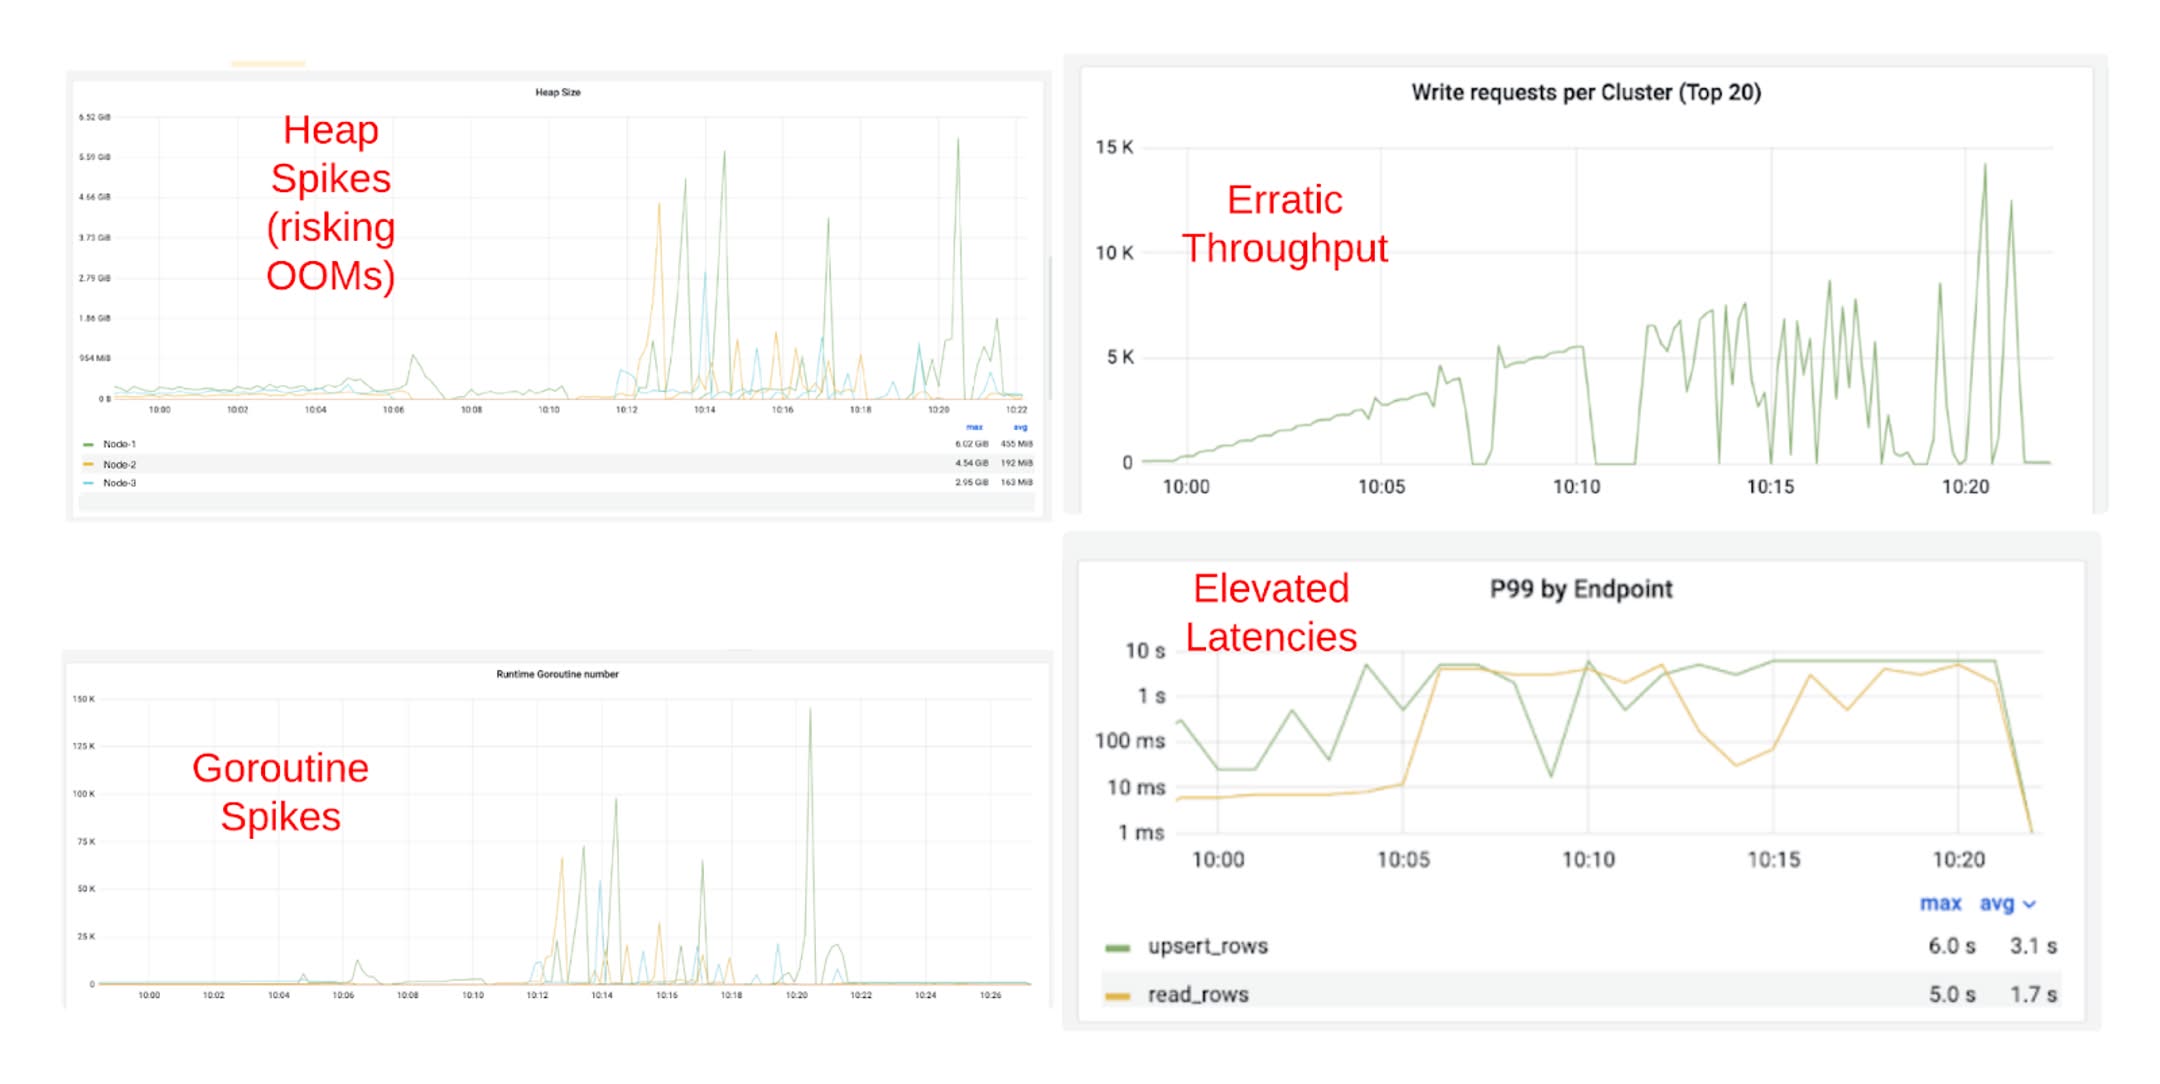
Cinnamon сбрасывает избыточные запросы немедленно с помощью ПИД-регулятора, избегая накопления памяти и горутин, которое вызывали ограничители на основе «ведра с жетонами». Это привело к снижению хвостовых задержек и более экономному использованию ресурсов даже под высокой нагрузкой. Мы наблюдали:
-
Рост пропускной способности под перегрузкой на 80% (среднее значение QPS 5 400 против 3 000)
-
Снижение задержки P99 примерно на 70% (среднее значение upsert 1,0 с против 3,1 с)
-
Примерно на 93% меньше горутин во время перегрузки (пиковое значение 10 000 против 150 000)
-
Примерно на 60% меньшее использование кучи (максимум 1 ГБ против пиковых 5–6 ГБ)
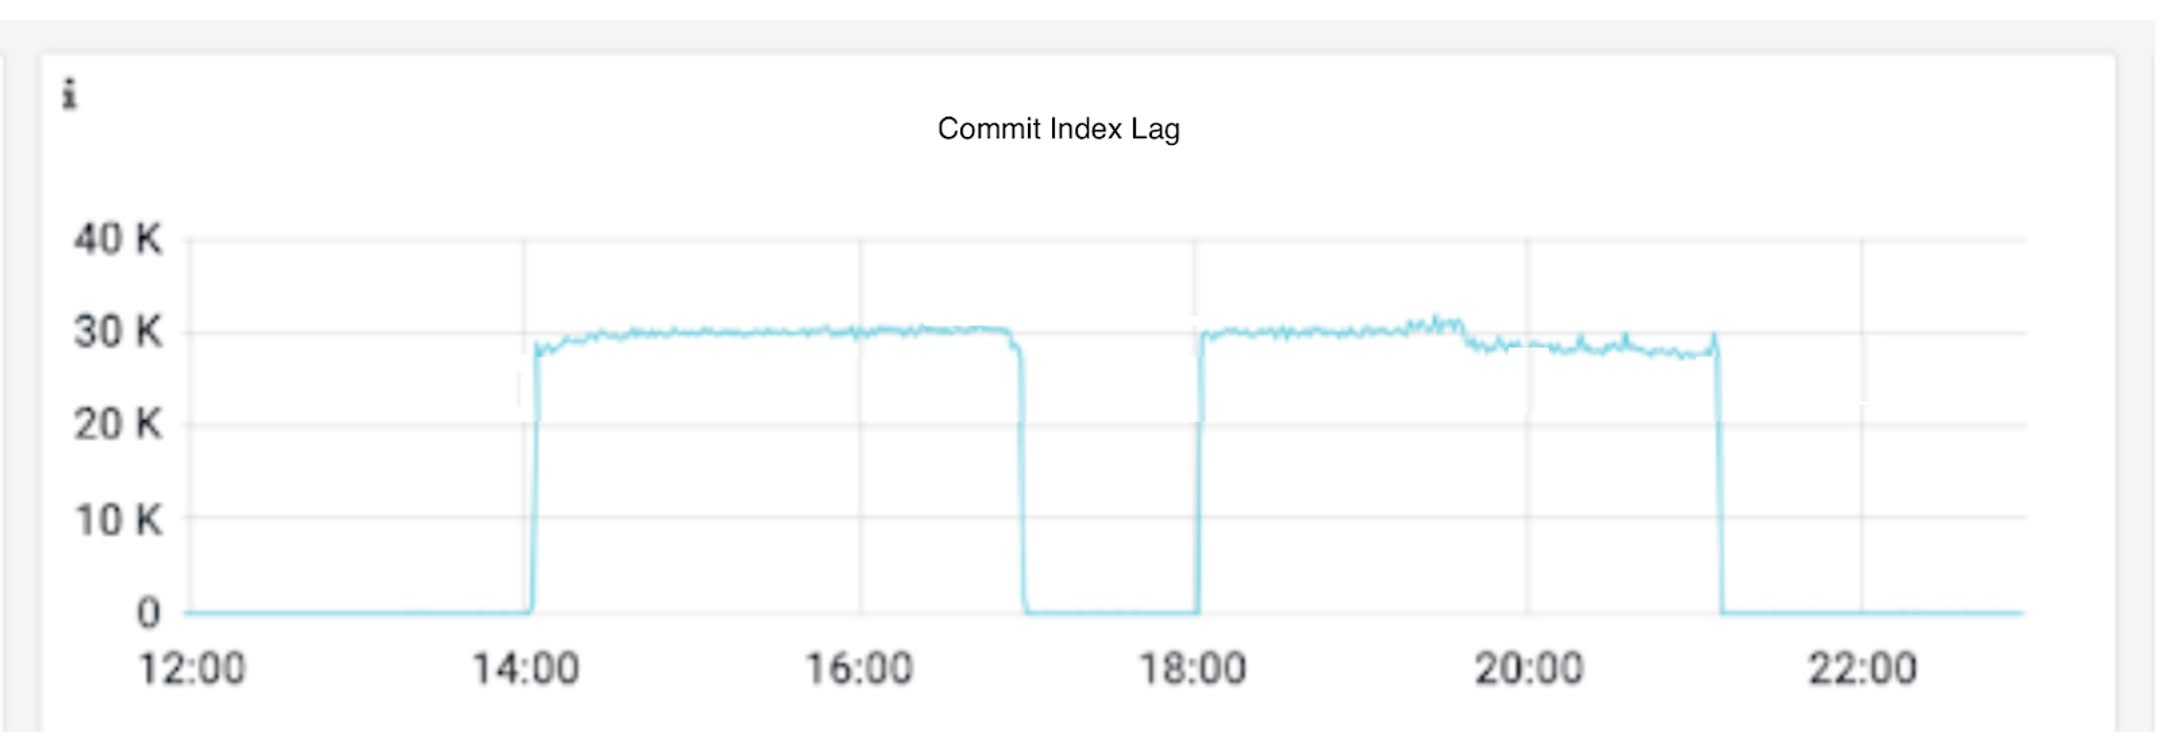
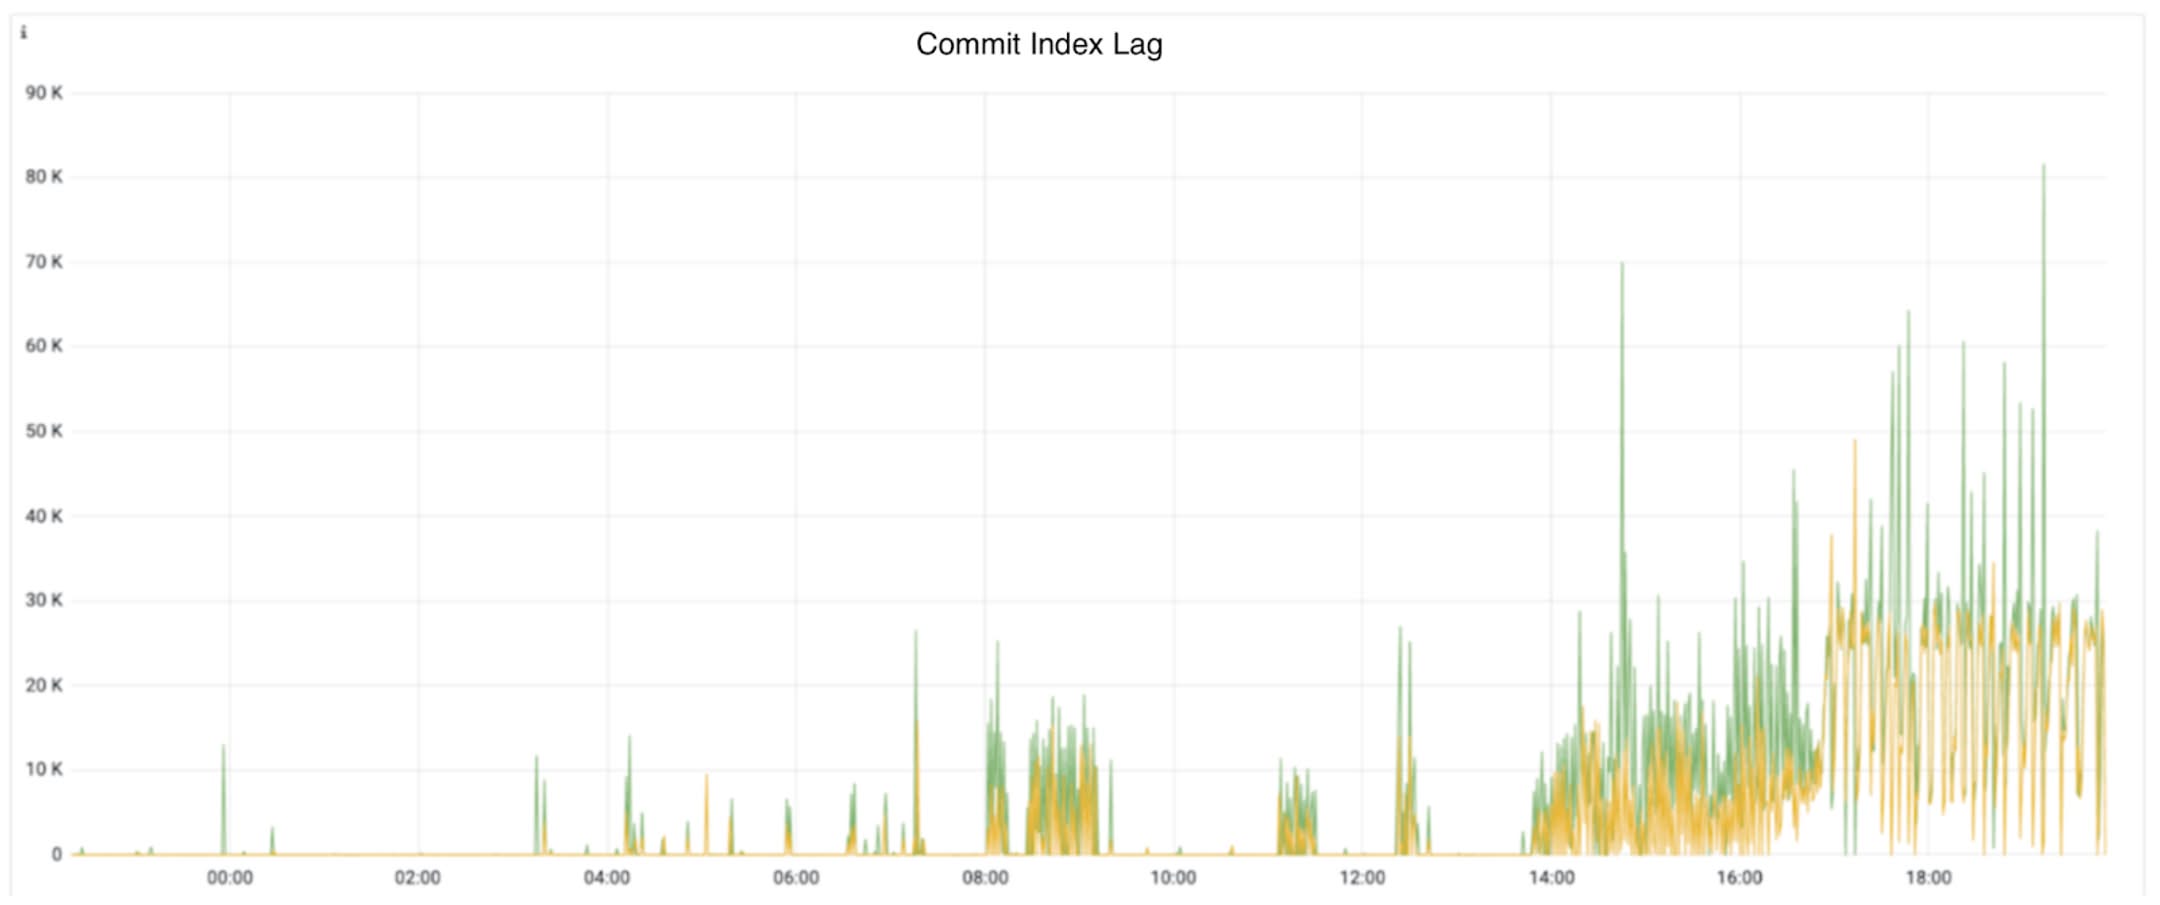
Мы также зафиксировали более плавное и предсказуемое поведение сброса нагрузки. Без ПИД-регулятора сброс работает как молоток: реактивно и резко. С ним — скорее как регулятор яркости: плавно и стабильно. Разница очевидна при сравнении того, как стабилизируется отставание индекса коммита при использовании ограничителя на основе «ведра с жетонами» в сравнении с ПИД-регулятором Cinnamon.
Извлечённые уроки
Приоритизация имеет первостепенное значение. Эффективный сброс нагрузки начинается с определения того, что важнее всего. В первую очередь защищайте критически важный пользовательский трафик. Всё остальное второстепенно.
Отказывайте быстро, не блокируйте. Раннее отклонение запросов почти всегда лучше, чем удержание их в памяти до истечения времени ожидания. Это сокращает бесполезно затраченные усилия, делает задержки предсказуемыми, предотвращает исчерпание памяти (OOM) и повышает устойчивость системы под давлением.
ПИД-регулирование для стабильного сброса. Простой реактивный сброс, основанный исключительно на текущей частоте ошибок, нередко вызывает нестабильность: поправки запаздывают и оказываются слишком резкими. ПИД-регулирование обеспечивает баланс, учитывая историю системы и направление изменений, что делает его ключевым инструментом для плавного, устойчивого и resilience-ориентированного управления перегрузкой.
Размещайте управление ближе к источнику истины. Лучшие решения о сбросе принимаются там, где живёт состояние. Защита должна быть на том уровне, который обладает полным контекстом — как правило, это уровень хранилища в stateful-системах.
Принимайте динамизм. Избегайте статических конфигураций везде, где возможно. Система должна быть достаточно интеллектуальной, чтобы адаптироваться к разным сценариям на основе контекста.
Инвестируйте в видимость и мониторинг. Хорошая наблюдаемость (observability) — фундамент для настройки и доверия. Отслеживайте, что сбрасывается, почему сбрасывается и как каждый компонент вносит вклад в давление на систему.
Простота важнее сложности. Это мета-принцип, которым руководствуются все остальные решения.
Заключение
Наш путь к устойчивому менеджеру нагрузки определялся уникальной сложностью крупномасштабной, stateful и распределённой среды. Объединив разрозненные компоненты в единый центр принятия решений и приняв модель «принеси свой сигнал» (Bring Your Own Signal), мы получили гибкость для точной работы как с системными перегрузками, так и с локальными проблемами шумных соседей. В результате мы имеем систему управления нагрузкой, которая сбрасывает трафик умнее — с учётом приоритетов, удерживает хвостовые задержки на низком уровне и кардинально снижает операционные накладные расходы.
Если вам интересны задачи в области распределённых систем, баз данных, систем хранения и кэшей — подайте заявку на открытые вакансии здесь.
Благодарности
Проект такого масштаба редко реализуется в одиночку. Искренняя благодарность Ричу Портеру, Еспер Нильсену, Пиюшу Пателю и инженерам из команд Storage и Delivery за их руководство и сотрудничество на всём протяжении этого пути. От разбора дизайн-решений до дежурных инсайтов — их вклад оказался незаменимым в построении устойчивой системы, которая теперь защищает критически важную инфраструктуру Uber.
Фото обложки: «Heavy Traffic Jam in Urban City Center» by Dapur Melodi
MySQL является зарегистрированным товарным знаком Oracle и/или её аффилированных лиц. Другие названия могут являться товарными знаками соответствующих владельцев.
Redis является товарным знаком Redis Labs Ltd. Все права на него принадлежат Redis Labs Ltd. Любое использование в данном тексте носит исключительно справочный характер и не подразумевает спонсорства, одобрения или аффилированности между Redis и Uber.