Мои эксперименты с MCP: за пределами «агентной обёртки»
«А можно сделать агента для этого?»
Как часто вы слышите этот вопрос в последнее время? Похоже, он стал стандартным ответом на любую операционную проблему.
Сейчас я работаю с клиентом над созданием системы автоматизации на базе агентов, призванной сократить ручной труд при выполнении еженедельных, ежемесячных и внеплановых операционных задач. Эти задачи следуют строго повторяемым шаблонам, но поглощают огромное количество инженерных часов — нередко в выходные и нерабочее время, чего клиент и хочет избежать.
Цель проекта — осторожно опробовать агентный ИИ, ничего не сломав, чтобы команда могла быстро учиться и рано обнаруживать ошибки. Нам хотелось заранее выявить практические подводные камни технологии и подготовиться к неизбежному в корпоративной среде: «Извините, это запрещено, разрешения нет», «Наша служба безопасности ещё не одобрила это» или «Как именно это нам помогает?»
Выбор сценария: поиск по логам
Чтобы не потерять управление, наиболее подходящим кандидатом для доказательства концепции (proof-of-concept) оказалась реализация поиска в Elasticsearch. Идея простая: дать команде Site Reliability Engineering (SRE) возможность искать по логам без необходимости вручную составлять сложный синтаксис запросов.
При проектировании решения существуют два принципиально разных подхода к архитектуре:
-
Подход 1: традиционный путь с пользовательским инструментарием. Создать агента с инструментами, написанными вручную: они принимают запрос на естественном языке, переводят его в конкретную полезную нагрузку и выполняют прямой вызов REST API к Elasticsearch, после чего отображают результаты.
-
Недостаток: такой подход не меняет ситуацию по существу. Он просто перепаковывает старое вино в новую бутылку, жёстко привязывая возможность к единственной, тесно связанной реализации агента.
-
Подход 2: путь через Model Context Protocol (MCP). Использовать MCP-сервер в роли стандартизированной обёртки. MCP-сервер берёт на себя всю тяжёлую работу по взаимодействию с Elasticsearch и предоставляет свои возможности в виде стандартизированных инструментов. Агенту остаётся лишь подключиться к MCP-серверу, а LLM динамически использует инструменты сервера для получения и возврата данных.
Что ж, давайте разберём это подробнее!
Архитектура агента
В качестве основного фреймворка агента — отчасти из-за моего опыта работы с Google Cloud — я выбрал Agent Development Kit (ADK) от Google (google-adk).
Для интеллектуальных рассуждений и разбора намерений (intent parsing) агент подключён к gemini-2.5-flash, размещённому в Vertex AI. Такая конфигурация требует наличия проекта GCP в роли контейнера серверных ресурсов, но при этом порождает первое настоящее операционное решение: аутентификация.
Есть два основных способа разрешить внешнему или локальному агенту общаться с API Google Cloud:
-
API-ключи: генерируются быстро, но в корпоративной среде их крайне сложно надёжно контролировать. Высок риск утечки или хранения в коде в открытом виде.
-
Google Cloud Application Default Credentials (ADC): отраслевой стандарт для локальной разработки с прозрачным распространением IAM-прав.
Ради соответствия требованиям безопасности и операционной простоты я выбрал gcloud ADC. Одна быстрая команда входа в терминале автоматически настраивает локальное окружение на безопасную аутентификацию без управления статическими учётными данными и без риска раскрыть секретные ключи в коде:
gcloud auth application-default loginПосле того как фреймворк агента настроен и безопасный канал аутентификации создан, следующим шагом стало выяснение того, как бесшовно подключить этот бэкенд к Elasticsearch.
Настройка MCP-сервера и подключение к Elasticsearch
При подключении агента к Elasticsearch через Model Context Protocol (протокол контекста модели) можно выбрать один из нескольких архитектурных путей:
-
Создать собственный MCP-сервер: написать специализированную обёртку с нуля, которая работает с REST API Elasticsearch и преобразует входные и выходные данные в соответствии со спецификацией MCP.
-
Развернуть официальный MCP-сервер Elasticsearch: использовать официальный самодостаточный MCP-сервер от Elastic. Его можно развернуть в централизованной среде в архитектуре клиент — сервер для совместного использования несколькими агентами.
Я твёрдо отдал предпочтение второму варианту. Использование проверенной официальной реализации MCP куда ценнее, чем изобретение велосипеда. Чтобы соответствовать корпоративным стандартам и обеспечить надёжность, я развернул официальный MCP-сервер Elastic непосредственно в кластере Kubernetes.
Запуск MCP-сервера как централизованного сервиса в Kubernetes полностью абстрагирует лежащий в основе Elasticsearch API. Агенту не нужно знать, как разговаривать с Elasticsearch — ему нужно знать только, как разговаривать с MCP-сервером.
Развёртывание MCP-сервера в Kubernetes
Для безопасного подключения официального MCP-сервера Elasticsearch к кластеру необходимо правильно организовать аутентификацию. Вместо использования root-учётных данных мы создадим выделенный API-ключ Elasticsearch с минимальными привилегиями (least-privilege), заточенными именно под поиск по логам.
Шаг 1: создание API-ключа Elasticsearch
Выполните следующий запрос через консоль Dev Tools в Kibana или через curl, чтобы создать API-ключ с ограниченными привилегиями мониторинга и чтения индекса:
POST /_security/api_key
{
  "name": "mcp-agent-key",
  "role_descriptors": {
    "mcp_reader_role": {
      "cluster": ["monitor"],
      "index": [
        {
          "names": ["*"],
          "privileges": ["read", "view_index_metadata"]
        }
      ]
    }
  }
}
Команда возвращает JSON-ответ с созданными учётными данными.
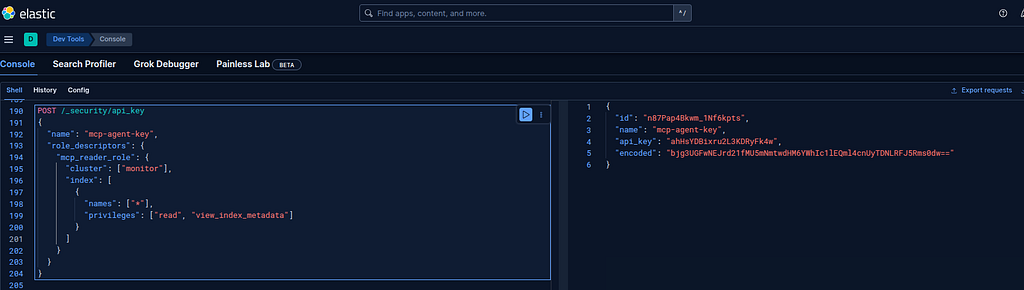
Нас интересует конкретно поле encoded, которое содержит строку токена, используемую MCP-сервером для аутентификации:
{
  "id": "n87Pap4Bkwm_1Nf6kpts",
  "name": "mcp-agent-key",
  "api_key": "ahHsYDBixru2L3KDRyFk4w",
  "encoded": "bjg3UGFwNEJrd21fMU5mNmtwdHM6YWhIc1lEQml4cnUyTDNLRFJ5Rms0dw=="
}
Шаг 2: создание манифеста Kubernetes
Далее создадим единый манифест Kubernetes, включающий:
-
Secret — для безопасного хранения закодированного API-ключа Elasticsearch.
-
Deployment — с использованием официального образа Elastic MCP-сервера, включая локальное DNS-сопоставление (
hostAliases) для эндпойнта Elasticsearch и маппинг переменных окружения. -
Service — с доступом через LoadBalancer, чтобы наш фреймворк агента
google-adkмог обращаться к серверу.
apiVersion: v1
kind: Secret
metadata:
  name: elastic-mcp-creds
  namespace: default
type: Opaque
stringData:
  # Клиент Elastic нативно ожидает значение поля 'encoded' в качестве API-ключа
  elastic-api-key: "bjg3UGFwNEJrd21fMU5mNmtwdHM6YWhIc1lEQml4cnUyTDNLRFJ5Rms0dw=="
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: elastic-mcp-server
  namespace: default
  labels:
    app: elastic-mcp
spec:
  replicas: 1
  selector:
    matchLabels:
      app: elastic-mcp
  template:
    metadata:
      labels:
        app: elastic-mcp
    spec:
      hostAliases:
      - ip: "192.168.1.170"
        hostnames:
        - "kumaster"
      containers:
      - name: mcp-server
        image: docker.elastic.co/mcp/elasticsearch:latest
        args: ["http"]
        ports:
        - containerPort: 8080
          name: http
        env:
        - name: ES_URL
          value: "https://kumaster:9200"
        - name: ES_API_KEY
          valueFrom:
            secretKeyRef:
              name: elastic-mcp-creds
              key: elastic-api-key
        - name: ES_SSL_SKIP_VERIFY
          value: "true"
---
apiVersion: v1
kind: Service
metadata:
  name: elastic-mcp-service
  namespace: default
spec:
  type: LoadBalancer
  ports:
  - port: 3000
    targetPort: 8080
    protocol: TCP
    name: http
  selector:
    app: elastic-mcp
Шаг 3: применение манифеста и проверка развёртывания
Примените манифест с помощью kubectl:
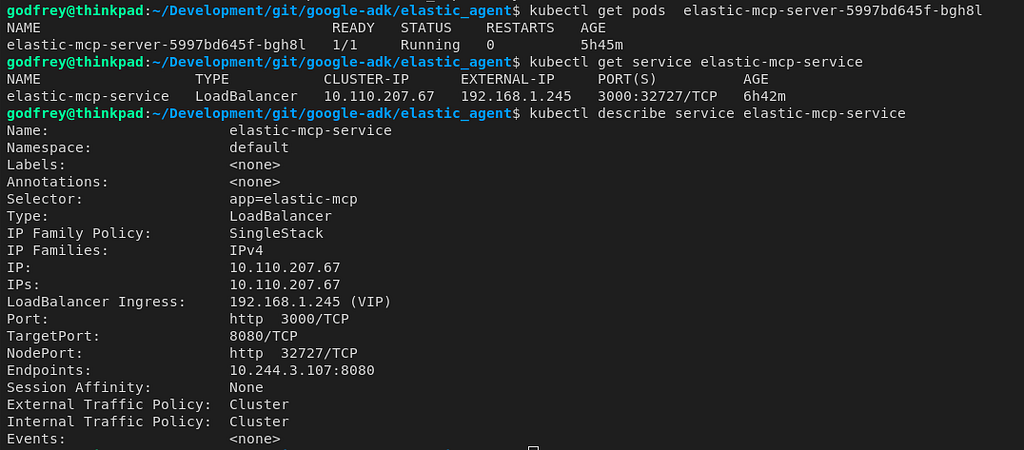
kubectl apply -f elastic-mcp.yamlУбедитесь, что под успешно запущен, и проверьте внешний IP-адрес или IP-адрес кластера, назначенный сервису elastic-mcp-service, чтобы убедиться в готовности обрабатывать входящие запросы от агента.
Финальный элемент пазла: подключение агента ADK
Теперь, когда MCP-сервер Elasticsearch работает в Kubernetes, остаётся лишь сообщить агенту google-adk, где его найти.
Вместо жёсткого встраивания хрупкого пользовательского клиента интеграции мы можем подключить агента напрямую к эндпойнту сервера. Поскольку официальный образ Elastic MCP работает как HTTP-сервер, фреймворк Google ADK подключается к нему по протоколу удалённого транспорта Server-Sent Events (SSE).
Вот насколько просто динамически передать возможности Elasticsearch в ваш фреймворк агента:
# Указываем на новый внешний IP MetalLB LoadBalancer (сервер ожидает маршрут /sse)
elastic_mcp_url = os.getenv("ELASTIC_MCP_URL", "http://192.168.1.245:3000/mcp")
При инициализации McpToolset автоматически обнаруживает доступные инструменты Elasticsearch, предоставленные вашим подом Kubernetes, преобразует их схемы в ADK-совместимые инструменты и передаёт их напрямую gemini-2.5-flash.
Когда команда SRE отправляет запрос на естественном языке — например, «Найди все ошибки 500 за последние 10 минут» — Gemini разбирает намерение, понимает, что у него есть подходящий инструмент, предоставленный MCP-сервером, и прозрачно проксирует запрос.
Ради краткости я не стал вставлять сюда весь код оркестрации агента, но полную рабочую кодовую базу — включая все сценарии рабочих процессов — можно найти в моём репозитории GitHub.
Запуск агента и проверка результатов
После завершения инфраструктурной части можно запустить интерфейс разработчика локально с помощью встроенного инструмента Google ADK CLI:
python -m google.adk.cli web .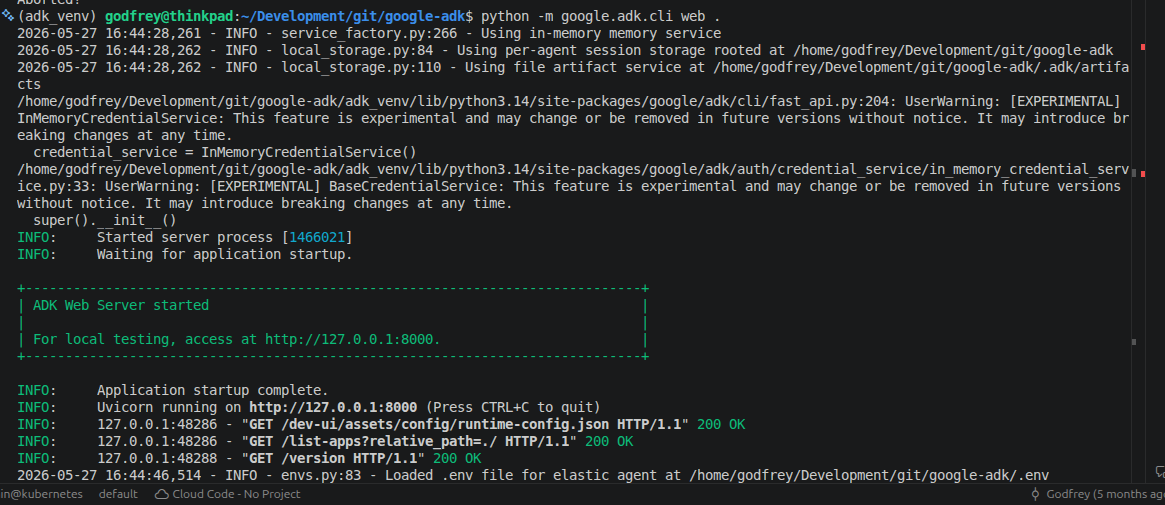
После инициализации сервера откройте браузер и перейдите в локальный интерфейс разработчика по адресу http://localhost:8000/dev-ui. В выпадающем меню на панели управления выберите только что созданный агент поиска по логам.
Сценарий выполнения: запрос исторических данных
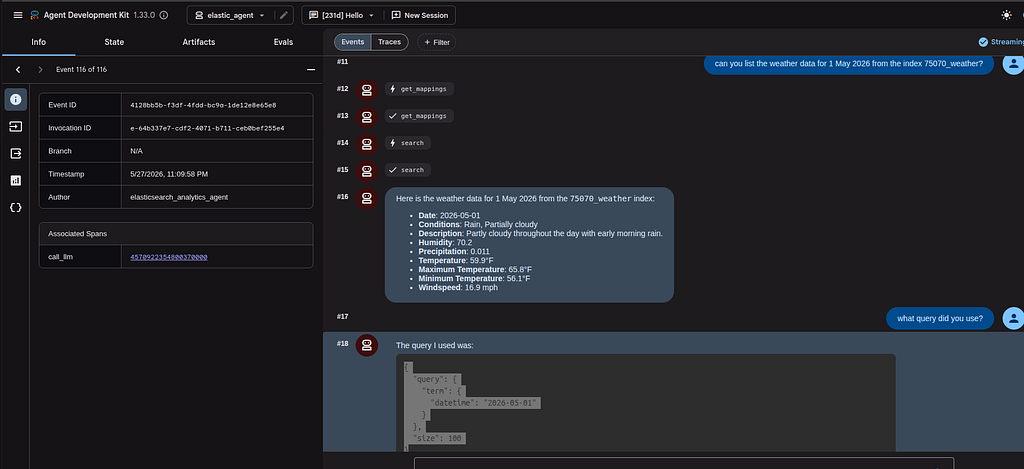
Чтобы проверить систему в деле, я направил запросы к кластеру Elasticsearch, содержащему специализированный индекс погоды 75070_weather — шесть лет детализированных ежедневных погодных данных.
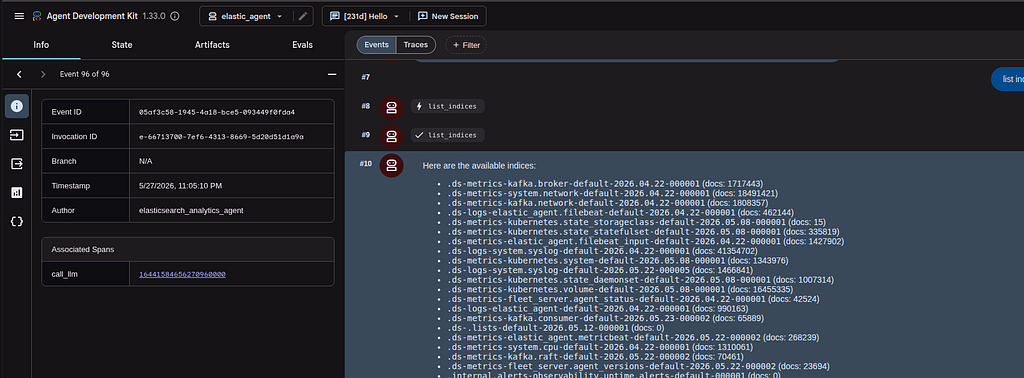
Сначала я задал агенту общий системный вопрос — вывести доступные индексы кластера — чтобы убедиться в корректной работе транспортного слоя SSE и прав доступа по API-ключу:
Затем я усложнил задачу: отправил высокоточный целевой запрос метрики, чтобы посмотреть, как gemini-2.5-flash сопоставит намерение со схемой инструмента бэкенд-сервера MCP:
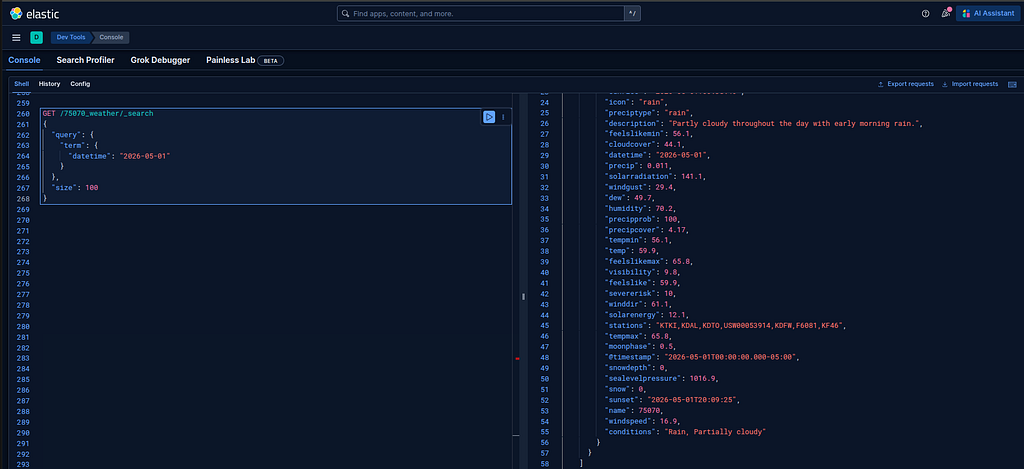
Наконец, для проверки абсолютной точности телеметрии я сверил вывод агента на естественном языке с результатами сырого запроса, выполненного непосредственно в консоли Dev Tools Kibana. Данные совпали полностью:
Заключение
Перейдя от жёстко связанной «агентной обёртки с пользовательским REST-утилитой» к развязанной, протокол-ориентированной архитектуре на базе Model Context Protocol, мы полностью изменили правила игры для клиента.
-
Переиспользуемость: MCP-сервер Elasticsearch в Kubernetes не привязан к этому единственному агенту. Любой будущий инженерный агент, созданный любой командой в организации, может мгновенно к нему подключиться.
-
Соответствие требованиям безопасности: инженерам SRE не нужно управлять сырыми API-ключами в локальных окружениях, а команде безопасности достаточно проверить один протокол-совместимый MCP-контейнер, работающий внутри контролируемого кластера.
Первые шаги в агентном ИИ не обязательно означают создание хрупких, одноразовых скриптов. Такие стандарты, как MCP, и фреймворки, как Google ADK, дают именно ту структуру, которая нужна для готовности ИИ к корпоративному применению.
Заключительные мысли: путь в продакшн
Это руководство демонстрирует MVP-сценарий (минимально жизнеспособный продукт) — развёртывание MCP-сервера в локальной сети и привязку его к агенту для динамических запросов. Однако перевод этой архитектуры из локальной песочницы в полноценную защищённую производственную среду требует нескольких принципиальных инженерных решений.
1. Контейнеризация и оркестрация
Для масштабирования агента и управления его жизненным циклом локальную среду выполнения Python необходимо контейнеризировать.
-
Dockerization: упаковать код
agent.pyв легковесный Docker-контейнер (например, на основе минимального базового образаpython:3.11-slim). -
Управление зависимостями: зафиксировать продакшн-зависимости в строгом файле
requirements.txtилиpyproject.toml, чтобы обеспечить детерминированные воспроизводимые сборки контейнера. -
Совместное размещение в Kubernetes: развернуть контейнеризированный агент в том же кластере Kubernetes, что и MCP-сервер — это позволит им безопасно общаться через внутреннюю сеть кластера без открытия эндпойнтов через внешние LoadBalancer’ы.
2. Аутентификация корпоративного уровня (GCP Workload Identity)
Application Default Credentials (ADC) через gcloud auth application-default login отлично подходит для локальной разработки, но в производственном кластере ему не место.
-
Решение: если агент работает на Google Kubernetes Engine (GKE), используйте Workload Identity Federation for GKE.
-
Принцип работы: этот механизм связывает учётную запись службы Kubernetes (Kubernetes Service Account, KSA) напрямую с учётной записью службы Google Cloud IAM. Под автоматически получает краткосрочные, автоматически ротируемые токены OAuth 2.0, полностью устраняя необходимость в статических учётных данных, скачиваемых JSON-ключах сервисных аккаунтов и локальных аутентификациях разработчиков.
3. Детальный RBAC и принцип минимальных привилегий для MCP-сервера
В рамках MVP наш API-ключ имел относительно широкие права. В производственной среде предоставление LLM-агенту неограниченного доступа к данным кластера создаёт серьёзные риски безопасности — например, уязвимости инъекции подсказок (prompt injection), ведущие к несанкционированной утечке данных.
-
Детализированные ограничения: урезать RBAC Elasticsearch до абсолютного минимума — только необходимые индексы и поля документов.
-
Строгий режим только для чтения: убедиться, что дескриптор роли MCP-сервера жёстко запрещает деструктивные или модифицирующие операции (запись, удаление, обновление), если только это прямо не требуется по сценарию использования, — и подкрепить это надёжным журналированием транзакций и проверкой с участием человека (human-in-the-loop).