kern — быстрая, rootless-песочница и среда выполнения виртуальных ресурсов. Запускает любую рабочую нагрузку в настоящем контейнере, включая вызовы инструментов агента и AI-генерированный код.
Настоящий, аппаратно-изолированный контейнер примерно за 3,5 мс — из одного статического бинарника, без демона.
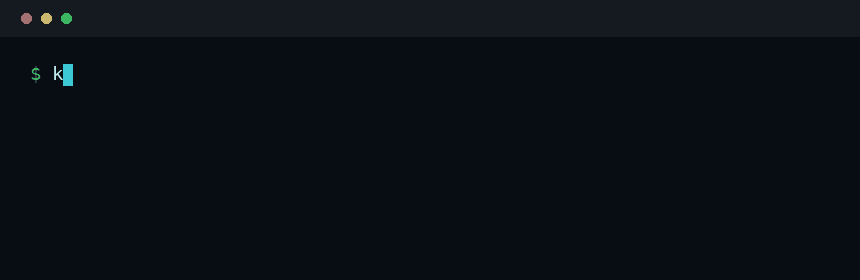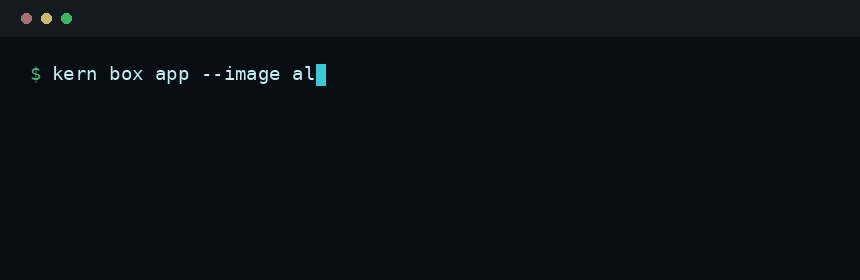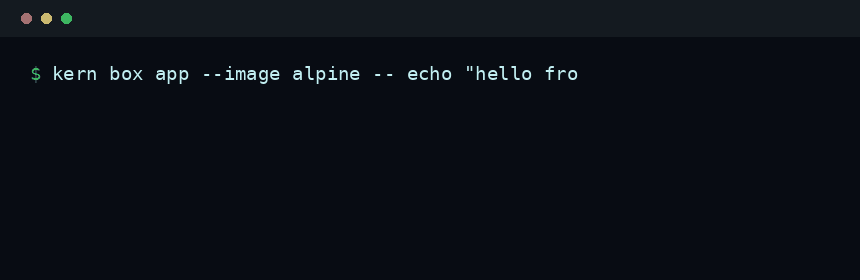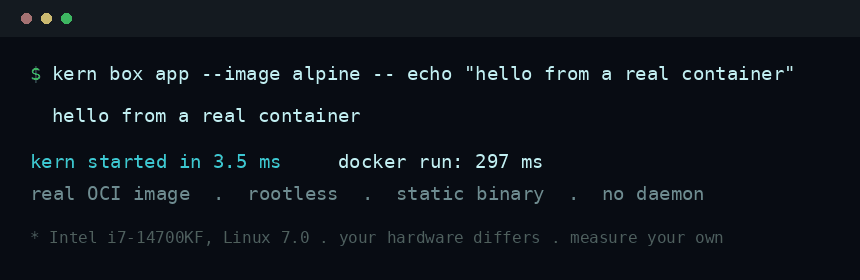
0 байт RAM в покое · никакого демона, никакого сокета, ничего не нужно запускать · один статический бинарник, единственная Rust-зависимость — libc
# установить бинарник релиза (статический, скрипт проверяет контрольную сумму)
curl -fsSL https://raw.githubusercontent.com/getkern/kern/main/install.sh | sh

# одноразовая оболочка в настоящем OCI-образе: rootless, изоляция на уровне ядра, несколько мс
kern box dev --image alpine -it -- sh
# Windows: тот же бинарник под WSL2, скрипт настраивает WSL2 автоматически
irm https://raw.githubusercontent.com/getkern/kern/main/install.ps1 | iex# macOS, два шага: сначала Linux-VM, затем kern внутри неё
brew install colima && colima start && colima ssh
curl -fsSL https://raw.githubusercontent.com/getkern/kern/main/install.sh | sh # внутри VMРаботает напрямую на Linux и ARM-платах, на Windows — через WSL2, на Mac — через colima, Lima или OrbStack: один и тот же бинарник и тот же CLI под ядром Linux. Установка.
Что такое kern
Один бинарник, управляющий ресурсами, первый из которых — изоляция. Именно поэтому kern не укладывается в одну строку сравнительной таблицы: это одновременно среда выполнения контейнеров, песочница, распределитель ресурсов и запускатель стеков — всё в одном статическом бинарнике без демона.
-
Настоящий контейнер. Полноценные OCI-образы:
pull,buildиз Dockerfile,commit,push,save/load. Запуск box из образа занимает ~3,4 мс. -
Изоляция AI-агента — один контейнер на каждый вызов инструмента. Команда, которую агент только что решил выполнить; фрагмент кода, только что написанный моделью; ячейка notebook; шаг CI. kern запускает box, выполняет задачу, удаляет контейнер — настолько быстро, что изоляция на уровне каждого вызова становится поведением по умолчанию. Сеть отключена, если явно не запрошена; ограничения памяти и PID применяет ядро; возможности (capabilities) сброшены; seccomp работает в режиме запрета по умолчанию; таймаут применяется извне.
Типизированные ошибки, а не копание в трассировке стека. Таймаут, принудительное завершение по OOM, заблокированный системный вызов, отсутствующая команда — каждое из этих событий возвращается вместе со стандартным выводом и кодом завершения. Можно ветвиться по результату и продолжать работу.
Один бинарник, никакого демона. Подключается из Python, Node, LangChain или любого MCP-клиента ниже. А также чем kern не является — потому что граница определяется ядром Linux.
-
Rootless — всегда. Пространства имён пользователя (user), PID, монтирования (mount), сети (network), UTS и IPC; корневая файловая система монтируется через overlay или в режиме только для чтения с
pivot_root; allowlist seccomp, запрещающий всё по умолчанию; ограничения cgroup v2. Флаг--security-profile untrusted— это весь усиленный набор в одном параметре. -
Профили ресурсов, не только изоляция. CPU (
vcpu:), память, диск (vdisk:) и устройства (vgpio:) объявляются один раз вkern.tomlи подключаются по имени.kern runприменяет те же ограничения к процессу на хосте без какой-либо песочницы, плюс--landlock-rw <path>— для ограничения записи этого процесса средствами LSM ядра. docs/RESOURCES.md -
Стеки — в собственном формате kern или в уже имеющемся.
kern compose <file> upпринимаетstack.toml(таблицы[box.NAME]с описанными выше профилями ресурсов) илиdocker-compose.ymlбез какого-либо конвертирования. Один стек — один pod, сервисы обращаются друг к другу по имени. -
Инструменты вокруг них.
ps,logs,exec,stats,inspect,wait,top(живой TUI-интерфейс),doctor. Привязка для Python также интегрируется в LangChain двумя способами: как инструмент для выполнения кода и как политика выполнения для его shell-middleware.
Всё дерево Rust-зависимостей kern — это libc: JSON и OCI-манифесты разбираются вручную, а pull вызывает уже установленные на машине curl и tar, не встраивая TLS-стек.
Установка
Бинарник
Контейнер строится на возможностях ядра Linux, поэтому kern работает там, где есть ядро Linux: на Linux и ARM-платах (Raspberry Pi · Jetson · Arduino UNO Q) напрямую; на Windows через WSL2 с готовым rootfs и установщиком, который настраивает WSL2 автоматически; на Mac внутри Linux-VM (colima, Lima, OrbStack, UTM), где это обычный Linux-kern: тот же бинарник, тот же CLI, то же поведение, что и на CI-сервере.
curl -fsSL https://raw.githubusercontent.com/getkern/kern/main/install.sh | shОдин статический файл, никакого тулчейна. Скрипт выбирает x86_64 или aarch64, устанавливает бинарник в ~/.local/bin и отказывается от загрузки, если SHA256 не совпадает. Для сборки из исходников всё дерево зависимостей — один крейт:
cargo install --git https://github.com/getkern/kern getkern --lockedDebian и Ubuntu, Fedora, семейство RHEL (Rocky, CentOS Stream), openSUSE, WSL2 и ARM-платы: любой дистрибутив с неприви-легированными пространствами имён пользователя и cgroup v2. Каждый релиз проходит полный набор тестов на всех перечисленных платформах — в реальных VM и на платах — перед публикацией.
docs/INSTALL.md содержит остальное: ручную проверку контрольной суммы, переменную KERN_INSTALL_DIR, пошаговую установку на Windows и Mac, а также описание того, что делают ограничения ресурсов в VM по умолчанию.
SDK — вызов kern из Python или Node
pip install kern-sandbox
npm  install kern-sandbox
Оба пакета — только обёртка: они находят kern в PATH или по пути, указанному в $KERN_BIN. Релизы пакетов и бинарника не синхронизированы, поэтому при неожиданном поведении стоит проверить версии:
kern --version
python3 -c "import kern_sandbox; print(kern_sandbox.__version__)"
Для чего это предназначено — описано ниже; changelog указывает, в каком релизе появилось каждое исправление.
Быстрый старт
kern box dev --image alpine -it -- sh                  # оболочка в настоящем OCI-образе
kern box svc --image nginx:alpine -d -p 8080:80        # сервис с публикацией порта
kern box job --image python:3.12-slim --security-profile untrusted -- python3 /w/x.py
kern compose stack.toml up                             # целый стек одной командой
--security-profile untrusted объединяет allowlist seccomp, --cap-drop ALL и --read-only в одном флаге. kern ps и kern top показывают запущенное; каждый глагол для просмотра и инспектирования поддерживает --json, так что не нужно разбирать табличный вывод. По одному запускаемому примеру для каждого действия kern: examples/.
Запуск кода агента: Python, Node, LangChain, MCP, pi
Привязки (bindings) — это то, как ваша программа вызывает kern. Код внутри box может быть написан на любом языке, поскольку box — это OCI-образ: Python, Node, Go и Rust запускаются одной и той же командой с разным --image, и то же верно для всего, что поставляется в виде образа.
Агенту нужно где-то выполнять код, который только что написала модель. kern-sandbox — это то самое место: тонкая обёртка без зависимостей поверх бинарника kern, вызываемая из вашей программы. Устанавливается выше; API описан в bindings/python/ и bindings/node/.
from kern_sandbox import run_code

r = run_code("import platform; print(platform.python_version())")
print(r.stdout)          # выполнено в свежем box; таймаут / OOM / заблокированный побег — данные в r.fault
Каждый вызов — это свежий изолированный box: сеть отключена, ограничены память и PID, возможности сброшены, вывод ограничен по размеру, таймаут применяет сама привязка. Таймаут, завершение по OOM или заблокированный системный вызов возвращаются как типизированное поле fault в результате, а не выбрасываются как исключение. code_stderr в этом результате содержит stderr без собственных пометок kern — именно то, что нужно помещать в контекстное окно.
Пакет также включает kern-mcp — stdio-сервер без зависимостей, который даёт Claude Desktop или Cursor локальный интерпретатор кода. Поскольку сервер работает через stdio, одна та же строка конфигурации направляет клиент к box на другой машине.
{ "mcpServers": { "kern": { "command": "kern-mcp" } } }Остальное находится на соответствующих страницах и здесь не дублируется: полный API, расширенный захват результатов, предварительный прогрев (prewarming) и интеграция с LangChain — в bindings/python/README.md и bindings/node/README.md; все переменные KERN_MCP_* и удалённое использование — в docs/MCP.md; для агента кодирования pi — kern-pi, маршрутизирующий его вызовы bash, read, write, edit, ls, grep и find в box, с README, разграничивающим, где граница задаётся ядром, а где это просто проверка пути, — в integrations/pi/.
Запуск целого стека: ваш docker-compose.yml без изменений
Один файл, одна команда. kern читает собственный формат, а также ваш существующий docker-compose.yml — без какого-либо конвертирования.
# stack.toml - одна таблица на сервис, ключи совпадают с флагами `kern box`
[box.db]
image = "postgres:alpine"
env   = ["POSTGRES_PASSWORD=secret", "POSTGRES_DB=app"]

[box.web]
image      = "adminer"
ports      = ["8080:8080"]
depends_on = ["db"]
kern compose stack.toml up # или укажите путь к вашему compose.yaml
kern compose stack.toml watch # пересборка + перезапуск сервиса при изменении его build context
kern compose stack.toml port web 80 # хостовый адрес, обслуживающий этот порт, из запущенного boxОба официальных образа запускаются, web обращается к db по имени сервиса, порт опубликован. В compose-файле также можно указывать специфичные для kern параметры через пространство имён расширений спецификации (x-kern-vcpu, x-kern-security-profile) — и файл по-прежнему без проблем запустится в любой другой среде, поскольку спецификация предписывает любой среде выполнения игнорировать поля x-. Опечатка в таком поле не отбрасывается молча, а сообщается явно.
Стек использует одно сетевое пространство имён, если файл в него укладывается — именно это и даёт скорость: сервисы обращаются друг к другу по 127.0.0.1 без посредников. Если файл не укладывается, kern назначает каждому сервису собственное пространство имён и сообщает, чем это обходится: лишним ретрансляционным прыжком между узлами. Два случая не укладываются: два сервиса, слушающие на одном и том же порту контейнера, и секция networks:, не оставляющая сервисам ничего общего. --pod принудительно задаёт одно пространство имён и явно отказывается выполнять такой файл вместо того, чтобы молча снять изоляцию; --no-pod принудительно задаёт отдельное пространство имён для каждого сервиса.
Официальные образы, переключающиеся на непривилегированного пользователя, требуют uidmap и строки в /etc/subuid, а для внешних загрузок нужен pasta; kern doctor явно укажет на отсутствующее. Это инструмент для локального цикла разработки, а не production-оркестратор. docs/DOCKER-COMPAT.md
Профили ресурсов
Слайс (slice) объявляется один раз в ~/.config/kern/kern.toml и подключается по имени — как к изолированному box, так и к обычному процессу, одним и тем же токеном. Три вида: vcpu: (CPU и память), vdisk: (временный диск с ограничением размера) и vgpio: (узлы устройств).
[[cpu]]                     # бюджет хоста, из которого выделяется слайс
id    = "cpu:0"
cores = 8.0

[[vcpu]]                    # 1.5 ядра и 512 МиБ  ->  подключается как  vcpu:heavy
name    = "heavy"
backend = "cpu:0"
cpus    = 1.5
memory  = "512m"
kern validate ~/.config/kern/kern.toml # проверить конфигурацию до запуска
kern box train --image alpine vcpu:heavy vdisk:scratch -- ./train.sh
kern run vcpu:heavy -- ./train.sh # тот же слайс, без песочницыПрофили компонуются; явный флаг переопределяет значение из профиля; каждый ключ совпадает с соответствующим флагом CLI. Если backend ссылается на необъявленный пул, ошибка возникает при чтении конфигурации, а не при запуске box.
Две вещи, которые kern сообщает явно, а не оставляет на ваши догадки. vdisk: при rootless-запуске — это RAM-backed tmpfs, что бы ни говорил backend, а при привилегированном запуске — образ ext4 на loop-устройстве с настоящей квотой; kern сообщает, что именно вы получили, и ограничение размера действует в обоих случаях. И vgpio: работает на уровне чипа, а не отдельных линий: запрос pins привязывает весь /dev/gpiochipN, открывая каждую линию этого контроллера, так что pins = [17] — это кооперативные метаданные, а не граница безопасности. Указание узла устройства даёт доступ только к этому узлу и ничему больше. docs/RESOURCES.md
Стоимость контейнера и чего в kern нет
Все три столбца измерены на одном хосте, с одной рабочей нагрузкой, в один день: Intel i7-14700KF под управлением Linux 7.0.0; методология — в BENCHMARKS.md.
| kern | Docker | Podman | |
|---|---|---|---|
Демон |
нет |
есть ( |
нет |
Rootless |
да, всегда |
опционально |
да |
Холодный старт, пустой box |
~2,4 мс |
~288 мс |
~297 мс |
Холодный старт, из OCI-образа |
~3,4 мс |
~288 мс |
~297 мс |
Остановка сервиса (init обрабатывает SIGTERM) |
~2,3 мс |
~162 мс |
~194 мс |
Резидентная память в простое |
0 |
154–160 МБ |
0 |
Размер |
один статический бинарник |
стек демонов |
мульти-бинарная установка |
OCI-образы: pull / build / push |
да |
да |
да |
|
да, читается как есть (как организована сеть) |
да |
частично |
Overlay-сети, Swarm, CRI |
нет |
да |
частично |
Проброс GPU в контейнер |
нет |
да |
да |
Производительность
Intel i7-14700KF, Linux 7.0.0, бинарник релиза, чередующиеся пакеты тестов на простаивающей машине.
| kern | bubblewrap | runc | podman | docker | |
|---|---|---|---|---|---|
Холодный старт (пустой box) |
~2,4 мс |
~2,6 мс |
~13,1 мс |
~297 мс |
~288 мс |
200 box параллельно |
~0,11 с |
~0,13 с |
~0,29 с |
~43,1 с |
~16,7 с |
kern опережает bubblewrap примерно на 9%, и этот разрыв достаточно мал, чтобы его можно было подтвердить только при строгой методологии: BENCHMARKS.md содержит описание чередования, 240 пакетов тестов, результаты на платах aarch64, объяснение того, почему используется бинарник релиза, а не локальная сборка, и все оговорки. Значимый разрыв — это разрыв с движками-конкурентами: два порядка величины.
Безопасность
Пространства имён, pivot_root, 16 опасных возможностей (capabilities), сброшенных перед exec, всегда включённый seccomp-allowlist (стандартный фильтр moby минус 35 системных вызовов-путей к побегу, которые kern жёстко блокирует; всё вне проверенного набора возвращает ENOSYS), ограничения cgroup v2, без которых --require-limits отказывается запускаться, и /dev в режиме запрета по умолчанию. Там, где граница является кооперативной, а не обеспечивается ядром, SECURITY.md явно об этом говорит и называет способ обхода.
Не нужно верить на слово. pentest/ содержит пять наборов состязательных тестов, которые проверяют эти границы на уровне ядра, а не по отчётам самого kern, — без аккаунта в реестре и без сети:
sh pentest/run-with-local-registry.sh ./target/release/kern pentest/pentest-ports.shСообщить об уязвимости конфиденциально можно через GitHub Security Advisories или по адресу hello@getkern.dev.
Документация
| Документ | Содержание |
|---|---|
установка на Linux, WSL2 и ARM-платах, из исходников |
|
MCP-сервер: инструменты, все переменные |
|
что из Docker работает, что нет, и в чём отличия |
|
двухглагольная модель с томами и vdisk, схема |
|
модель угроз (структурированная, затем по механизмам) и почему ограничение VRAM в пространстве пользователя не является границей безопасности |
|
чего сегодня не хватает или не измерено, и что может появиться |
|
замеры производительности и запуск на Pi, Jetson или UNO Q |
|
92 запускаемых скрипта и развёрнутые статьи |
|
SDK |
Статус
Ядро готово, CLI заморожен. 1217 тестов на Rust, 458 на Python и 93 на Node, без предупреждений clippy и cargo-deny, на Linux, WSL2, Raspberry Pi 5, Jetson Orin Nano и Arduino UNO Q.
Скрипт, написанный под текущий CLI, продолжит работать: ни один глагол, флаг или поле --json не меняет смысл внутри патч-релиза. Что изменилось в каждом из них — в changelog.
Чем kern не является
-
Не гипервизор. Граница — это ядро Linux, поэтому ошибка повышения привилегий в ядре является побегом из изоляции. kern предназначен для кода, который вы сами решили запустить и за последствия которого несёте ответственность, а не для враждебного кода от посторонних на ядре, которое вы делите с другими арендаторами.
-
Не свободен от компромиссов пространств имён пользователя (userns). Изоляция строится на неприви-легированных пространствах имён пользователя — плодотворном источнике LPE-уязвимостей ядра. SECURITY.md говорит об этом прямо, прежде чем делать какие-либо утверждения.
-
Не защищает то, что вы монтируете внутрь.
-v $HOME:/hostпередаёт в box вашу домашнюю директорию.--net hostи--privileged— это явные отказы от изоляции, указываемые по имени. -
Не переработка Docker Engine. Речь о форматах, а не об API: нет overlay-сетей, нет плагинов, нет Swarm. docs/DOCKER-COMPAT.md
-
Не среда выполнения Kubernetes. Нет CRI. Используйте containerd или CRI-O.
-
Не управляет GPU-слайсами. Есть в дорожной карте.
kern doctorсообщает, что даст ограничение VRAM для каждого GPU; на потребительском железе это кооперативная квота, а НЕ граница от вредоносного кода. Ничто не перехватывает вызовы драйвера и ничто не ограничивает GPU.
Известные пробелы: ROADMAP.md#known-gaps-and-what-would-settle-them.
Участие в разработке
Issues и pull request’ы приветствуются. CONTRIBUTING.md описывает рабочий процесс и требования; на вклады распространяется CLA.
Мейнтейнер
Алессандро Полито (Alessandro Polito), @realexhub, Италия. В ранних коммитах фигурирует @getkerndev — аккаунт, с которого был опубликован проект.
Лицензия
Apache-2.0. См. LICENSE и TRADEMARK.md.