Надёжность тестов определяется надёжностью среды, в которой они выполняются. Когда среда общая, нестабильная или непредсказуемая, даже самая тщательно написанная автоматизация тестирования даёт результаты, на которые невозможно опереться. Современные инженерные команды выпускают распределённые системы с десятками микросервисов на Kubernetes, управляемыми базами данных, событийными шинами и сервисными mesh-сетями — и долгоживущие staging-окружения попросту не успевают за таким темпом.
Эфемерные окружения (ephemeral environments) — это ответ, к которому приходят зрелые платформенные и QA-команды. Это короткоживущие, изолированные, полностью готовые к работе окружения по запросу, которые автоматически создаются из pull request и уничтожаются сразу после выполнения своей задачи. В этом руководстве разбирается, почему традиционные подходы дают сбой, что такое эфемерные окружения на самом деле, какой современный стек лежит в их основе, и приводится конкретный, проиллюстрированный кодом план построения первого эфемерного пайплайна тестирования — с манифестами Kubernetes, воркфлоу GitHub Actions и примерами Argo CD ApplicationSet, которые можно адаптировать уже сегодня.
Почему традиционные QA-окружения ломаются при масштабировании
Общие окружения не масштабируются
Несколько долгоживущих staging-окружений работают, пока команда невелика и изменения редки. Как только несколько команд начинают выкатывать изменения параллельно, эти окружения превращаются в узкое место. Миграция схемы одной команды затирает тестовые фикстуры другой. Rolling-деплой происходит прямо посреди регрессионного прогона. Конфигурация незаметно уплывает между сбросами. В итоге доверие к сигналам из таких окружений неуклонно падает, а среднее время обнаружения (MTTD, mean time to detect) регрессий, которые должны были выявляться на стадии pull request, растёт.
Добавление новых статических окружений не устраняет корневую причину
Первый инстинктивный ответ — поднять больше постоянных окружений. Но технический долг по сопровождению растёт линейно с каждым новым: больше пайплайнов, которые нужно держать в рабочем состоянии, больше датасетов для обновления, больше секретов для ротации, больше дрейфа инфраструктуры для исправления. Коллизии возвращаются через несколько недель, потому что корневая проблема — долгоживущее общее состояние — никуда не делась. Статические окружения — это налог на координацию, замаскированный под инфраструктуру.
Трения между QA, разработкой и релизным процессом
Ручным тестировщикам нужно непрерывное время для проверки сложных сценариев. Автоматизированным пайплайнам нужны предсказуемые состояния системы. Разработчикам нужны быстрые перевыкатки для проверки исправлений. В модели с общим окружением эти потребности постоянно конфликтуют: тесты приостанавливаются, фикстуры перестраиваются, пайплайны перезапускаются — и всё это поглощает инженерное время, не давая новой информации.
Сложность облачно-нативных систем
Kubernetes, управляемые базы данных вроде Aurora, DynamoDB или Spanner, брокеры сообщений такие как Kafka и SQS, объектные хранилища и сервисные mesh-сети — всё это увеличивает стоимость каждого общего окружения. Микросервисы остаются тесно связанными во время выполнения, даже если их репозитории разделены. Локальные эмуляторы и инструменты вроде LocalStack помогают в процессе внутренней разработки (inner-loop), но не могут воспроизвести IAM-границы, сетевые пути и поведение управляемых сервисов, необходимые для надёжного сквозного QA.
Дрейф и загрязнение тестовых данных
В общих окружениях накапливаются неполные датасеты, устаревшие записи, утечки персональных данных и одноразовые конфигурации, которые никто не решается удалить. Тестировщики тратят больше времени на подготовку данных, чем на проверку функциональности, а любой тест, зависящий от структуры данных, по определению становится нестабильным. Гигиена тестовых данных — это тихий убийца скорости QA.
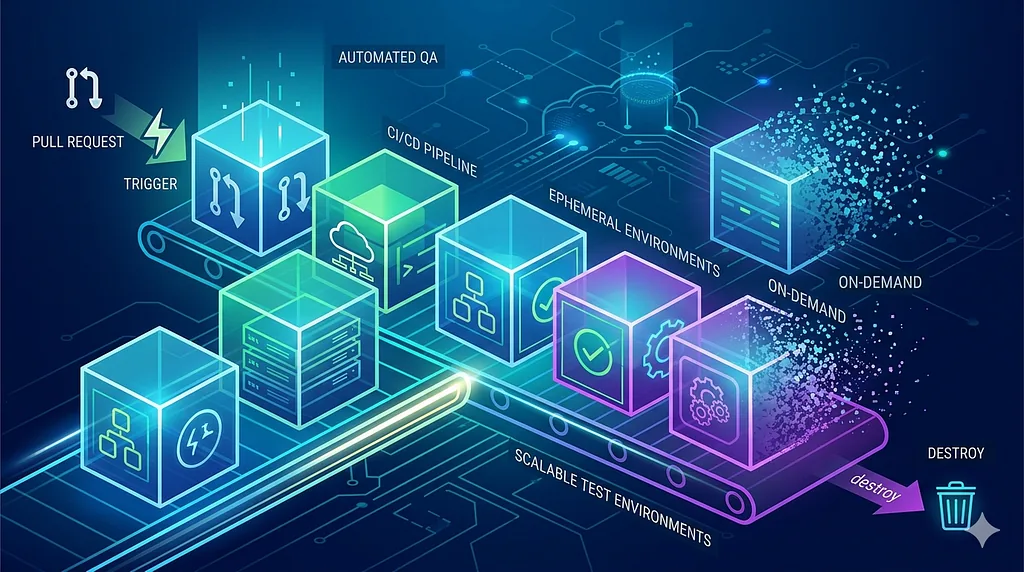
Что такое эфемерные окружения?
Эфемерное окружение — это короткоживущая, полностью функциональная среда, создаваемая для конкретной цели: как правило, для валидации feature-ветки, pull request или релизного кандидата. Каждое такое окружение:
-
Автоматически разворачивается из декларативного кода — никакой ручной настройки через интерфейс.
-
Изолировано от всех других команд и пайплайнов.
-
Привязано к конкретному воркфлоу с определённым временем жизни.
-
Уничтожается автоматически при слиянии, закрытии или истечении TTL.
Удобный способ оценить любую стратегию эфемерных окружений — проверить, обеспечивает ли она четыре гарантии: изоляцию, воспроизводимость, соответствие production-среде и одноразовость. Если хотя бы одна из них отсутствует, окружение деградирует в хрупкое общее рабочее пространство.
Современный стек для эфемерных окружений
Единого готового продукта не существует. Надёжная реализация собирается из нескольких слоёв, каждый из которых решает свою задачу.
Изоляция на уровне Kubernetes
vCluster запускает виртуальные кластеры Kubernetes внутри хост-кластера, предоставляя каждому pull request собственную control plane без затрат на отдельные узлы. Loft добавляет поверх него многотенантное управление. Для более лёгкой изоляции часто достаточно паттерна «один namespace на PR» в сочетании с ResourceQuota, LimitRange и NetworkPolicy. Распространённое соглашение — формировать имя namespace из pr-${PR_NUMBER}-${CI_COMMIT_SHORT_SHA} и навешивать метку для TTL-контроллера:
apiVersion: v1
kind: Namespace
metadata:
  name: pr-1287-a3f9c2b
  labels:
    app.kubernetes.io/managed-by: ephemeral-controller
    pr-number: "1287"
    ttl: "24h"
    cost-center: platform-qa
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: pr-1287-a3f9c2b-quota
  namespace: pr-1287-a3f9c2b
spec:
  hard:
    requests.cpu: "4"
    requests.memory: 8Gi
    limits.cpu: "8"
    limits.memory: 16Gi
    persistentvolumeclaims: "5"
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: deny-cross-namespace
  namespace: pr-1287-a3f9c2b
spec:
  podSelector: {}
  policyTypes: [Ingress, Egress]
  ingress:
    - from:
        - podSelector: {}
        - namespaceSelector:
            matchLabels:
              role: shared-ingress
Этот паттерн из трёх ресурсов обеспечивает изоляцию, квоту ресурсов и явное время жизни — и всё это менее чем в пятидесяти строках YAML.
GitOps и непрерывная доставка
Argo CD поставляется с ресурсом ApplicationSet и генератором Pull Request, который автоматически создаёт Application для каждого открытого PR, синхронизируя соответствующие манифесты с соответствующим namespace. Результат: PR открыт — и через несколько минут существует полностью согласованный деплой без какого-либо участия человека.
apiVersion: argoproj.io/v1alpha1
kind: ApplicationSet
metadata:
  name: ephemeral-previews
  namespace: argocd
spec:
  generators:
    - pullRequest:
        github:
          owner: your-org
          repo: your-service
          tokenRef:
            secretName: github-token
            key: token
        requeueAfterSeconds: 60
  template:
    metadata:
      name: 'pr-{{number}}'
    spec:
      project: previews
      source:
        repoURL: https://github.com/your-org/your-service
        targetRevision: '{{head_sha}}'
        path: deploy/overlays/preview
        helm:
          parameters:
            - name: image.tag
              value: '{{head_sha}}'
            - name: ingress.host
              value: 'pr-{{number}}.preview.example.com'
      destination:
        server: https://kubernetes.default.svc
        namespace: 'pr-{{number}}'
      syncPolicy:
        automated:
          prune: true
          selfHeal: true
        syncOptions:
          - CreateNamespace=true
Flux предлагает аналогичный паттерн с ImageUpdateAutomation. Helm-чарты и Kustomize-оверлеи параметризуют значения, специфичные для каждого окружения, без дублирования манифестов.
Инфраструктура как код
Terraform и его open-source форк OpenTofu остаются рабочими лошадками для облачных ресурсов. Pulumi предоставляет типизированный IaC на TypeScript, Go или Python. Crossplane переворачивает модель: облачные ресурсы становятся Kubernetes CRD, и тот же цикл согласования, который управляет воркнагрузками, управляет и S3-бакетами, и RDS-инстансами.
Чистый паттерн — держать отдельный воркспейс ephemeral/ для каждого PR с удалённым state и блокировкой:
terraform {
  backend "s3" {
    bucket         = "platform-tf-state"
    key            = "ephemeral/${var.pr_number}/terraform.tfstate"
    region         = "us-east-1"
    dynamodb_table = "tf-locks"
    encrypt        = true
  }
}

resource "aws_s3_bucket" "preview_assets" {
  bucket = "preview-${var.pr_number}-${var.commit_sha}"
  tags = {
    Lifecycle = "ephemeral"
    PR        = var.pr_number
    TTL       = "24h"
    AutoClean = "true"
  }
}

resource "aws_s3_bucket_lifecycle_configuration" "auto_expire" {
  bucket = aws_s3_bucket.preview_assets.id
  rule {
    id     = "expire-after-1-day"
    status = "Enabled"
    expiration { days = 1 }
  }
}
Тег Lifecycle = "ephemeral" на каждом ресурсе превращает обнаружение осиротевших объектов в тривиальный запрос, а не в криминалистическое расследование.
Preview-окружения как сервис
Командам, которые предпочитают купить готовое решение, а не строить своё, подойдут Uffizzi, Coherence, Shipyard, Qovery, Northflank, preview-окружения Render и Railway — все они предлагают управляемые платформы для preview-окружений. Небольшим командам стоит начать именно с них; платформенные команды, работающие в масштабе, как правило, переходят на собственную связку Argo CD + vCluster ради контроля над стоимостью и гибкости настройки.
Ветвление баз данных и тестовые данные
Тестовые данные — обычно самая сложная часть эфемерного тестирования. Neon, PlanetScale и Supabase предлагают ветви баз данных с копированием при записи (copy-on-write), которые можно создать за секунды для каждого PR. Snaplet, Tonic.ai и Synthesized генерируют ссылочно-целостные анонимизированные синтетические датасеты. На уровне модульных и интеграционных тестов Testcontainers поднимает одноразовые базы данных прямо в тестовом процессе, а LocalStack эмулирует сервисы AWS в CI.
Типичный жизненный цикл ветви Neon внутри GitHub Actions:
name: ephemeral-db
on: [pull_request]
jobs:
  branch:
    runs-on: ubuntu-latest
    steps:
      - name: Create Neon branch
        id: neon
        run: |
          BRANCH=$(neonctl branches create \
            --name "pr-${{ github.event.number }}" \
            --parent main \
            --output json | jq -r '.branch.id')
          CONN=$(neonctl connection-string "$BRANCH" --pooled)
          echo "DATABASE_URL=$CONN" >> "$GITHUB_OUTPUT"
      - name: Run migrations
        run: npx prisma migrate deploy
        env:
          DATABASE_URL: ${{ steps.neon.outputs.DATABASE_URL }}
      - name: Seed anonymized snapshot
        run: npx snaplet snapshot restore latest --reset
        env:
          DATABASE_URL: ${{ steps.neon.outputs.DATABASE_URL }}
  cleanup:
    if: github.event.action == 'closed'
    runs-on: ubuntu-latest
    steps:
      - name: Delete Neon branch
        run: neonctl branches delete "pr-${{ github.event.number }}"
Паттерн устойчив по трём причинам: имя ветви детерминировано, строка подключения передаётся как вывод джобы, а удаление срабатывает по событию closed, поэтому ресурсы никогда не утекают.
Паритет локальной и облачной среды
Telepresence и mirrord позволяют разработчику маршрутизировать локальный процесс в удалённый кластер, обращаясь к реальным зависимостям без полного передеплоя. Skaffold и Tilt ускоряют внутренний цикл разработки. Devfile и Devcontainers делают настройку рабочей станции воспроизводимой для всей команды.
Гигиена секретов и конфигурации
Никогда не встраивайте секреты в образы. External Secrets Operator получает учётные данные из HashiCorp Vault, AWS Secrets Manager или Doppler во время выполнения:
apiVersion: external-secrets.io/v1beta1
kind: ExternalSecret
metadata:
  name: preview-db-credentials
  namespace: pr-1287-a3f9c2b
spec:
  refreshInterval: 1m
  secretStoreRef:
    name: aws-secrets
    kind: ClusterSecretStore
  target:
    name: db-credentials
    creationPolicy: Owner
  data:
    - secretKey: url
      remoteRef:
        key: ephemeral/pr-1287/database
        property: connection_string
SOPS шифрует манифесты, делая их безопасными для хранения в Git. Драйвер Kubernetes CSI Secret Store монтирует секреты напрямую из источника истины, не материализуя их в объекты Secret.
Контроль стоимости и жизненного цикла
Эфемерные окружения терпят коммерческий провал, когда никто не следит за счётом. Karpenter за секунды выделяет узлы нужного размера и агрессивно их консолидирует. KEDA масштабирует простаивающие воркнагрузки до нуля после периода бездействия:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: preview-api
  namespace: pr-1287-a3f9c2b
spec:
  scaleTargetRef:
    name: api
  minReplicaCount: 0
  maxReplicaCount: 3
  cooldownPeriod: 300
  triggers:
    - type: prometheus
      metadata:
        serverAddress: http://prometheus.monitoring.svc:9090
        metricName: http_requests_total
        threshold: "1"
        query: sum(rate(http_requests_total{namespace="pr-1287-a3f9c2b"}[2m]))
kube-janitor или небольшой собственный TTL-оператор утилизирует namespace по метке. Потолки ResourceQuota на уровне PR в сочетании с дашбордами Kubecost превращают стоимость в видимый сигнал, а не в квартальный сюрприз.
Наблюдаемость одноразовых систем
Короткоживущие окружения превращаются в кошмар отладки без хорошей телеметрии. Инструментируйте каждый сервис с помощью SDK и Collector OpenTelemetry, добавляя pr_number, commit_sha и env_id как атрибуты ресурса — чтобы трейсы оставались доступными для поиска ещё долго после уничтожения окружения:
processors:
  resource:
    attributes:
      - key: deployment.environment
        value: "ephemeral"
        action: upsert
      - key: pr.number
        from_attribute: K8S_POD_LABEL_PR_NUMBER
        action: insert
      - key: commit.sha
        from_attribute: K8S_POD_LABEL_COMMIT_SHA
        action: insert
exporters:
  otlp/tempo:
    endpoint: tempo.observability.svc:4317
    tls: { insecure: true }
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [resource, batch]
      exporters: [otlp/tempo]
Стек Grafana — Tempo, Loki, Mimir — и Honeycomb одинаково хорошо подходят для исследования данных с высокой кардинальностью.
Эталонный жизненный цикл эфемерного QA-пайплайна
Типичный поток, запускаемый по PR, выглядит так:
-
PR открыт — запускается CI (GitHub Actions, GitLab CI, Buildkite или аналог).
-
Планирование и применение IaC — Terraform или OpenTofu выделяет облачные ресурсы; Crossplane согласует управляемые сервисы как Kubernetes CRD.
-
Создание среза кластера — выделяется vCluster или namespace с ResourceQuota, NetworkPolicy и LimitRange.
-
Деплой микросервисов — Argo CD ApplicationSet синхронизирует Helm- или Kustomize-манифесты, закреплённые за digest образа этого PR.
-
Ветвление базы данных или её наполнение —
neonctl branches createразветвляет базу данных, или Snaplet восстанавливает анонимизированный снэпшот. -
Инъекция секретов и конфигурации — External Secrets Operator получает учётные данные; сервисная mesh-сеть (Istio, Linkerd или Cilium) обеспечивает mTLS и маршрутизацию трафика.
-
Параллельный запуск автоматизированных наборов тестов — Playwright, Cypress, k6, контрактные тесты Pact и фаззинг Schemathesis выполняются параллельно (sharded).
-
Публикация отчётов в PR — покрытие, производительность, diff контрактов и ссылки на трейсы OpenTelemetry появляются прямо в PR.
-
Автоматическое удаление — при слиянии, закрытии или истечении TTL финализаторы каскадно вызывают Crossplane и Terraform; ветвь базы данных удаляется; namespace убирается.
Минимальный скелет GitHub Actions, связывающий первый и последний шаги:
name: ephemeral-environment
on:
  pull_request:
    types: [opened, synchronize, reopened, closed]
concurrency:
  group: preview-${{ github.event.number }}
  cancel-in-progress: true
jobs:
  provision:
    if: github.event.action != 'closed'
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Terraform apply
        run: terraform -chdir=infra/ephemeral apply -auto-approve
        env:
          TF_VAR_pr_number: ${{ github.event.number }}
          TF_VAR_commit_sha: ${{ github.sha }}
      - name: Trigger Argo CD sync
        run: argocd app sync pr-${{ github.event.number }} --prune
      - name: Wait for healthy
        run: argocd app wait pr-${{ github.event.number }} --health --timeout 600
      - name: Run E2E suite
        run: npx playwright test --shard=${{ matrix.shard }}/4
        strategy:
          matrix: { shard: [1, 2, 3, 4] }
  destroy:
    if: github.event.action == 'closed'
    runs-on: ubuntu-latest
    steps:
      - name: Terraform destroy
        run: terraform -chdir=infra/ephemeral destroy -auto-approve
QA-практики, раскрывающие потенциал эфемерных окружений
Инфраструктура — лишь половина истории. Практики, которые превращают эфемерные окружения в усилитель надёжности:
-
Контрактное тестирование с Pact и OpenAPI-линтинг через Spectral развязывают команды сервисов. Запускайте потребительские контрактные тесты (consumer-driven contract tests) против каждого preview, чтобы ловить ломающие изменения до слияния.
-
Смещение безопасности влево (shift-left security) через Trivy для сканирования образов, Checkov или tfsec для IaC, Snyk для зависимостей и OPA/Conftest как admission gate для манифестов.
-
Приватно-безопасные синтетические данные с детерминированными сидерами и маскированными снэпшотами — никогда не копируйте production-данные с персональной информацией в preview.
-
Параллельное шардирование тестов — Playwright shards, распределённые прогоны k6 и воркеры Jest, настроенные под количество vCPU в CI, — чтобы получать обратную связь не дольше десяти минут.
-
Хаос-инжиниринг на одноразовых окружениях с LitmusChaos или Chaos Mesh: убийство подов, сетевые задержки, потеря пакетов и нагрузка на CPU становятся полноправными тест-кейсами без какого-либо риска для staging.
-
Виртуализация внешних зависимостей с WireMock, MockServer, Hoverfly или Prism для OpenAPI-моков — чтобы нестабильность сторонних API никогда не добиралась до пайплайна.
Эксперимент Chaos Mesh, который выполняется только в PR-preview и никогда на staging:
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: latency-canary
  namespace: pr-1287-a3f9c2b
spec:
  action: delay
  mode: all
  selector:
    namespaces: [pr-1287-a3f9c2b]
    labelSelectors:
      app: api
  delay:
    latency: "200ms"
    correlation: "50"
    jitter: "25ms"
  duration: "5m"
Как построить первый эфемерный пайплайн окружений
Прагматичный план внедрения:
-
Выберите один сервис и один PR-воркфлоу. Не пытайтесь переделать всё сразу. Докажите ценность на одном критическом пути.
-
Кодифицируйте окружение в IaC. Каждый ресурс — декларативно, каждое изменение — через ревью, никакой ручной настройки через интерфейс не переживёт первого месяца.
-
Подключите GitOps. Используйте Argo CD ApplicationSet с генератором PR или эквивалент Flux. Рассматривайте кластер как reconciler, а не как цель для деплоя.
-
Сначала решите проблему тестовых данных. Выберите инструмент ветвления базы данных или инвестируйте в пайплайны наполнения, прежде чем масштабироваться. Именно на данных буксует большинство эфемерных программ.
-
Добавьте TTL и защитные ограничения по стоимости в первый же день. Метки TTL на namespace, ResourceQuota, масштабирование до нуля через KEDA и покомандные бюджеты в Kubecost — это не опциональное украшение, а то, что позволит программе пережить первый счёт.
-
Настройте инструментирование до масштабирования. С самого первого PR отслеживайте длительность выделения окружения, процент успехов и стоимость на окружение — чтобы потом иметь доказательную базу для всех решений.
Типичные ошибки и способы их избежать
-
Задержка холодного старта. Предварительно прогревайте AMI и образы контейнеров, используйте консолидацию Karpenter и запустите кэш-прокси реестра (
registry:2в режиме proxy) внутри кластера. -
Бесконтрольный рост стоимости. Принудительно задавайте TTL на уровне контроллера, масштабируйте до нуля через KEDA и показывайте командам их бюджеты в Kubecost.
-
Сложно воспроизводимые stateful-сервисы. Используйте наполнение на основе снэпшотов и ветвящиеся базы данных. Никогда не разделяйте доступное для записи состояние между PR.
-
Нестабильность сторонних API. По умолчанию используйте контрактные моки через WireMock или Prism; резервируйте реальные вызовы для ночных прогонов.
-
Гигиена секретов. External Secrets Operator в сочетании с короткоживущими IAM-правами через IRSA на AWS или Workload Identity на GCP исключает статические учётные данные.
-
Дрейф между эфемерными и production-окружениями. Используйте одни и те же Helm-чарты, одинаковые digest образов и одни и те же Terraform-модули. Расхождения — это тихий убийца паритета окружений.
Измерение успеха — KPI для эфемерного QA
Программа, которую невозможно измерить, не получит финансирования. Отслеживайте как минимум:
-
Длительность выделения окружения — цель: менее пяти минут.
-
Время от PR до валидированной обратной связи — цель: менее пятнадцати минут.
-
Тренд нестабильности тестов — должен снижаться месяц за месяцем.
-
Среднее время обнаружения регрессий (MTTD).
-
Стоимость одного эфемерного окружения в час.
-
Процент PR, заблокированных полным автоматизированным покрытием.
-
Процент успешных удалений — количество осиротевших ресурсов должно стремиться к нулю.
Стартовый PromQL-запрос для визуализации стоимости всех активных preview по командам:
sum by (team) (
  kube_namespace_labels{label_lifecycle="ephemeral"}
  * on(namespace) group_left(team)
  kubecost_namespace_cost_hourly
)
Заключение
Эфемерные окружения переводят QA из разряда проблемы координации в разряд инженерной задачи. Статический staging служил своей цели, пока команды были небольшими и изменения редкими, — но он больше не подходит для облачно-нативных систем, которые выкатываются непрерывно. Комбинируя изоляцию Kubernetes, GitOps, инфраструктуру как код, ветвление баз данных и строгий контроль стоимости, инженерные организации могут дать каждому pull request собственное окружение, верно отражающее production, — и уничтожать его сразу после того, как оно выполнило свою работу.
Направление движения очевидно: надёжное тестирование в масштабе больше не означает владение большим числом окружений — оно означает владение меньшим числом, но более умных и короткоживущих. Именно так современные команды достигают более быстрой обратной связи, более экономной инфраструктуры и CI/CD-пайплайнов, которые наконец говорят правду.