Зачем это нужно
Стандартный планировщик Kubernetes отлично справляется с размещением рабочих нагрузок общего назначения: проверяет, может ли под запуститься на узле, соблюдает основные правила планирования и быстро выбирает подходящий узел. Для большинства сервисов это оптимальный подход.
KSolver появился потому, что некоторые рабочие нагрузки требуют иной цели оптимизации. Парки GPU и другие дефицитные вычислительные ресурсы стоят дорого, чувствительны к конфигурации и легко фрагментируются. Локально разумное размещение всё равно может расточительно тратить ёмкость: задача на 1 GPU способна «заморозить» узел с 8 GPU, низкоприоритетная задача — заблокировать высокоприоритетную группу обучения, а рабочая нагрузка может запросить H100, хотя GPU-класс попроще вполне бы подошёл.
В таких случаях вопрос не только «может ли под здесь запуститься?», но и:
-
Оставит ли это размещение достаточно непрерывной GPU-ёмкости для следующего крупного задания?
-
Использует ли эта рабочая нагрузка правильный класс GPU, объём памяти и топологию узла?
-
Может ли задача с низким приоритетом завершиться к своему дедлайну, используя меньше ресурсов или более дешёвые?
-
Какие ограничения мешают консолидации, допуску или масштабированию вниз?
-
Каковы денежные и ёмкостные издержки текущих правил размещения?
KSolver создан для команд SRE и платформенных инженеров, которым нужны объяснения и контроль. Он использует те же ограничения Kubernetes в качестве входных данных, но оценивает размещение глобально — это позволяет командам снижать фрагментацию, выяснять причины ожидания подов, измерять потери и решать, стоит ли применять специализированный GPU-планировщик вместо стандартного.
Что умеет KSolver
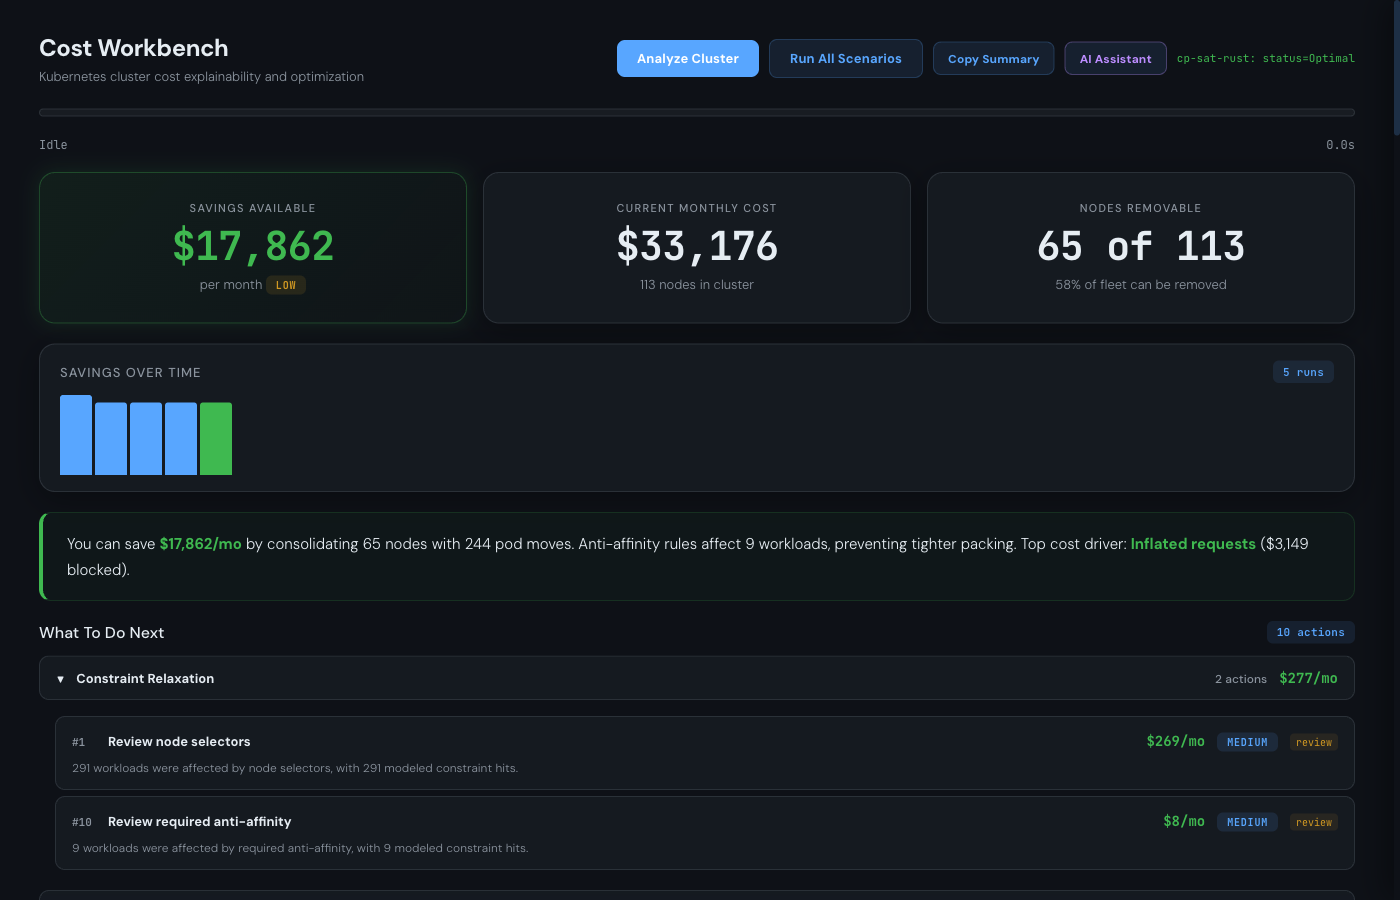
KSolver отвечает на один вопрос: насколько вы переплачиваете за вычисления и что мешает тратить меньше?
Он собирает с кластера узлы, поды, taint’ы, affinity- и anti-affinity-правила, ограничения топологического распределения (topology spread constraints), PDB, селекторы узлов, VPA и DaemonSet’ы. Всё это поступает в решатель ограничений, который совместно оптимизирует размещение и уровни запросов, после чего отображает:
-
Экономию в деньгах с разбивкой по консолидации размещения, оптимизации запросов и ослаблению ограничений
-
Ранжированный список действий с командами
kubectl, метками сложности и уровнями риска -
Атрибуцию стоимости ограничений — сколько именно обходится каждый taint, правило affinity или anti-affinity
-
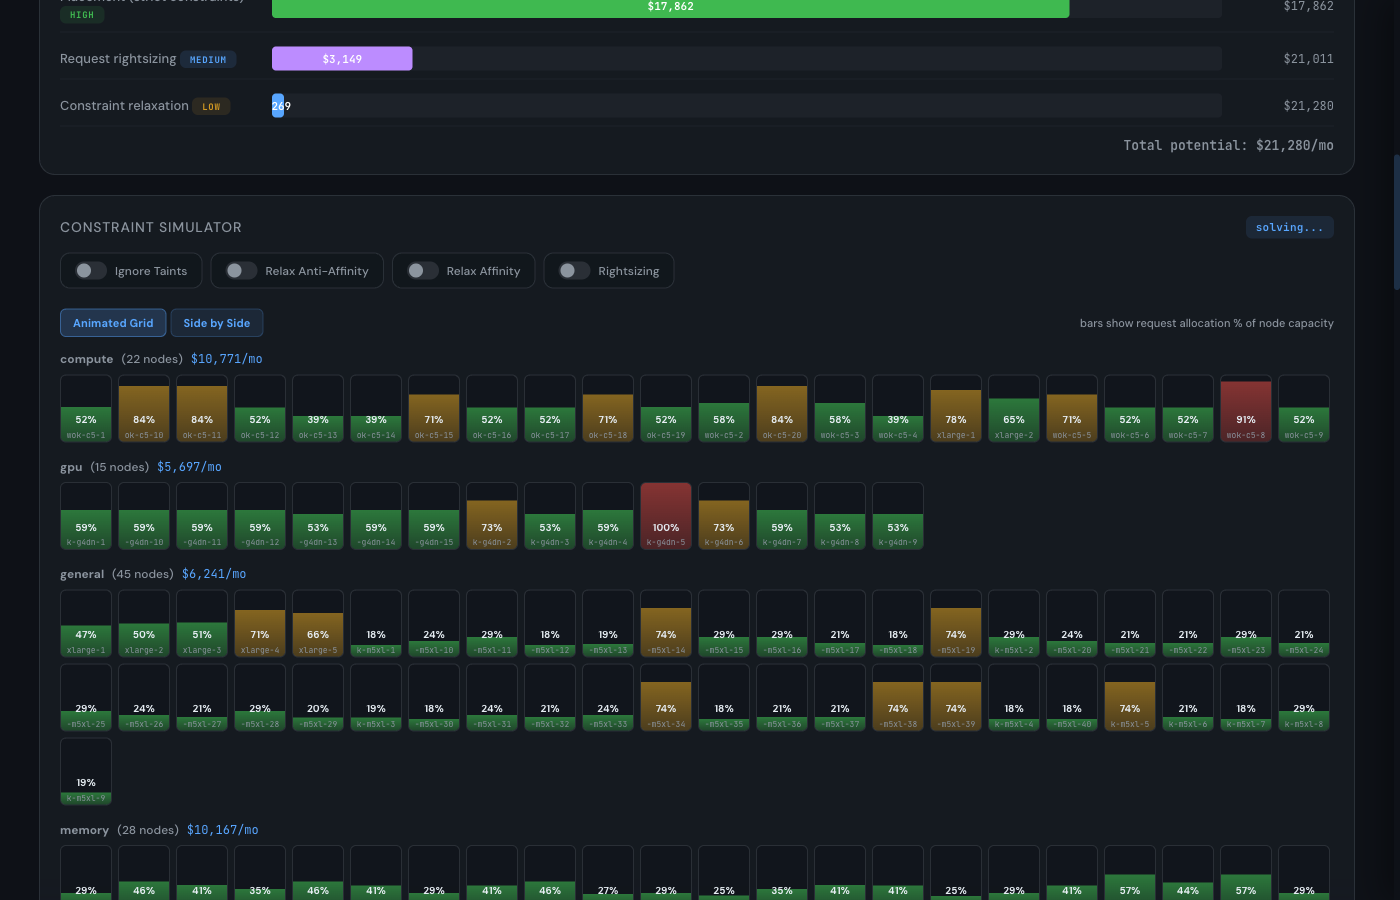
Интерактивный симулятор ограничений для включения и отключения ограничений с наблюдением консолидации узлов в реальном времени
-
Анализ освобождаемости каждого узла — какие узлы можно опустошить и что на них закреплено
-
Рекомендации по парку машин с предложением более выгодных типов инстансов из каталога цен
-
Покрытие VPA — подсветка рабочих нагрузок без VPA и оценка связанных потерь
Быстрый старт
# Сборка
cargo build --features rust-cp-sat

# Запуск с текущим kubeconfig
./target/debug/ksolver serve 0.0.0.0:8080

# Открыть панель управления
open http://localhost:8080
Установка через Helm
helm install ksolver oci://us-central1-docker.pkg.dev/syslens-dev/syslens/ksolver \
  --version 0.5.1 \
  --namespace ksolver --create-namespace
Для теневого цикла GPU-планировщика разверните тот же чарт в режиме только наблюдения:
helm install ksolver ./chart \
  --namespace ksolver --create-namespace \
  --set runtime.mode=shadow \
  --set scheduler.bindingRolloutMode=observe-only \
  --set scheduler.enableRealBinding=false \
  --set scheduler.bindingKillSwitch=true
По умолчанию RBAC чарта работает в режиме только чтения. Разрешения на запись pods/binding и Event не генерируются, если явно не заданы rbac.allowBindingMutations=true или rbac.allowEventWrites=true — и то и другое защищено условиями, привязанными к соответствующим переключателям теневого режима.
Архитектура
ksolver/src/
  collector.rs          Сбор данных из Kubernetes API (узлы, поды, VPA, PDB и др.)
  model.rs              Доменные типы — Node, Workload, Constraint, Solution
  normalizer.rs         Нормализация собранного состояния во входные данные решателя
  optimizer_input.rs    Построение переменных и ограничений модели CP-SAT
  cpsat_rust.rs         Интеграция с решателем CP-SAT через привязки or-tools
  planner.rs            Постобработка: генерация перемещений, действий, водопада экономии
  explainability.rs     Атрибуция стоимости ограничений и анализ блокировок
  pricing.rs            Каталог цен на инстансы облачных провайдеров
  historical_usage.rs   Сбор данных об использовании из Prometheus для оптимизации запросов
  verifier.rs           Проверка решений через kube-scheduler-simulator
  server.rs             HTTP-сервер на Axum и SSE-стриминг
  service.rs            Оркестрация конвейера collect -> solve -> plan
  metrics.rs            Экспозиция метрик Prometheus
  state_cache.rs        Сохранение снимков для офлайн-анализа
Решатель работает как единый бинарный файл, обслуживающий одновременно API и одностраничную панель управления по адресу /.
Конфигурация
Панель управления открывает доступ ко всем параметрам решателя через панель «Advanced Settings». Основные опции:
| Параметр | По умолчанию | Описание |
|---|---|---|
CPU/Memory Headroom |
0% |
Резервировать ёмкость на каждом узле |
Overcommit Ratio |
1.0 |
Разрешить упаковку сверх запросов (1.0 = строго) |
Ignore Taints |
выкл. |
Рассматривать taint’ы как мягкие для анализа верхней границы |
Relax Anti-Affinity |
выкл. |
Допустить более плотную упаковку, смягчив anti-affinity |
Joint Rightsizing |
выкл. |
Совместно оптимизировать размеры запросов и размещение |
Usage-Adjusted Requests |
выкл. |
Заменить сырые запросы данными о потреблении из Prometheus |
Теневой режим GPU-планировщика
Теневой режим (shadow mode) следит за ожидающими GPU-подами с schedulerName: ksolver, вычисляет размещения и записывает трассировки решений. По умолчанию режим только для чтения: ни один под не привязывается, пока оператор явно не включит режим выката привязок (binding rollout mode).
Запуск теневого режима
KUBECONFIG=~/.kube/config \
KSOLVER_SHADOW_BATCH_SECONDS=10 \
cargo run --features rust-cp-sat -- shadow
Для локального теневого режима и демонстрационных запусков всегда указывайте --features rust-cp-sat. Без этого флага процесс запустится, но решатель будет недоступен: /readyz вернёт 503, а отчёты о размещении завершатся ошибкой.
Откройте http://127.0.0.1:8090/, чтобы проверить размещения, причины невозможности разместить поды, советы по исправлению, защитные шлюзы и доказательства сценариев.
Конечные точки для проверки работоспособности и управления
| Конечная точка | Назначение |
|---|---|
|
Живость процесса |
|
Готовность watch-соединения с Kubernetes и решателя |
|
Последние решения о размещении и предупреждения |
|
Предварительный просмотр полезной нагрузки |
|
Рекомендательный план миграции и вытеснения |
|
Шлюзы выката, готовность, RBAC и состояние мутаций |
|
Компактная сводка блокировок и следующих действий |
|
Качество модели VRAM и готовность к допуску |
|
Артефакты проверки и команды сбора |
|
Метрики Prometheus |
Панель управления объясняет, почему нагрузка не размещена, а не просто возвращает статус неудачи. Ошибки готовности классифицируются как таймаут API, проблемы с подключением, DNS, TLS или ошибки авторизации — и для каждой предлагается диагностическая команда.
Основная конфигурация
| Переменная | По умолчанию | Действие |
|---|---|---|
|
|
Имя планировщика, за которым следит теневой режим |
|
|
Задержка между пакетами решений |
|
|
Временной бюджет CP-SAT |
|
|
Адрес для панели управления и API |
|
все |
Список разрешённых пространств имён через запятую |
|
|
Точные имена ресурсов целых GPU |
|
|
Префиксы ресурсов, похожих на GPU |
|
нет |
Лимиты GPU по пространствам имён, например |
|
|
Количество узлов-кандидатов для каждой нагрузки; |
|
|
Сокращение симметрии однородных узлов |
|
|
Координация реплик через lease |
Helm-чарт предоставляет эти параметры через scheduler.* и проверяет режимы выката, профили целевых функций, окна решения и ограничения до развёртывания. Полный справочник конфигурации — в chart/values.yaml.
Семантика устройств
-
Целые GPU и объявленные MIG-профили (MIG profiles) используют точный учёт расширенных ресурсов Kubernetes. Запрос на один MIG-профиль не может быть удовлетворён другим профилем.
-
Аннотации
ksolver.dev/gpu-topology-keyиksolver.dev/gpu-topology-value(опциональные) применяют жёсткий фильтр по меткам узла.ksolver.dev/nvlink-domain— сокращённая запись для сопоставления по NVLink-домену. -
Заявки DRA (Device Resource Allocations) учитываются через консервативный скалярный счёт. Идентификаторы выделенных устройств вычитаются, но конкретный выбор устройства не фиксируется.
-
GPU с разделением по времени (time-sliced) помечаются как общие и неизолированные. Допустимое размещение не гарантирует изоляцию памяти или производительности.
Неподдерживаемая или приближённая семантика отражается в каждом решении в виде предупреждений и никогда не рассматривается как точное размещение устройств.
Планирование и политика
Теневой режим решает задачу размещения ожидающих нагрузок на остаточную ёмкость узлов с соблюдением ограничений выполнимости Kubernetes, которые поддаются моделированию. Это включает групповой допуск (gang admission), node affinity, topology spread, pod affinity/anti-affinity, квоты, MIG-ресурсы, соответствие VRAM и явные метки топологии GPU.
Предпочтительный affinity — это уточнение при равенстве стоимости. Обязательные pod affinity и anti-affinity применяются, когда их селекторы и топологические домены поддаются моделированию; неподдерживаемое поведение селекторов раскрывается в виде предупреждений.
Опциональные параметры политики включают:
-
веса приоритета и бизнес-ценности;
-
веса очередей и возраст очереди;
-
дедлайны и предсказанное время выполнения;
-
веса справедливого распределения по арендаторам и ежемесячные бюджеты;
-
историческое время выполнения и прогнозы пикового потребления VRAM.
Эти параметры носят рекомендательный характер, пока не включены соответствующие веса целевой функции или бюджетные ограничения. Трассировки фиксируют активный профиль целевой функции, веса, результат допуска и причину каждого откладывания.
Защитные механизмы масштабирования
Обрезка кандидатов уменьшает размер модели, а при подозрительных результатах автоматически расширяет набор. Установите KSOLVER_CANDIDATE_NODE_LIMIT=0 для решения на полном допустимом множестве. Параметр KSOLVER_CANDIDATE_WIDEN_MIN_ADMISSION_PERCENT управляет порогом расширения при низком допуске.
Группировка узлов включается вручную. Когда это безопасно, однородные физические узлы объединяются, решаются как группы с подсчётом, разворачиваются обратно в реальные узлы и проверяются. Если развёртывание завершается ошибкой, теневой режим откатывается к решению по физическим узлам.
В каждой трассировке указывается, был ли результат полным, групповым, расширенным, усечённым или резервным. Усечённые результаты с неизвестным регретом не считаются надёжным доказательством для масштабирования или заявлений о живой привязке.
Советы по исправлению
/api/scheduler/repair-plan разграничивает фрагментацию ресурсов и случай, когда нагрузка не умещается ни на одном GPU. Когда возможно, план предлагает миграции раньше вытеснений — при наличии эквивалентной свободной ёмкости — и учитывает:
-
доступность PodDisruptionBudget;
-
политики
safe-to-evict, do-not-disrupt, миграции и вытеснения; -
приоритет нагрузки, бизнес-ценность, срочность дедлайна и возраст очереди;
-
возраст контрольной точки, прогресс, время работы и настроенную стоимость прерывания.
Планы носят рекомендательный характер и не выполняют выселение, миграцию, вытеснение или привязку нагрузок.
Webhook допуска
POST /admission/scheduler-name принимает проверки admission.k8s.io/v1 Kubernetes и возвращает патч RFC 6902, который назначает schedulerName: ksolver подходящим GPU-подам. Существующее имя планировщика никогда не перезаписывается.
Helm-webhook по умолчанию отключён и требует TLS. Используйте KSOLVER_ADMISSION_OPT_IN_LABEL (или scheduler.admissionOptInLabel), чтобы требовать явную метку пода перед патчингом. Для DRA-подов этот opt-in обязателен, поскольку по одному только поду нельзя определить класс устройства.
helm upgrade --install ksolver ./chart \
  --namespace ksolver --create-namespace \
  --set runtime.mode=shadow \
  --set scheduler.admissionOptInLabel=ksolver.dev/schedule \
  --set admissionWebhook.enabled=true \
  --set admissionWebhook.url=https://ksolver-webhook.example.com/admission/scheduler-name \
  --set admissionWebhook.caBundle=<base64-ca-bundle>
Выкат привязок
Конечная точка плана привязок всегда работает только на чтение. Каждая предложенная привязка включает вердикт актуальности, проверяющий UID пода, владельца-планировщика, состояние ожидания, целевой узел и последнее допустимое множество узлов.
Фактическая привязка включается вручную:
KSOLVER_BINDING_ROLLOUT_MODE |
Поведение |
|---|---|
|
Клиент без возможности мутации |
|
Проверка API с |
|
Сохранять только кандидатов в пределах настроенного порога GPU |
|
Сохранять каждого готового кандидата, прошедшего финальные живые проверки |
Дополнительные параметры управления: KSOLVER_ENABLE_REAL_BINDING, KSOLVER_BINDING_KILL_SWITCH, KSOLVER_BINDING_LOW_RISK_MAX_GPUS и KSOLVER_MAX_BINDS_PER_PASS. Недопустимые режимы завершаются с ошибкой. Каждый кандидат перечитывается непосредственно перед привязкой; устаревшие, пересозданные, завершающиеся, уже привязанные или принадлежащие другому владельцу поды пропускаются.
Живая привязка также требует явного RBAC для create на pods/binding. Helm-чарт не предоставляет его без rbac.allowBindingMutations=true. Запись событий Kubernetes отдельно управляется параметрами KSOLVER_ENABLE_KUBERNETES_EVENTS и rbac.allowEventWrites=true.
Пример выката с низким риском:
helm upgrade --install ksolver ./chart \
  --namespace ksolver --create-namespace \
  --set runtime.mode=shadow \
  --set scheduler.bindingRolloutMode=bind-low-risk \
  --set scheduler.enableRealBinding=true \
  --set rbac.allowBindingMutations=true
Базовые линии и доказательства
Отчёты по сценариям сравнивают ksolver со стратегиями spread и binpack стандартного kube-scheduler. Результаты Volcano включаются только при наличии захваченной базовой линии с поддержкой gang-планирования. Каждое сравнение фиксирует, являются ли доказательства живыми, кэшированными или детерминированными; отсутствие доказательств симулятора не блокирует решение, но препятствует сильным сравнительным утверждениям.
Полезные команды:
# Диагностика работающего теневого сервиса
scripts/shadow-doctor.py \
  --base-url http://127.0.0.1:8090 \
  --require-kss-ready

# Запуск сквозного проверочного шлюза
scripts/demo-gate.py \
  --base-url http://127.0.0.1:8090 \
  --output-dir /tmp/ksolver-demo-gate \
  --json

# Сбор и проверка пакета доказательств
scripts/collect-evidence-bundle.py \
  --base-url http://127.0.0.1:8090 \
  --output-dir /tmp/ksolver-evidence
scripts/verify-evidence-bundle.py /tmp/ksolver-evidence
Для локальных базовых линий kube-scheduler-simulator используйте scripts/kss-pool.sh, чтобы запустить и проверить пул, а затем обновите кэш сценариев с помощью scripts/kss-cache-grind.sh. Теневой режим кэширует планы симулятора по сигнатуре ожидающих нагрузок, поэтому обновления панели управления не сбрасывают и не импортируют состояние симулятора повторно.
RBAC только для чтения
Стандартной теневой установке нужен только доступ на чтение:
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: ksolver-shadow-readonly
rules:
  - apiGroups: [""]
    resources: [pods, nodes, persistentvolumeclaims, persistentvolumes]
    verbs: [get, list, watch]
  - apiGroups: ["apps"]
    resources: [daemonsets, deployments]
    verbs: [get, list, watch]
  - apiGroups: ["storage.k8s.io"]
    resources: [storageclasses]
    verbs: [get, list, watch]
  - apiGroups: ["policy"]
    resources: [poddisruptionbudgets]
    verbs: [get, list, watch]
Права на create, update, patch, delete, eviction или pod-binding не предоставляются. Для более подробной информации о реализации и критериях приёмки см. проект теневого планировщика, проект поддержки DRA, проект базовой линии Volcano и дорожную карту frontier.
Соответствие выполнимости
ksolver conform проверяет, совпадает ли наша логика проверки выполнимости узлов с реальной фазой Filter стандартного kube-scheduler. Для каждого ожидающего пода и каждого (не заблокированного) узла команда получает два вердикта — наш (feasible_on_node) и планировщика — и сообщает о каждом расхождении:
KSOLVER_SCHEDULER_SIMULATOR_URL=http://localhost:8080 \
  ksolver conform --sample 20 --cluster my-cluster
-
Вердикт планировщика берётся из kube-scheduler-simulator: импортируется снимок ровно с одним узлом (без других подов) и самим подом; привязка пода к этому узлу означает, что Filter прошёл, а статус unschedulable — что не прошёл. Один узел изолирует Filter от Score.
-
Обе стороны проверяют сырую аллоцируемую ёмкость (пустой узел), поэтому резервирование для DaemonSet, переподписка и headroom — отдельные слои ksolver, не предикаты Filter — не искажают сравнение.
-
Поды с конструкциями, которые намеренно не моделируются в этом тесте Filter (обязательные pod affinity/anti-affinity, неподдерживаемые формы
DoNotScheduletopology spread и priority /priorityClassName), относятся к категории ожидаемых расхождений с подсчётом по причинам. Обязательный node affinity, включая OR-условия иmatchFieldsпоmetadata.name, относится к строгой категории. -
Точного совпадения требуют только поды из строгой категории. Результаты
FALSE-POSITIVE(мы считаем размещение допустимым, планировщик отклоняет) выводятся первыми — они наиболее опасны. Текстовый отчёт содержитstrict-gate: pass|fail;failозначает наличие хотя бы одного строгого ложноположительного результата. -
--jsonвыводит машиночитаемый отчёт с матрицами строгих и ожидаемых расхождений, списками несовпадений, подсчётом причин ожидаемых расхождений иstrict_gate_status. -
--fail-on-strict-false-positiveзавершается с ненулевым кодом после вывода отчёта при сбое строгого шлюза. Несовпадения ожидаемых расхождений остаются информационными и не активируют этот CI-шлюз. -
На реальном кластере только чтение; планирование выполняется только против симулятора (изолированной среды). Если URL симулятора не настроен,
conformвыводит сообщение о пропуске и завершается с кодом 0. При--jsonпуть пропуска выводит JSON-объект сskipped: true. -
Масштабирование на больших парках.
conformимеет сложность O(поды × узлы) — один цикл сброс/импорт/проверка симулятора на каждую пару (под, узел) — поэтому полный прогон на кластере с 100+ узлами выполняется долго. Два опциональных флага (значения по умолчанию не изменены) делают его управляемым:-
--max-nodes Nограничивает проверяемый набор кандидатов выборкой; в отчёте фиксируютсяnodes_evaluatedиnodes_total, и выводится пометка о выборочной проверке — выборочный прогон никогда не принимается за исчерпывающее покрытие. -
--dedup-nodesсохраняет полное точное покрытие, но проверяет только одного представителя каждого класса эквивалентности выполнимости (узлы с одинаковыми аллоцируемыми ресурсами, метками, задействованными подом, и taint’ами дают одинаковый вердикт Filter), распространяя вердикт на остальных. Для подов, чей вердикт может зависеть от неключевого атрибута (matchFields, PVC-тома), используется поузловая проверка — то есть метод может проверять больше, чем необходимо, но никогда не возвращает неверный вердикт. В отчёте отображаютсяsimulator_probesв сравнении с общим числом пар.
-
Примеры для CI:
KSOLVER_SCHEDULER_SIMULATOR_URL=http://localhost:8080 \
  ksolver conform --sample 20 --json --fail-on-strict-false-positive

KSOLVER_SCHEDULER_SIMULATOR_URL=http://localhost:8080 \
  ksolver conform --sample 20 --fail-on-strict-false-positive
Проверено в живую (2026-07-01) на самостоятельно собранном kube-scheduler-simulator под arm64 (v0.4.0 публикует только amd64-образы, которые падают при эмуляции на Apple Silicon — собирайте из исходников с docker buildx --platform=linux/arm64). conform отработал сквозным образом и выдал матрицу ошибок (согласие / ложноположительное / ложноотрицательное) с нулём ложноотрицательных. Примечание: путь с импортом одного узла может давать ложные ложноположительные результаты, когда импортированный узел не помечен как Ready внутри симулятора (KWOK самостоятельно управляет статусом импортированных узлов) — это оговорка о достоверности тестового стенда, а не проблема в моделировании Filter.
Обновление (2026-07-14): локальный пул симуляторов (scripts/kss-pool.sh) теперь надёжно выполняет полный цикл импорта/сброса/проверки — два бага KWOK apiserver, ранее нарушавших импорт подов (допуск ServiceAccount) и сброс /reset (несовпадение etcd-префикса), исправлены в этом скрипте. conform работает сквозным образом против пула, запускаемого одной командой, а --max-nodes/--dedup-nodes (см. выше) делают прогоны на больших парках управляемыми. Проверено на 113-узловом KWOK-кластере solver-lab: полный прогон и прогон с --dedup-nodes дали идентичные вердикты и расхождения, строгий шлюз прошёл успешно.
Заполнение хранилища истории VRAM
Предсказатель VRAM четвёртого уровня (tier-4 VRAM predictor) читает JSONL-хранилище измеренных пиковых значений потребления VRAM, индексированных по отпечатку рабочей нагрузки. ksolver vram-observe заполняет это хранилище из реального источника GPU-метрик — dcgm-exporter, опрашиваемого Prometheus:
ksolver vram-observe --store /var/lib/ksolver/vram.jsonl \
  --prometheus-url https://prom.example.com \
  [--prometheus-username <u> --prometheus-token <t>] [--window 24h] [--kubeconfig <path>]
Команда запрашивает пиковое потребление видеопамяти каждым подом (max_over_time(DCGM_FI_DEV_FB_USED{pod!=""}[<window>])), сопоставляет каждую метрику со спецификацией её пода для вычисления отпечатка, который использует предсказатель, и добавляет одну строку на каждый сопоставленный под. Учётные данные также можно передать через KSOLVER_PROMETHEUS_{URL,USERNAME,TOKEN}. Команда требует живого Prometheus и ничего не записывает, если экспортер не сообщает о совпадающих рядах — наблюдения никогда не фабрикуются. Запускайте по расписанию (например, через CronJob), чтобы предсказания четвёртого уровня были основаны на реальном потреблении.
Лицензия
MIT