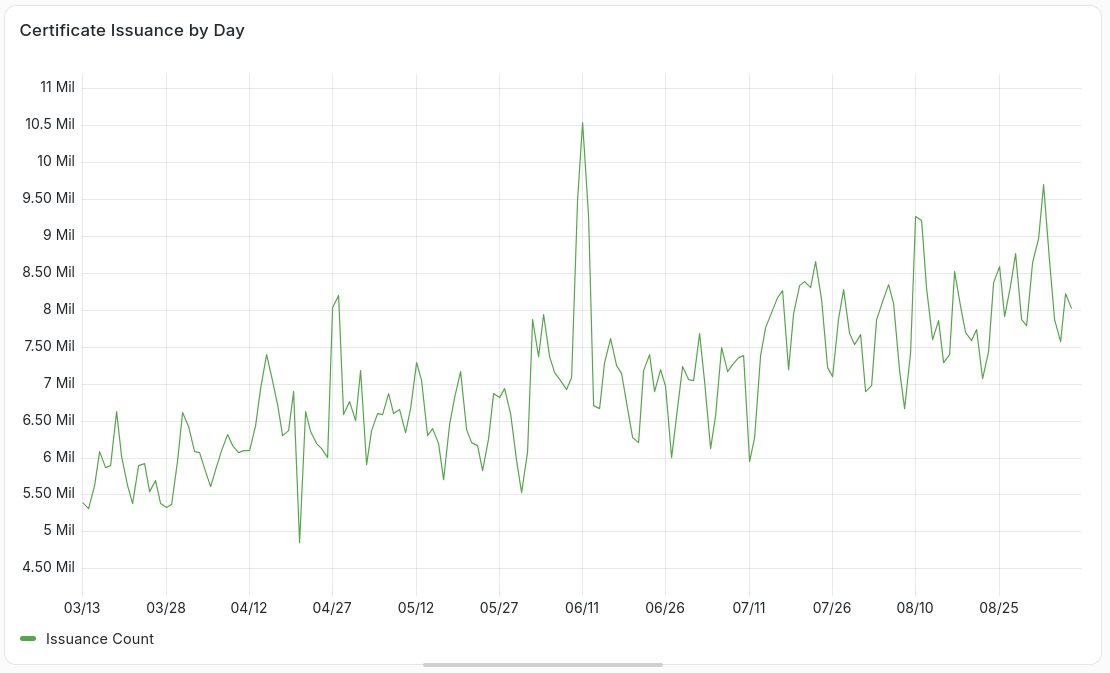
Когда скрипты, формирующие данные для letsencrypt.org/stats, сломались в очередной раз, мы решили от них отказаться, а не чинить снова. Let’s Encrypt выпускает от шести до десяти миллионов сертификатов в день, что порождает непрерывно растущий поток логов. Отвечать на вопросы о собственной работе — например, «сколько сертификатов используют профиль shortlived» — становилось всё сложнее и затратнее по времени. Поиск по сырым логам требует нахождения, разбора и извлечения нужных фрагментов из каждой строки. Запрашивать базу данных нашего API выдачи тоже нельзя: она оптимизирована для транзакций, а не для аналитики. Мы также пользовались SaaS-продуктом для поиска по логам, однако счета росли куда быстрее, чем нам хотелось, а с аналитическими задачами он справлялся плохо. Мы понимали, что можно сделать значительно лучше.
Это подтолкнуло нас к поиску самостоятельно размещаемого (self-hosted) решения, способного эффективно хранить как структурированные данные, так и логи. Мы выбрали ClickHouse как платформу для хранилища данных (data warehouse): нас привлекло сочетание экономичного хранения и быстрой агрегации на больших объёмах. Дополнительный плюс ClickHouse — открытый исходный код, что соответствует ключевым принципам Let’s Encrypt.
Первым шагом стала закупка нового оборудования. Для поддержки хранилища ClickHouse мы приобрели три сервера PowerEdge R7715. Каждый оснащён 32-ядерным процессором AMD EPYC 9355P с тактовой частотой 3,55 ГГц, 384 ГБ оперативной памяти и 32 NVMe-накопителями по 3,2 ТБ — итого около 100 ТБ сырого хранилища. Уже имея в базе структурированные данные и логи за 100 дней, мы используем лишь ~14% от общей ёмкости, что оставляет большой запас для роста.
Основной объём хранилища занимают логи — они же служат фундаментом для всех структурированных данных, поскольку остальные таблицы строятся на их основе. Для поиска по логам ClickHouse покрывает базовые потребности: быстрая загрузка и интерактивный SQL. Тем не менее в части удобства запросов есть что улучшить — например, задействовать функции трассировки OpenTelemetry и настройки токенизации ClickHouse.
Главной целью в части структурированных данных стали записи о выдаче сертификатов. Материализованное представление (materialized view) извлекает эти записи из логов в отдельную таблицу, а дальнейшие представления заранее агрегируют эти данные. Одно из них считает количество выдач по дням в разрезе профилей. Теперь вопросы вроде «какова наша выдача по профилю за последние 180 дней» решаются за миллисекунды.
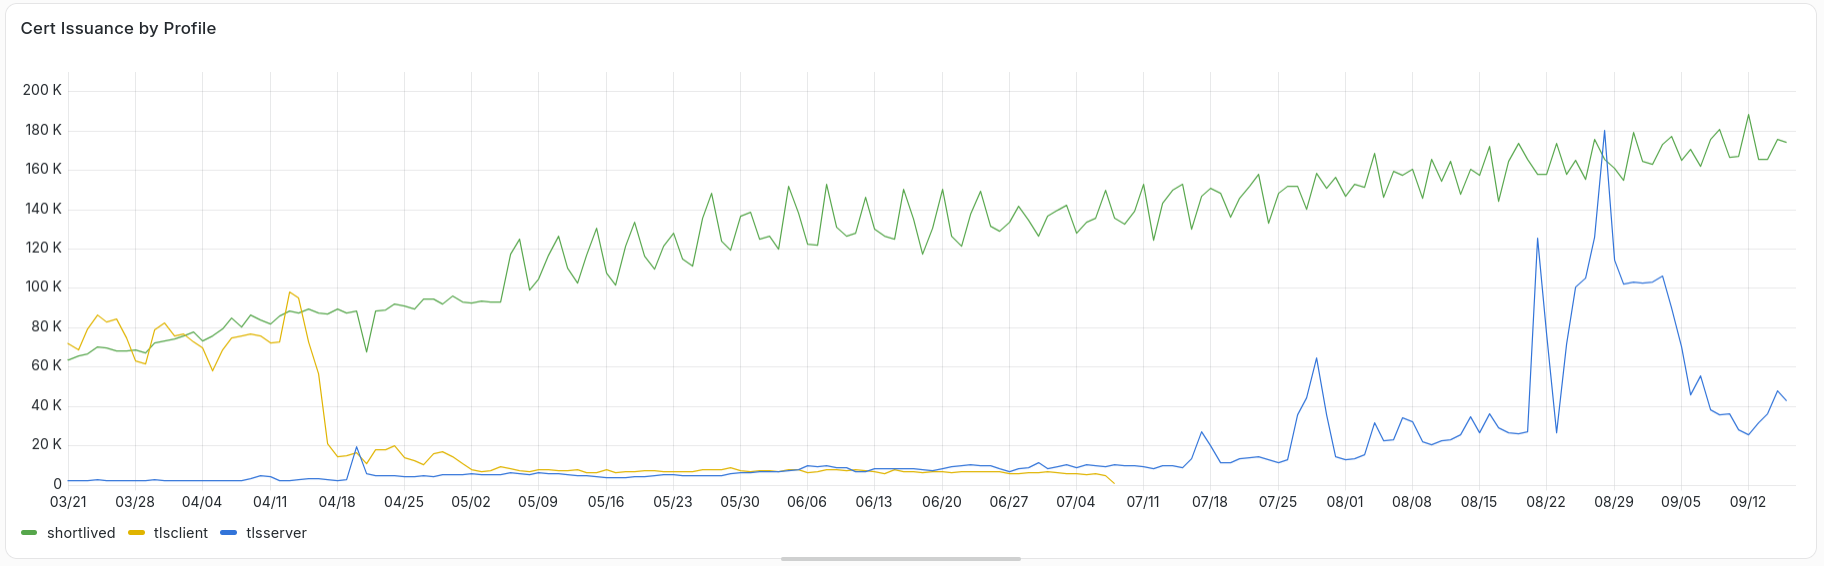
Этот подход позволил нам полностью перестроить конвейер для публичной страницы статистики. Заброшенные скрипты ежедневно часами читали и обрабатывали десятки сжатых файлов с данными. Этот запутанный многоступенчатый процесс давал сбои несколько раз в год и требовал нашего вмешательства. ClickHouse вычисляет ту же статистику менее чем за 10 секунд. Помимо предварительно агрегированных таблиц выдачи, это стало возможным благодаря встроенным функциям ClickHouse, способным выполнять быстрые и сложные агрегации. Ниже приведён упрощённый фрагмент нашего материализованного представления для ежедневной статистики: оно считает уникальное множество активных доменов за несколько месяцев по миллионам строк. Стоит отметить два момента: работа с массивами позволяет запрашивать вложенные поля без изменения структуры исходных данных, а uniq использует приближённые вычисления для сохранения скорости на больших объёмах.
SELECT
uniq(arrayJoin(arrayMap(x -> x.value, arrayFilter(x -> x.type = 'dns', identifiers)))) AS fqdns_active,
uniq(arrayJoin(etld_plus_one)) AS reg_domains_active
FROM boulder.cert_issuances
WHERE not_before >= yesterday() - 90
AND not_after >= yesterday()
AND not_before <= yesterday()
Данные о выдаче из ClickHouse также решают давнюю проблему — выявление затронутых сертификатов при инцидентах. Раньше на то, чтобы правильно просканировать и разобрать логи в поисках нужного набора серийных номеров, уходили часы инженерного времени; запросы к базе данных тоже выполнялись часами и конкурировали с производственной транзакционной нагрузкой. Теперь никакой возни с логами нет, а поскольку запросы возвращают результат быстро, мы можем итеративно уточнять нужный запрос за минуты, а не часы.
Часть необходимого функционала пришлось создавать самостоятельно. Для плановых отчётов мы написали собственный инструмент, который запрашивает ClickHouse и экспортирует отформатированные результаты. Это потребовало дополнительных инженерных затрат, однако уже окупилось. Старые отчёты были неудобны для чтения и требовали ручного поиска контекста. Новые, напротив, упрощают проверки безопасности благодаря аккуратному форматированию и прямым ссылкам на нужные страницы. Тот же инструмент отчётности был повторно использован для обновлённого конвейера статистики.
Наибольшей сложностью оказалась обратная загрузка (backfilling) исторических данных. OTel collector отлично справляется с потоковой загрузкой логов в реальном времени, однако для массового импорта истории он не подошёл. Найти настройки троттлинга, при которых массовый импорт работал надёжно, не удалось: значительная часть файлов молча терялась, а альтернатива предполагала ручное разбиение импорта на части. В итоге мы перешли на нативный метод импорта из S3, подняв S3-совместимый шлюз перед нашими старыми логами. Хотя это позволило обойти прежние трудности, процесс потребовал проб и ошибок: нужно было согласовать правила разбора при загрузке с правилами OTel collector, чтобы обработка логов давала одинаковый результат независимо от способа попадания данных в базу. Два вывода: не прогоняйте массовый исторический импорт через потоковый коллектор и согласуйте правила разбора по всем путям загрузки до начала работы.
Одно решение по схеме данных сделало эти итерации дешёвыми. Для таблиц, которые, по нашим ожиданиям, потребуют повторной загрузки или пересчёта, мы намеренно выбрали движок ReplacingMergeTree, благодаря чему повторная загрузка исправленных строк просто заменяла старые. Это также пригодилось при работе с материализованным представлением, вычисляющим агрегаты по другим строкам. Мы не раз ошибались в расчётах, и каждый раз достаточно было перезапустить запрос, а не удалять некорректные строки точечно. Для таблиц без этого движка мы применяли OPTIMIZE TABLE … DEDUPLICATE BY, что обходилось дорого, но требовалось лишь однократно.
Мы надеемся, что это только начало — особенно с учётом предстоящих сокращения срока действия сертификатов и постквантовых сертификатов. Мы планируем в полной мере использовать возможности нового хранилища: извлекать и предварительно агрегировать данные, отвечающие на вопросы других команд, — так же, как мы сделали это для статистики выдачи. Более глубокая аналитика улучшает нашу работу и снижает стоимость обеспечения прозрачности, что наглядно демонстрирует обновлённая страница статистики.
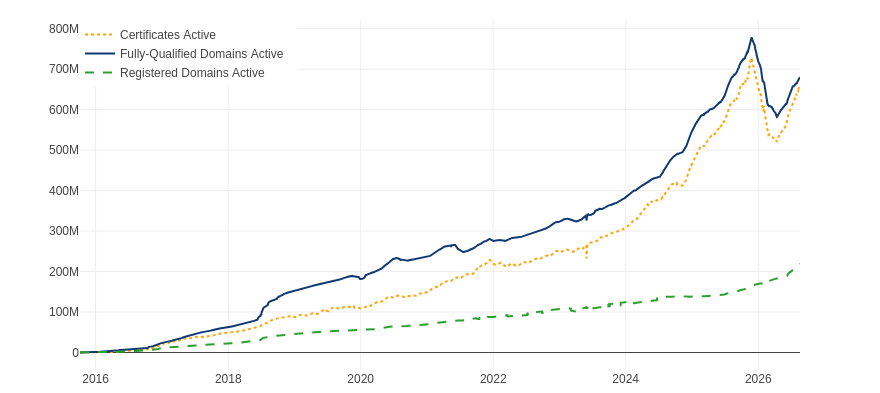
Имея в распоряжении мощную аналитику и используя лишь ~14% хранилища, мы можем хранить и анализировать данные в объёмах, недоступных прежде.