Вот сценарий, который я проживал чаще, чем готов признать.
У вас запущено десять агентов Claude Code. Каждый работает над отдельной задачей. Агент 3 только что создал PR, который конфликтует с изменениями агента 7. Агент 5 застрял на «Analyzing codebase…» уже 45 минут. Агент 9 час назад завершил работу, но его PR так и висит без ревью. А агент 2 только что сделал force-push поверх ветки агента 6.
Добро пожаловать в хаос мульти-агентных систем. Оказывается, масштабирование ИИ-агентов с одного до десяти и более — это принципиально иная задача, чем запуск одного агента в терминале. Счастливый путь с одним агентом хорошо задокументирован. Режимы отказа при работе с несколькими агентами — нет.
Проблема, о которой никто не предупреждает
Когда работает один агент, поверхность отказов управляема. Вы смотрите в терминал, вмешиваетесь, когда что-то идёт не так, и мержите PR, когда он готов. Всё просто.
Запустите десять агентов одновременно — и всё начнёт ломаться по-новому:
-
Агенты зависают, но не падают. Процессы продолжают работать, потребляют ресурсы, логи выглядят нормально — но «Analyzing codebase…» остаётся последней строчкой статуса уже два часа.
-
Конфликты при слиянии (merge conflicts) нарастают как лавина. Агент A делает merge. Теперь у агента B конфликты. B их разрешает. Теперь конфликты у C.
-
Состояние исчезает. Вы управляете агентами через несколько терминалов, сессии tmux или shell-скрипты. Машина перезагружается — и вы теряете всё.
-
Никто не понимает, что происходит. Какой агент работает над какой задачей? Есть ли хоть какой-то прогресс? Этот PR вообще когда-нибудь смержат?
Я перепробовал очевидные подходы: bash-скрипты, tmux-сессии, собственные вебхуки. Все они ломались одинаковым образом — у них не было концепции состояния. Когда что-то шло не так, невозможно было понять, что уже сделано, что в процессе и где нужно вмешаться.
Именно тогда я посмотрел на проблему иначе. Оркестрация мульти-агентных ИИ-систем — это не новая задача. Это распределённые системы. А у распределённых систем есть проверенное временем решение: Kubernetes.
Почему Kubernetes? (Да, я понимаю)
Желание отмахнуться от этой идеи понятно. «Kubernetes для ИИ-агентов? Серьёзно?» У меня тоже был такой инстинкт.
Но подумайте, что на самом деле нужно, чтобы надёжно запускать агентов в масштабе:
-
Декларативное состояние (описываете что хотите получить, а не как этого достичь)
-
Самовосстановление (обнаружение сбоев и автоматическое восстановление)
-
Изоляция ресурсов (хаос одного агента не влияет на других)
-
Персистентное состояние (переживает перезапуски, отказы узлов — всё что угодно)
-
Наблюдаемость (события, метрики, условия — полноценный журнал аудита)
-
Планировщик (грамотное распределение нагрузки по вычислительным узлам)
Это не список пожеланий. Это Kubernetes. Из коробки. Поддерживаемый тысячами инженеров на протяжении десяти лет.
Альтернатива — строить всё это самостоятельно. Я видел, как команды пытаются. Зрелище неприятное.
Что мы построили: пять пользовательских ресурсов
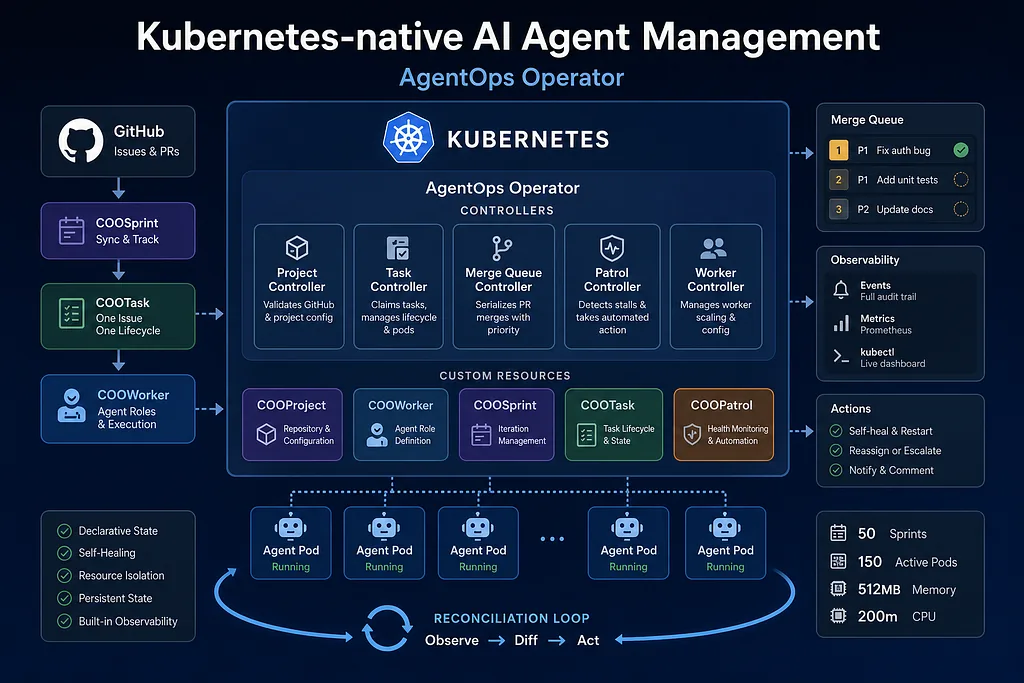
Оператор AgentOps расширяет Kubernetes пятью типами ресурсов, каждый из которых соответствует реальной концепции из ИИ-ассистированной разработки.
COOProject представляет репозиторий GitHub и его конфигурацию: какие воркеры существуют, какие метки использовать для отслеживания спринтов, как подключиться к GitHub. Контроллер проверяет доступность GitHub, убеждается, что метки существуют, и непрерывно согласует (reconcile) состояние проекта.
COOWorker описывает роль агента — backend-инженер, devops-инженер, QA-инженер. Он задаёт, какие метки GitHub-задач направляются к этому типу воркера, какой шаблон пода использовать, лимиты ресурсов, границы масштабирования (включая масштабирование до нуля в период простоя) и поведение при повторных попытках.
COOSprint управляет итерацией. Он синхронизирует GitHub-задачи с меткой current-sprint, создаёт для каждой задание (task), направляет их нужным воркерам по совпадению меток и отслеживает прогресс. У него также есть лимит итераций — жёсткий потолок, предотвращающий бесконечные циклы, когда агенты застревают в цепочке «ревью → правка → ревью → правка».
COOTask — атомарная единица: одна задача, один воркер, один жизненный цикл. Ему принадлежит конечный автомат переходов: Pending → Claimed → Running → PendingReview → Merging → Completed. Он отслеживает PR, счётчик повторных попыток, имя пода, аннотации прогресса от работающего агента. Когда что-то идёт не так — задание об этом знает.
COOPatrol — монитор здоровья. Он запускается по расписанию (cron), проверяет каждое выполняющееся задание на признаки зависания (нет коммитов за 60 минут, нет созданного PR спустя 90 минут, нет обновления аннотации прогресса за 30 минут) и принимает меры. Перезапустить, переназначить, эскалировать — настраивается для каждого проекта отдельно.
Та самая ключевая часть: захват задания (task claiming)
Конкурентные контроллеры — это задача координации. Несколько экземпляров TaskController могут одновременно попытаться захватить одно и то же ожидающее задание. Наивное решение — распределённая блокировка. Kubernetes-решение — оптимистичный контроль параллелизма (optimistic concurrency control).
Когда контроллер хочет захватить задание, он генерирует UUID, записывает его в status.claimToken и отправляет обновление. Если два контроллера делают это одновременно, Kubernetes возвращает HTTP 409 (Conflict) проигравшему. Проигравший немедленно помещает запрос обратно в очередь и пробует другое задание. Никаких блокировок, никакой координации, никаких дедлоков.
Это один из тех паттернов, который поначалу кажется почти слишком простым — а потом понимаешь, что именно для этого Kubernetes и проектировался.
Обнаружение зависших агентов
Самой сложной проблемой оказалась не конкурентность. Самое сложное — обнаружить, когда агент перестал двигаться вперёд, не упав при этом.
Упавший под — дело простое. Kubernetes перезапустит его, TaskController обнаружит увеличение счётчика перезапусков и пометит задание как зависшее. Готово.
Заторможенный агент — история тонкая. Под здоров. Логи идут. Но «Generating tests…» не менялось на экране уже два часа, а новых коммитов так и нет.
COOPatrol решает это с помощью нескольких эвристик: нет git-коммитов за N минут, нет созданного PR спустя N минут, нет обновления аннотации прогресса за N минут, счётчик перезапусков пода превысил порог. Любое из этих условий может запустить вмешательство. Вмешательство может быть перезапуском (убить под, очистить токен захвата, дать заданию быть захваченным снова), переназначением другому типу воркера или эскалацией (добавить метку blocked, оставить комментарий в GitHub, уведомить человека).
Механизм «сердцебиения» агента прост: рабочий под каждые несколько минут обновляет аннотацию пода с текущим шагом и процентом прогресса. TaskController следит за этими аннотациями. Если они перестают обновляться — Patrol это замечает.
Очередь слияния: превращаем хаос в порядок
Десять параллельно работающих агентов рано или поздно захотят слиться одновременно. Когда агент A делает merge, PR агента B может получить конфликты. Когда B разрешает их и делает merge, конфликты появляются у C. И так далее.
Решение, к которому мы пришли, — это последовательная очередь слияния (merge queue) с приоритетной сортировкой. MergeQueueController находит все задания в состоянии PendingReview, сортирует их по приоритету (сначала P1) и выполняет по одному слиянию за цикл согласования. Перед слиянием контроллер проверяет, что PR допускает слияние (нет конфликтов), CI прошёл и необходимые ревью получены. Если у PR есть конфликты, задание переходит обратно в состояние Running — агент получает новый под с инструкцией выполнить rebase и разрешить конфликты.
Ничего изощрённого. Но это работает, и схема понятна. Состояние всегда видно в ресурсах заданий.
Наблюдаемость, которая достаётся бесплатно
Один из неожиданных бонусов от работы поверх Kubernetes: наблюдаемость идёт в комплекте.
Каждый переход состояния порождает событие Kubernetes (Kubernetes Event). Можно смотреть поток событий для неймспейса и наблюдать всю активность системы в реальном времени — задание захвачено, под создан, PR открыт, запрошено ревью, обнаружены конфликты, задание перезапущено. Полный журнал аудита, без дополнительных усилий.
Метрики Prometheus публикуют длительность выполнения заданий по типу воркера и результату, количество активных подов, остаток лимита запросов к GitHub API, процент выполнения спринта. Стандартный ServiceMonitor для сбора метрик.
А kubectl get tasks,workers,sprints -n coo-my-app -o wide даёт живой дашборд, который любой специалист по Kubernetes уже умеет читать.
Что это заменило
Картина до: десять вкладок терминала, bash-скрипт, который может быть перезапустит упавших агентов, доска в Notion с отметками, какой агент на какой задаче, и я, вручную поглядывающий на GitHub в ожидании новых PR.
Картина после: kubectl apply -f sprint.yaml — и можно уходить. Система сама захватывает задания, запускает поды, следит за прогрессом, обнаруживает зависания, управляет очередью слияния и закрывает задачи после слияния PR. Задача человека сводится к ревью PR и обработке эскалаций — а не к присмотру за агентными процессами.
В масштабе — 50 параллельных спринтов, 150 активных рабочих подов — сам контроллер потребляет около 512 МБ памяти и 200m CPU. Kubernetes создан для такой нагрузки.
Когда это избыточно
AgentOps Operator требует наличия кластера Kubernetes. Если его нет, операционные накладные расходы на его развёртывание, скорее всего, перевесят пользу для небольших нагрузок. Если вы запускаете несколько агентов для исследовательской работы — просто используйте терминал.
Но если вы запускаете агентов непрерывно, координируете параллельную работу над реальной кодовой базой и нуждаетесь в том, чтобы работа выполнялась надёжно без постоянного надзора — цикл согласования перестаёт быть избыточностью и становится очевидным ответом.
Паттерн контроллера Kubernetes существует потому, что люди на собственном болезненном опыте обнаружили: декларативное управление состоянием с самовосстанавливающимся согласованием — это правильная модель для распределённых длительно выполняющихся рабочих нагрузок.
ИИ-агенты — это распределённые длительно выполняющиеся рабочие нагрузки.
Вывод напрашивается сам.
Я создаю AgentOps Operator — нативную для Kubernetes платформу оркестрации ИИ. Если эта тема вас задела — следите за обновлениями.