Ballast — это Kubernetes-оператор, который автоматически подбирает оптимальные значения запросов (requests) и лимитов (limits) ресурсов для рабочих нагрузок, опираясь на реальную историю эксплуатации. Это более активная альтернатива Fairwinds Goldilocks: вместо того чтобы предлагать изменения, Ballast применяет их — на этапе допуска (admission time) и на работающих подах через механизм изменения ресурсов без перезапуска (in-place resize, Kubernetes 1.35+).
Что делает Ballast
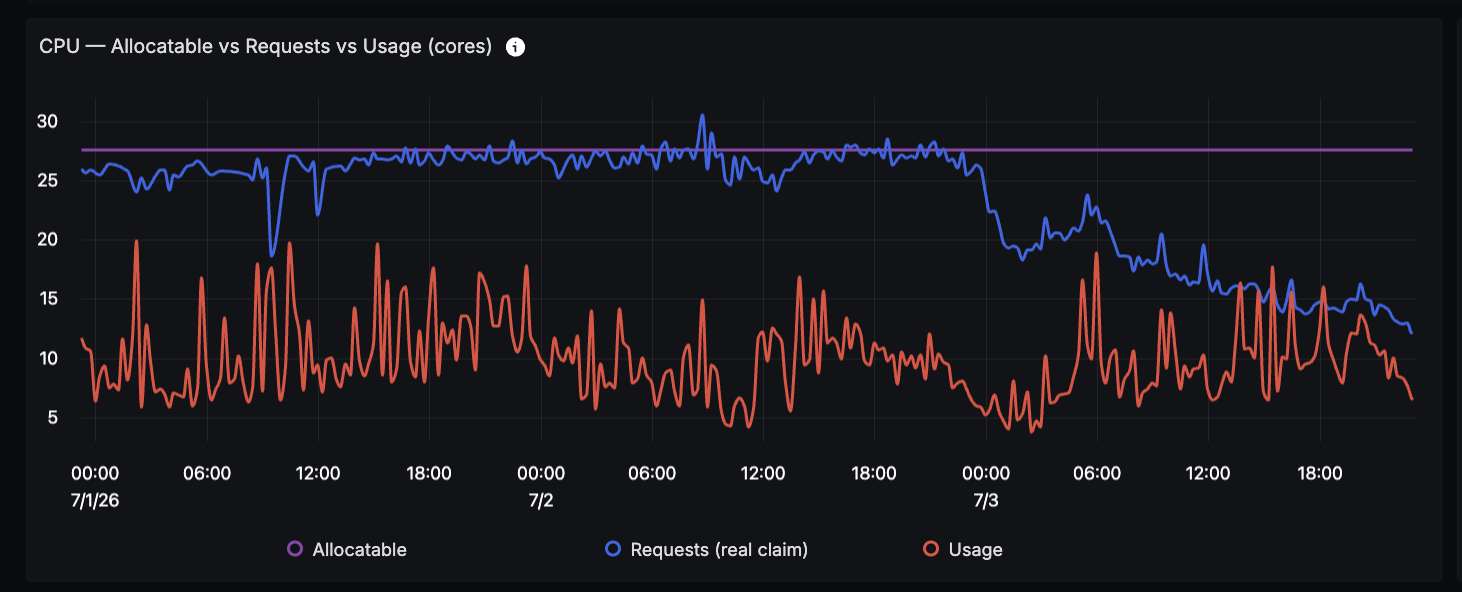
На графике показан CPU одного кластера за три дня. Фиолетовая линия — выделенная ёмкость (allocatable capacity); синяя — суммарные запросы подов, то есть то, что планировщик считает занятым; красная — сколько ресурсов поды реально потребляют.
Первые два дня запросы упираются в потолок. На бумаге кластер заполнен и не может разместить ни одного нового пода, хотя реальное потребление составляет меньше половины от зарезервированного. Этот разрыв — чистые потери: мощности оплачены, зарезервированы и не используются.
В середине 3 июля рабочие нагрузки подключают к Ballast. Запросы падают до уровня наблюдаемого потребления, освобождая примерно половину планируемого CPU кластера — без единого вмешательства в работающие поды. Именно это и есть суть: те же узлы теперь вмещают значительно больше работы, или ту же работу можно выполнять на меньшем числе узлов.
Почему не просто использовать VPA?
Vertical Pod Autoscaler — очевидный инструмент для этой задачи, и для единственной стабильной долгоживущей нагрузки он хорошо справляется. Ballast появился потому, что VPA привязывает историю потребления к идентификатору конкретной нагрузки в конкретном пространстве имён, и три типичные ситуации уничтожают эту историю, заставляя начинать с нуля:
-
Холодный старт. VPA учится на пустом месте. Его рекомендатор накапливает потребление в затухающих гистограммах (память — в 24-часовых пиковых окнах за 8 дней по умолчанию), поэтому у только что развёрнутой нагрузки нет ни одного семпла, и она получает рекомендацию с низкой достоверностью и намеренным запасом, пока не накопятся дни реального трафика.
-
Нет кросс-namespace памяти. VPA ключует историю по кортежу
(namespace, имя контейнера, метки пода), и этот ключ нельзя настроить — он формируется автоматически, а объект VPA сам является namespace-scoped, поэтому физически не может агрегировать поды из другого пространства имён. Разверните то же приложение (service: billing,component: backend-api,profile: dev) во втором namespace — например, в тестовом окружении другого разработчика — и namespace в ключе изменится, а VPA увидит совершенно новую нагрузку и начнёт с нуля. Каждый namespace заново изучает одно и то же приложение независимо. Холодный старт снова. -
Разрыв при повторном развёртывании. История нагрузки хранится в чекпоинтах объекта VPA (ресурсы
VerticalPodAutoscalerCheckpoint, принадлежащие этому объекту). Удалите нагрузку вместе с её VPA-объектом — как это делает любой GitOps-снос илиhelm uninstall— и Kubernetes удалит чекпоинты вместе с ним. Разверните снова через минуту — истории не останется. Холодный старт в третий раз.
Ballast решает все три проблемы, отделяя историю от объекта нагрузки. Он ключует потребление по кортежу идентификатора нагрузки (workload identity tuple), который вы выбираете сами (набор меток пода; см. WorkloadProfile Identity), и хранит его в Redis/Valkey на уровне всего кластера, независимо от namespace и жизненного цикла любой отдельной нагрузки. Сорок dev-namespace с одним и тем же приложением вместе формируют один хорошо заполненный профиль, поэтому новое развёртывание — в свежем namespace или сразу после сноса — наследует накопленную историю всего парка и получает корректные размеры с самого первого допуска, не обучаясь заново с нуля.
Как это работает
Нагрузки подключаются одной меткой на шаблоне пода. Ballast отслеживает реальное потребление CPU, памяти и эфемерного хранилища (ephemeral-storage), накапливает скользящую историю, ключованную по кортежу идентификатора нагрузки (набор меток пода по вашей конфигурации), и использует эту историю для подбора оптимальных значений всех трёх ресурсов по нарастающей лестнице поведений:
-
measure — собирать семплы потребления каждого контейнера в хранилище временны́х рядов (Redis/Valkey).
-
apply — также патчить запросы и лимиты на этапе допуска при создании пода (включает measure).
-
resize — также корректировать ресурсы на работающих подах через API in-place resize Kubernetes (1.35+) (включает apply).
Уровень выбирается меткой ballast.tightlinesoftware.com/mode; каждый уровень включает всё нижестоящее. Ничего не применяется и не меняется до тех пор, пока WorkloadProfile не достигнет порога готовности — это стандартное поведение для любой нагрузки с включённым resize.
Выселение подов (pod eviction) для перебалансировки кластера выполняет Kubernetes Descheduler — подробности в разделе «Подключение».
Требования
-
Kubernetes 1.35+ (обязателен для in-place resize; более ранние версии поддерживают measure и apply, но не resize)
-
metrics-server, установленный в кластере (источник CPU и памяти; потребление эфемерного хранилища поступает из kubelet Summary API и не требует дополнительных компонентов)
-
TLS-сертификат для admission webhook (см. Webhook TLS ниже)
-
Redis-совместимое хранилище (Ballast поставляется со встроенным Valkey через Helm; подойдёт и существующий Redis или Valkey). Встроенный Valkey по умолчанию сохраняет данные в PersistentVolumeClaim на стандартном StorageClass кластера, так что накопленная история переживает перепланировку подов. Если в кластере нет стандартного StorageClass, задайте
valkey.dataStorage.classNameс нужным классом; иначе установка и обновление завершатся ошибкой (см. Замечания по обновлению). Значения памяти и хранилища по умолчанию невелики и связаны между собой, поэтому масштабируйте их вместе (см. аннотированный блокvalkey:вvalues.yaml).
Установка
В кластере должен быть предварительно установлен cert-manager (Ballast его не устанавливает):
helm install ballast oci://ghcr.io/tight-line/charts/ballast \
  --namespace ballast-system \
  --create-namespace
Команда загружает последний подписанный чарт из GitHub Container Registry. Чтобы зафиксировать версию, добавьте --version <X.Y.Z> (все версии перечислены на странице релизов). Для кластеров с повышенными требованиями к цепочке поставок проверьте подпись чарта перед установкой и рассмотрите принудительную проверку на этапе допуска (examples/admission).
Чарт поставляется с разумным значением по умолчанию для ballastConfig.identityLabels (app.kubernetes.io/name + app.kubernetes.io/component). Прочитайте раздел ниже, прежде чем менять это значение — выбор затрагивает весь кластер.
Обновления выполняются через helm upgrade --install ballast oci://ghcr.io/tight-line/charts/ballast без дополнительных шагов. CRD синхронизируются автоматически: сам Helm никогда не обновляет директорию crds/, поэтому чарт запускает хук-задачу (Job) перед установкой и обновлением (ballastd apply-crds), которая применяет манифесты CRD, встроенные в образ оператора, через server-side apply. Установите crds.upgradeHook.enabled: false, чтобы отказаться от этого, если CRD управляются внешними инструментами; в таком случае вы сами отвечаете за применение config/crd/bases/ при каждом обновлении.
Замечания по обновлению
UPGRADE FAILED … PersistentVolumeClaim "ballast-valkey" is invalid: spec.resources.requests.storage: Forbidden: field can not be less than status.capacity (#89). Kubernetes отклоняет любое обновление PVC, в котором запрашивается меньше текущей ёмкости тома, а Helm повторно отправляет этот запрос при каждом обновлении. В ранних чартах для хранилища Valkey запрашивалось 192Mi, и большинство облачных StorageClass (EBS, GCE PD, Azure Disk) округляют это значение до минимума в 1Gi, поэтому каждое последующее обновление падало на PVC даже без каких-либо изменений. В Helm 4 остальная часть релиза всё равно применяется, а релиз лишь помечается как failed; в Helm 3 обновление останавливается на середине. Значение по умолчанию теперь 1Gi, и чарт проверяет текущий PVC перед применением: если он больше valkey.dataStorage.requestedSize, обновление сразу завершается с ошибкой, указывая точное значение для установки. Чтобы исправить вручную:
kubectl -n ballast-system get pvc ballast-valkey -o jsonpath='{.status.capacity.storage}'
helm upgrade --install ballast oci://ghcr.io/tight-line/charts/ballast \
  --namespace ballast-system \
  --set valkey.dataStorage.requestedSize=<that value>
Сохраняйте это значение (или большее) в своих values с этого момента. Не уменьшайте его в дальнейшем.
Обратная ситуация тоже может заблокировать обновление. На StorageClass без минимального размера (local-path, NFS, стандартный класс kind) существующая установка имеет PVC на 192Mi, а новое значение по умолчанию в 1Gi просит Kubernetes расширить его. Это работает только при наличии allowVolumeExpansion: true у класса; в противном случае чарт завершается ошибкой до применения, называя --set valkey.dataStorage.requestedSize=<capacity>, которое сохранит существующий том. Альтернативно — удалите PVC и удерживающий его под Valkey, тогда следующее обновление создаст новый том на 1Gi (хранилище начнётся пустым).
Отсутствие стандартного StorageClass (#90). PVC без указанного класса создаётся заново только при наличии в кластере стандартного StorageClass. Без него Kubernetes привяжет PVC к любому свободному PersistentVolume подходящего размера — как правило, созданному для другого приложения, с его же политикой удержания. Теперь чарт отказывается устанавливаться или обновляться в такой ситуации (он проверяет наличие StorageClass с аннотацией storageclass.kubernetes.io/is-default-class: "true"). Задайте valkey.dataStorage.className с нужным классом или назначьте стандартный класс в кластере. Это также блокирует обновления существующей установки на таком кластере, чьё хранилище может уже находиться на томе, не предназначенном для него: проверьте kubectl -n ballast-system get pvc ballast-valkey -o wide и его PersistentVolume перед принятием решения; помните, что перемещение хранилища на новый класс означает удаление и пересоздание PVC, что сбросит накопленные данные всего парка (24 часа по умолчанию). valkey.dataStorage.useClusterDefaultClass: true (по умолчанию) указывает чарту, что пустой className означает «стандартный класс кластера»; если установить это в false без указания className, чарт откажется рендериться — это способ принудительно требовать явного указания класса при каждой установке. Проверка StorageClass требует живого кластера, поэтому helm template и клиентский --dry-run её пропускают; --dry-run=server выполняет её. То же относится к GitOps-инструментам, рендерящим чарт через helm template (например, Argo CD): там защитные проверки хранилища никогда не срабатывают, поэтому на кластерах без стандартного класса явно указывайте className. Защитные механизмы читают Namespace kube-system, StorageClasses и PVC Valkey, поэтому сущность, выполняющая helm, должна иметь право get на namespaces, get и list на storageclasses и get на persistentvolumeclaims в namespace релиза; без этих прав рендер завершится ошибкой разрешений lookup вместо пропуска проверки. Установка Ballast уже требует кластерных прав для CRD и ClusterRoles, поэтому это редко требует дополнительных разрешений.
Проверка релиза
Образ контейнера (ghcr.io/tight-line/ballast) и Helm-чарт (ghcr.io/tight-line/charts/ballast) подписаны без ключа (keyless) с помощью cosign через GitHub OIDC и публичную инфраструктуру sigstore. Открытого ключа нет; проверка подтверждает, что артефакт подписан рабочим процессом релиза Ballast.
IDENTITY='^https://github\.com/Tight-Line/ballast/\.github/workflows/release\.yml@refs/tags/v'
ISSUER=https://token.actions.githubusercontent.com

# container image
cosign verify ghcr.io/tight-line/ballast:<tag> \
  --certificate-identity-regexp "$IDENTITY" \
  --certificate-oidc-issuer "$ISSUER"

# Helm chart
cosign verify ghcr.io/tight-line/charts/ballast:<version> \
  --certificate-identity-regexp "$IDENTITY" \
  --certificate-oidc-issuer "$ISSUER"
Образ также содержит аттестацию сборочного провенанса SLSA и SBOM; в SECURITY.md приведён полный набор команд для проверки. Чтобы кластер допускал только образы, прошедшие эту проверку, см. examples/admission.
Старые релизы
Ballast распространяется как подписанные OCI-артефакты из GitHub Container Registry: образ оператора по адресу ghcr.io/tight-line/ballast и Helm-чарт по адресу ghcr.io/tight-line/charts/ballast. Релизы вплоть до v0.4.x также публиковались в Helm-репозиторий на GitHub Pages по адресу https://tight-line.github.io/ballast. Этот репозиторий теперь заморожен: существующие пользователи helm repo add и уже опубликованные версии продолжают работать, но новые версии выходят только через OCI-чарт выше — переходите на helm install oci://… при следующем обновлении.
Все релизы с примечаниями и прикреплёнными пакетами чартов доступны на странице релизов.
WorkloadProfile Identity
Ballast группирует поды в объекты WorkloadProfile по настраиваемому набору ключей меток пода — кортежу идентификатора (identity tuple). Кортеж определяется один раз в BallastConfig.spec.identityLabels и применяется ко всем namespace кластера.
WorkloadProfile имеют область видимости всего кластера. Каждый под в любом namespace, у которого совпадают значения меток идентификатора, передаёт измерения в один и тот же профиль. Это сделано намеренно: сорок dev-namespace с одним приложением billing формируют один хорошо заполненный WorkloadProfile, а не сорок тонких.
Единственное, что разделяет кортеж идентификатора, — политика, управляющая им. Профиль содержит один набор рекомендаций, и именно политика определяет, как они измеряются и рассчитываются, поэтому поды, разрешающиеся к разным политикам, получают разные профили (см. Политика по умолчанию). При наличии только одной общекластерной политики по умолчанию никакого разделения нет и кортеж — это вся история.
По умолчанию: name + component
ballastConfig:
  identityLabels:
    - app.kubernetes.io/name
    - app.kubernetes.io/component
Хорошо подходит для кластеров с единственным классом окружения. Фронтенд и бэкенд одного приложения получают отдельные профили; копии billing сорока разработчиков вносят вклад в один профиль (billing, api).
Смешанные окружения в одном кластере
Если кластер одновременно запускает dev, staging и production, и вам нужны раздельные профили по окружению, добавьте ballast.tightlinesoftware.com/resource-profile в кортеж идентификатора и проставьте его на своих подах:
# BallastConfig / Helm values
ballastConfig:
  identityLabels:
    - app.kubernetes.io/name
    - app.kubernetes.io/component
    - ballast.tightlinesoftware.com/resource-profile
# Pod template labels
labels:
app.kubernetes.io/name: billing
app.kubernetes.io/component: api
ballast.tightlinesoftware.com/resource-profile: prodТеперь (billing, api, prod) и (billing, api, dev) измеряются независимо. Поды без метки ballast.tightlinesoftware.com/resource-profile получают в имени профиля значение-заглушку (noresourceprofile), а не исключаются — подключённые поды всегда порождают профиль.
|
Примечание
|
Изменение |
Подключение
Подключите нагрузку, установив метку ballast.tightlinesoftware.com/mode на шаблоне её пода. Ballast никогда не действует на нагрузку без явного подключения. Значение — один уровень нарастающей лестницы; каждый уровень включает всё нижестоящее.
ballast.tightlinesoftware.com/mode |
Поведение |
|---|---|
|
Только сбор метрик |
|
measure, плюс патч requests/limits на этапе допуска |
|
apply, плюс корректировка ресурсов на работающих подах через in-place resize |
Подключение — это метка, а не аннотация, поэтому API-сервер может фильтровать по ней на стороне сервера. Контроллеры Ballast следят, а admission webhook срабатывает только для подов с этой меткой, что делает присутствие оператора пропорциональным числу подключённых подов, а не общему числу подов в кластере; это важно для очень больших кластеров (#55). Под с меткой, имеющей любое другое значение, отклоняется webhook.
Собственные выходные данные Ballast остаются аннотациями, поскольку они содержат значения, которые нельзя хранить в метке (временны́е метки, ссылки через слеш): profile-ref, policy-ref, resize-blocked и resize-blocked-at.
apply и resize покрывают разные ресурсы. На этапе допуска webhook может задать любой рекомендованный ресурс — cpu, memory, ephemeral-storage — потому что патчит спецификацию пода до его создания. In-place resize уже, согласно ограничениям Kubernetes: субресурс resize пода (KEP-1287) позволяет изменять только cpu и memory на работающем поде и отклоняет патч, затрагивающий что-либо ещё. Поэтому Ballast исключает все прочие ресурсы из resize-патчей. На практике это значит, что рекомендация по ephemeral-storage вступает в силу только при пересоздании пода (через apply), но никак не в месте; работающий под, у которого дрейфует эфемерное хранилище, сохранит текущее значение до следующего перезапуска. Ballast логирует каждое исключение; когда недоступный для resize дрейф — единственный дрейф на поде (и resize вообще не выдаётся), также записывается ballast.resize.skipped{reason="not_resizable"} — причины пропуска всегда описывают весь под целиком, а не отдельную ось ресурса.
resize не может изменить QoS-класс пода. QoS-класс пода (BestEffort, Burstable, Guaranteed) фиксируется при создании, и субресурс resize отклоняет любой патч, который его изменит. Два вида рекомендаций сталкиваются с этим: под BestEffort (без requests и limits на всех контейнерах) никогда не может получить requests в месте, а под Guaranteed (requests равны limits для cpu и memory везде) можно изменить только совместным движением requests и limits. Ballast обнаруживает оба случая перед патчингом и записывает ballast.resize.skipped{reason="qos_pinned"} вместо попытки заведомо безуспешного resize. Под BestEffort всё равно получит рекомендацию на этапе допуска (через apply) при следующем пересоздании: под без размерных ограничений не несёт намерения класса, поэтому допуск может разместить его в любом классе. Под Burstable или Guaranteed тоже сохранит класс, заданный автором при допуске: webhook отбрасывает рекомендации тех контейнеров, которые изменили бы класс, оставляет значения автора и записывает ballast.apply.skipped{reason="qos_pinned"}, если после этого нечего применять. Когда resize завершается с непредвиденной ошибкой, на под проставляется аннотация ballast.tightlinesoftware.com/resize-blocked с текстом ошибки и resize-blocked-at со временем сбоя, а дальнейшие попытки пропускаются (reason="blocked") до истечения одного интервала resize; успешный resize впоследствии очищает обе аннотации.
Ballast никогда не устанавливает request выше limit. Kubernetes отклоняет контейнер, у которого request превышает limit, поэтому политика, управляющая только request, могла бы рекомендовать значение, запрещённое существующим limit пода, — что блокирует создание пода при допуске и ломает каждый resize (#119). При допуске и при resize Ballast удерживает request на уровне limit, который остаётся в патче: рекомендованный limit, если политика им управляет, иначе собственный limit контейнера. При отсутствии limit зажимать нечего. Ballast никогда не повышает limit, чтобы дать место. Если запись request точно на уровне limit (через зажим или рекомендацию, совпадающую с limit) повысила бы Burstable-под до Guaranteed, request понижается на единицу (1m CPU, один байт памяти), чтобы сохранить класс; под, уже находящийся в Guaranteed, зажимается точно на limit и остаётся Guaranteed. Под, уже стоящий на своём limit, не меняется каждый интервал; вместо этого каждая оценка записывает ballast.resize.skipped{reason="clamped_at_limit"} — стационарный сигнал о том, что limit удерживает нагрузку ниже рекомендации (без событий и логов выше уровня debug). Когда тот же под имеет дрейф, который может исправить только допуск, reason="not_resizable" берёт приоритет. Каждый зажим логируется на уровне info с рекомендованным request, limit и фактически записанным request, а также учитывается в ballast.recommendation.clamped (атрибуты container, resource, policy, namespace и phase — admission или resize). Зажим при resize также создаёт событие Warning RequestClampedToLimit на поде; при допуске под ещё не существует, поэтому webhook вместо этого проставляет ballast.tightlinesoftware.com/clamped-<resource>-request со значением request, которое было бы записано без зажима (рекомендация, или собственный request автора, если политика управляет только limit и снижает его ниже этого request). Как и аннотации applied-*, ключуется только по ресурсу, поэтому в многоконтейнерном поде побеждает значение последнего запатченного контейнера. Зажимы или устойчивый счётчик пропусков clamped_at_limit для нагрузки означают, что её limit находится ниже наблюдаемого потребления плюс запас: поднимите limit или дайте нагрузке политику, управляющую обоими полями.
Выселение подов намеренно вынесено за рамки Ballast. Ballast следит за точностью запросов и лимитов ресурсов; перебалансировка кластера на основе скорректированных значений — задача Kubernetes Descheduler (конкретно стратегии LowNodeUtilization). Это чёткое разделение ответственности: Ballast правильно выставляет «вес», Descheduler решает, где должны находиться поды.
Пример — полная автоматизация:
spec:
  template:
    metadata:
      labels:
        app.kubernetes.io/name: billing
        ballast.tightlinesoftware.com/resource-profile: prod
        ballast.tightlinesoftware.com/mode: resize
Пример — только измерение (безопасный первый шаг):
spec:
  template:
    metadata:
      labels:
        ballast.tightlinesoftware.com/mode: measure
Какие нагрузки подключать
Ballast подбирает размеры для долгоживущих нагрузок, изучая их устоявшееся потребление на протяжении часов или дней (порог готовности по умолчанию: 250 семплов за 24 часа). Подключайте Deployment, StatefulSet, DaemonSet и аналогичные контроллеры, чьи поды работают непрерывно.
-
Job-поды: вы почти наверняка не хотите их подключать. Job выполняется до завершения, нередко за секунды или минуты, поэтому он никогда не накопит достаточно устоявшейся истории, чтобы пересечь порог готовности. Подключение шаблона пода Job лишь создаёт
WorkloadProfile, который никогда не выдаст рекомендацию. Ballast вас не остановит (подключение полностью под вашим контролем), но пользы нет, а профили засоряются. -
CronJob-поды: хорошо подумайте перед подключением. CronJob создаёт Jobs, а те — поды (
CronJob → Job → Pod), поэтому поды CronJob несут то же предостережение «выполнение до завершения», что и любые другие Job-поды. Подключайте их только если каждый запуск действительно достаточно долог и стабилен по ресурсам для осмысленного измерения — например, многочасовое ночное пакетное задание. Короткая или пиковая периодическая задача плохо подходит и будет в основном генерировать шум.
Обычные контейнеры и restartable-init-сайдкары получают корректировку размера. На подключённом поде Ballast измеряет и изменяет размеры обычных контейнеров spec.containers и restartable-init «нативных сайдкаров» (restartPolicy: Always, KEP-753) — они работают всё время жизни пода и патчатся в spec.initContainers так же, как обычные контейнеры. Run-to-completion init-контейнеры и эфемерные debug-контейнеры исключаются из измерений — настройки на уровне контейнера нет; исключение происходит автоматически. Различие — «выполнение до завершения» vs. «долгоживущий», а не «init vs. обычный». In-place resize restartable-init-контейнеров использует тот же субресурс pods/resize, что и обычные контейнеры (поддерживается в Kubernetes 1.33+, GA в 1.35).
Массовое подключение с помощью scripts/enroll.sh
Ставить метку mode вручную на весь существующий кластер утомительно. scripts/enroll.sh делает это массово: он помечает каждый Deployment, StatefulSet и DaemonSet, чей шаблон пода уже содержит полный кортеж идентификатора и ещё не подключён. Кортеж читается из BallastConfig с именем ballast в целевом контексте (с откатом на --identity-labels, затем на значение по умолчанию из чарта), поэтому скрипт подключает именно те нагрузки, которые будет ключировать оператор.
По умолчанию — только симуляция (dry-run); передайте --apply для применения изменений. Параметр --mode (одно из measure, apply, resize) обязателен.
# See what would be enrolled at measure, cluster-wide (no changes)
scripts/enroll.sh --mode measure

# Enroll the 'web' namespace at measure
scripts/enroll.sh --mode measure -n web --apply
Обработка каждой нагрузки зависит от того, безопасен ли перезапуск:
-
Более одной реплики: метка добавляется к шаблону, а нагрузка плавно перезапускается (семантика
kubectl rollout restart), чтобы поды подхватили метку без потери доступности. Скрипт ждёт завершенияkubectl rollout status(см.--timeout). -
Единственная реплика или стратегия обновления
OnDelete: перезапуск означал бы простой, поэтому метка надёжно добавляется к шаблону без перезапуска, а живые поды помечаются на месте. Меткаmodeне входит ни в один селектор, поэтому это чисто метаданные; оператор подхватит поды и подключит их так же, как если бы они были пересозданы.
По умолчанию нагрузки не пропускаются; маршрут без перезапуска делает безопасным охват всего кластера. Передайте в --ignore регулярное выражение по имени нагрузки, чтобы исключить некоторые (например, --ignore 'consul|vault'). Запустите с --help для полного списка параметров.
Подключение идемпотентно, поэтому повторный запуск безопасен: нагрузка, уже несущая метку mode, никогда не патчируется и не перезапускается повторно. Уже находящиеся на запрошенном уровне отображаются как no-op; уже находящиеся на другом уровне отмечаются предупреждением и оставляются без изменений (если не задан --remode; см. ниже).
|
Примечание
|
На маршруте без перезапуска под подключается и учитывается немедленно; когда он будет обработан — зависит от уровня. |
Быстрое первичное подключение и быстрое повышение уровня
Два флага ускоряют развёртывание подключения по всему большому кластеру в два этапа:
-
--no-restart(применение на месте): подключить без пересоздания любых подов, даже с несколькими репликами. Метка надёжно добавляется к шаблону каждой нагрузки (через те же техники паузы/принятия, раздела и OnDelete, что используются для нагрузок с одной репликой) и живые поды помечаются на месте. Это значительно быстрее плавного обновления всех нагрузок, с одной оговоркой: при--mode applyподы на месте сохраняют текущие ресурсы до следующего перезапуска (measureсобирает в любом случае, аresizeкорректирует работающие поды на месте независимо от этого). Отличный первый проход:
scripts/enroll.sh --mode measure --no-restart --apply # enroll the whole cluster at measure, no restarts-
--remode: по умолчанию нагрузка, уже подключённая на другом уровне, остаётся без изменений (с предупреждением).--remodeменяет её на--mode, позволяя продвигать парк по лестнице уровней, когда профили будут готовы. Комбинируйте с--no-restartдля применения на месте:
scripts/enroll.sh --mode resize --remode --no-restart --apply # upgrade measure/apply workloads to resize, in placeНагрузка, уже находящаяся на запрошенном уровне, остаётся no-op. Поскольку resize корректирует работающие поды на месте, повышение до resize с --no-restart начинает корректировать живые поды без единого перезапуска.
Проверка WorkloadProfile
Как только под с меткой ballast.tightlinesoftware.com/mode запустится, Ballast создаст WorkloadProfile для его кортежа идентификатора и управляющей политики. Проверьте его командами:
kubectl get workloadprofiles
kubectl describe workloadprofile <name-from-the-list-above>
Имя профиля — значения кортежа идентификатора через --, за которыми следует токен политики (billing—api—prod—default-a1b2c3d4), поэтому сначала выводите список профилей, не угадывайте имя. Колонка POLICY показывает, какая политика управляет каждым профилем.
Статус профиля показывает накопленную статистику потребления и рекомендации после достижения порога готовности (по умолчанию: 250 семплов за 24 часа). Отслеживаются и учитываются CPU, память и эфемерное хранилище:
status:
  containers:
    - name: app
      usageStats:
        - resource: cpu
          samples: 288
          mean: "230m"
          p95: "240m"
          p99: "310m"
          cv: "0.46"
        - resource: memory
          samples: 288
          mean: "180Mi"
          p50: "176Mi"
          p75: "192Mi"
          p95: "210Mi"
          p99: "240Mi"
          cv: "0.21"
        - resource: ephemeral-storage
          samples: 288
          p90: "1200Mi"
          p99: "1800Mi"
          cv: "0.33"
      recommendations:
        cpu:
          request: "288m"     # avg * 1.25 headroom
        memory:
          request: "192Mi"    # p75
          limit: "288Mi"      # p99 * 1.2
        ephemeral-storage:
          request: "1200Mi"   # p90
          limit: "2160Mi"     # p99 * 1.2
  meetsThreshold: true
  activeWorkloads: 3
Аварийный стоп
Создайте ConfigMap с именем ballast-kill-switch в namespace оператора, чтобы немедленно остановить всю активность Ballast без перезапуска:
# Halt all Ballast activity
kubectl create configmap ballast-kill-switch -n ballast-system

# Resume
kubectl delete configmap ballast-kill-switch -n ballast-system
Все подавленные действия логируются на уровне warn с kill_switch: true. Допуск подов продолжается в штатном режиме (webhook пропускает поды без мутации).
Для плановой, управляемой GitOps-приостановки вместо этого задайте BallastConfig.spec.suspended: true.
Webhook TLS
Kubernetes требует, чтобы сервер admission webhook предоставлял TLS-сертификат, доверенный API-серверу. Ballast поддерживает три подхода в порядке предпочтения:
1. cert-manager (по умолчанию)
Helm-чарт создаёт самоподписанный ресурс Issuer и ресурс Certificate. cert-manager выпускает сертификат, монтирует его в под оператора и автоматически инжектирует CA bundle в MutatingWebhookConfiguration. Работает в air-gapped кластерах — без DNS или HTTP-challenge, без внешнего CA.
Требует предварительно установленного cert-manager в кластере (Ballast использует его, но не устанавливает). Если cert-manager уже установлен — что обычно так — дополнительная настройка не нужна.
# values.yaml (default)
certManager:
  enabled: true
2. Kubernetes CertificateSigningRequest (планируется)
Helm-задача перед установкой отправляет CSR встроенному CA кластера. Полученный сертификат записывается в Secret, который монтирует оператор. Зависимость от cert-manager отсутствует, но ServiceAccount задачи должен иметь разрешение certificates.k8s.io/approve — что некоторые кластеры ограничивают, требуя ручного kubectl certificate approve.
Ещё не реализовано; запланировано как будущее улучшение Helm-чарта.
3. Пользовательский сертификат (планируется)
Предоставьте собственный материал сертификата (например, из внутреннего PKI или Vault) через значения Helm. Чарт полностью пропускает cert-manager и CSR и использует предоставленный Secret напрямую. caBundle в MutatingWebhookConfiguration должен быть задан соответствующим CA-сертификатом.
Ещё не реализовано; запланировано как будущее улучшение Helm-чарта.
Политика MetricsSource и ClusterResourcePolicy по умолчанию
Свежая установка через helm install создаёт три объекта «из коробки», чтобы измерения работали без дополнительной настройки: два объекта MetricsSource (CPU/память и эфемерное хранилище) и один общий ClusterResourcePolicy.
MetricsSource: kubernetes-metrics
spec:
  type: kubernetesMetrics
  config:
    pollInterval: "300s"
    reservoirSize: 10000
Подключает Ballast к metrics-server кластера (должен быть установлен заранее — в поставку не входит) для сбора CPU и памяти. Семплы собираются каждые 5 минут, в Redis хранится до 10 000 семплов на контейнер на метрику.
MetricsSource: kubelet-summary
spec:
  type: kubeletSummary
  config:
    pollInterval: "300s"
    reservoirSize: 10000
Читает потребление эфемерного хранилища из kubelet Summary API (через прокси API-сервера). Дополнительных учётных данных помимо ServiceAccount Ballast не требуется.
Чтобы отказаться от одного из источников и управлять объектами MetricsSource самостоятельно, установите enabled: false для нужного:
# values.yaml
defaultMetricsSources:
  kubernetesMetrics:
    enabled: false
  kubeletSummary:
    enabled: false
ClusterResourcePolicy: default
Это пресет homogeneous-large-fleet — встроенное значение по умолчанию чарта:
spec:
  priority: 0
  metrics:
    - resource: cpu
      field: request
      source: kubernetes-metrics
      aggregation: avg
      headroom: "1.25"
    - resource: memory
      field: request
      source: kubernetes-metrics
      aggregation: p50
      headroom: "1.05"
    - resource: memory
      field: limit
      source: kubernetes-metrics
      aggregation: p99
      headroom: "1.2"
    - resource: ephemeral-storage
      field: request
      source: kubelet-summary
      aggregation: p90
      headroom: "1.0"
    - resource: ephemeral-storage
      field: limit
      source: kubelet-summary
      aggregation: p99
      headroom: "1.2"
  readiness:
    minDataPoints: 250
    minTimeSpan: "24h"
    maxCV: "1.5"
    cvMeanFloor:
      cpu: "25m"
      memory: "25Mi"
      ephemeral-storage: "2Mi"
  behaviors:
    thresholds:
      default: "10%"
    resize:
      maxChangePerCycle: "50%"
      interval: "15m"
Эта общая политика применяется к каждому подключённому поду в кластере. Ключевые проектные решения:
-
CPU request на уровне
avg * 1.25. Потребление CPU пиково и в состоянии покоя значительно ниже пиков, поэтому размер request на уровне 80% от среднего (= среднее / 0.80 целевой утилизации) удерживает узлы плотными, оставляя запас для нормального разброса. Для большого однородного парка суммарная нагрузка предсказуема, поэтому среднее — надёжная основа. -
Memory request на уровне
p75, намеренно не по формуле CPU. Рабочий набор памяти — это занятость, а не утилизация: она почти плоская на контейнер (p99 обычно в 15-30% от среднего), поэтому формула «целевая утилизация» вродеavg * 1.25поставила бы каждый request выше исторического p99 контейнера, фиксируя суммарное резервирование всего парка на 125% суммарного потребления — зарезервированная, но неиспользуемая ёмкость. Защита от пиков — задача limit, а не request; request должен лишь отражать типичную занятость, чтобы претензия планировщика соответствовала реальности. p75 отражает эту занятость напрямую: request покрывает реальное потребление ~75% времени, так что претензия планировщика стоит на уровне реального потребления или чуть выше, а не ниже него, и самонастраивается под разброс каждой нагрузки (у плоского контейнера p75 отличается от p50 лишь на проценты, у переменчивого — получает пропорционально больше запаса). p75 держится в стороне от хвоста с кратковременными пиками запуска, поэтому остаётся достаточно стабильным, чтобы не срабатывать повторно на пороге дрейфа. -
Memory limit на уровне
p99 * 1.2. p99 — это наибольшее потребление, которое нагрузка показала в production; 20% запаса поглощает редкий нормальный пик, при этом OOMKill ждёт под, ушедший значительно дальше наблюдаемого пика (признак утечки). Это даёт QoS Burstable (limit > request) — правильный класс для большинства production-нагрузок. CPU limits намеренно опущены — они вызывают throttling, а не возвращают потраченные ресурсы. -
Эфемерное хранилище из kubelet Summary API. Request рассчитывается на уровне p90 (распределение со смещением к росту), limit — на уровне
p99 * 1.2, чтобы kubelet выселил по-настоящему вышедший из-под контроля под до того, как узел испытает давление диска, допуская при этом нормальный пик выше наблюдаемого максимума. -
250 семплов за 24 часа до начала действий. При интервале опроса 5 минут один долгоживущий под накапливает ~288 семплов за 24 часа, поэтому окно в 24 часа — а не счётчик семплов — является ограничивающим условием. Высокий коэффициент вариации (CV > 1.5) также блокирует действие — это означает, что нагрузка слишком пиковая для надёжного определения размера. Проверка CV пропускается, когда среднее потребление ниже крошечного порога на ресурс (
cvMeanFloor, по умолчанию: 25m CPU, 25Mi памяти, 2Mi эфемерного хранилища): CV делится на среднее, поэтому почти простаивающие нагрузки дают огромные CV из-за шума квантизации и редких пиков запуска, и без этого порога один почти простаивающий ресурс навсегда удерживал бы весь профиль в статусеAccruing— блокируя рекомендации для всех других ресурсов. Потребление ниже порога слишком мало, чтобы некорректная рекомендация имела значение. -
Порог дрейфа 10%. Resize срабатывает только когда текущее значение ресурса отклоняется от рекомендации более чем на 10%. In-place resize дёшев и безопасен (патч request/limit на работающем поде без перезапуска), поэтому полоса намеренно узкая: рекомендация, сдвинувшаяся более чем на 10%, отражает реальный сдвиг в наблюдаемом потреблении, а не шум.
-
50% максимального изменения за цикл. Каждый resize сдвигается не более чем на половину оставшегося расстояния между текущим значением и рекомендацией, давая нагрузкам время стабилизироваться между корректировками. Первый шаг устраняет большую часть отклонения; как только шаг укладывался бы в пределы порога дрейфа, рекомендация применяется точно, чтобы сходимость завершилась, а не застряла у самого порога.
-
Приоритет 0. Это наименьший возможный приоритет. Любой
ClusterResourcePolicyилиResourcePolicyсpriority > 0выигрывает для совпавших нагрузок, поэтому можно переопределять отдельные namespace или виды нагрузок, не трогая этот default.ResourcePolicyтакже превосходитClusterResourcePolicyдля подов в своём namespace независимо от приоритета, по принципу, что политика владельца namespace является более конкретным совпадением; на поды других namespace она не влияет.
Каждая нагрузка управляется ровно одной политикой, и эта политика — часть идентификатора WorkloadProfile нагрузки: поды, разрешающиеся к разным политикам, получают разные профили, потому что профиль содержит один набор рекомендаций, а именно политика их производит. Поэтому имена профилей несут токен политики (checkout—server—default-a1b2c3d4), а kubectl get workloadprofiles показывает управляющую политику в отдельной колонке. Чтобы вывести профили, управляемые политикой:
kubectl get workloadprofiles | grep "$(kubectl get clusterresourcepolicy default \
  -o jsonpath='{.status.profileDiscriminator}')"