авторы: Alon Halfon, Orith Toledo-Ronen, Lena Dankin, Elron Bandel, Maroon Ayoub, Ashok Chandrasekar, Jason Kramberger, Yoav Katz, Michal Shmueli-Scheuer
ИИ-агенты уже работают в продакшне — они обрабатывают обращения в службу поддержки, пишут код и координируют сложные рабочие процессы. Инфраструктура инференса, которая их поддерживает, сталкивается с привычными вопросами масштабирования: «Выдержит ли она реальную нагрузку? Сколько нужно железа? Какая конфигурация обслуживания оптимальна?» А если вы разрабатываете саму инфраструктуру: «Действительно ли моя оптимизация помогает на реальном трафике агентов?»
Большинство инструментов нагрузочного тестирования, однако, создавались для более простого мира. Они предполагают, что запросы независимы, не имеют состояния и взаимозаменяемы. Но ИИ-агент устроен иначе: он строит планы, параллельно вызывает инструменты, ждёт результатов и передаёт их на следующий шаг. Каждый запрос зависит от предыдущего. Порядок выполнения имеет значение.
Именно это противоречие стало толчком к созданию возможности воспроизведения трассировок OpenTelemetry (OTel Trace Replay) — нового функционала в Inference Perf, инструменте Kubernetes SIG для бенчмаркинга инференса генеративного ИИ. Идея проста: вместо того чтобы придумывать синтетическую нагрузку, достаточно один раз зафиксировать то, что система на самом деле делает в продакшне, а затем воспроизвести LLM-нагрузку для разных конфигураций обслуживания, моделей или железа — с полным контролем над переменными.
|
Примечание
|
Коротко о главном: Inference Perf теперь умеет воспроизводить реальные трассировки агентов как нагрузочные тесты. Укажите ему на продакшн-трассировки, и он воспроизведёт полную многошаговую нагрузку — включая параллельные вызовы инструментов, последовательные зависимости и растущий контекст — против вашего эндпоинта инференса. Вы получаете метрики на уровне сессий (сквозная задержка, доля успешных выполнений) наряду с метриками отдельных запросов, что позволяет тестировать инфраструктуру обслуживания на трафике, реально соответствующем продакшну. |
Предыстория: Inference Perf и OpenTelemetry
Inference Perf — это инструмент для бенчмаркинга производительности инференса генеративного ИИ в продакшн-масштабе, разработанный в рамках Kubernetes SIGs для стандартизации такого бенчмаркинга. Он полностью не зависит от сервера инференса и подходит для тестирования vLLM, SGLang, HuggingFace TGI, llm-d, NVIDIA Dynamo и любого эндпоинта с OpenAI API. Инструмент выдерживает нагрузку свыше 10 000 QPS и предоставляет исчерпывающий набор метрик: TTFT, TPOT, ITL, пропускную способность и goodput.
OpenTelemetry (OTel) — открытый стандарт для телеметрии, определяющий структуру и способы обмена трассировками (traces), метриками и логами в распределённых системах. Трассировка представляет собой полный поток обработки запроса через систему и состоит из множества спанов (spans) — отдельных операций, таких как вызов LLM, выполнение инструмента или запрос к базе данных.
Что особенно важно для LLM-нагрузок: OTel определяет Семантические соглашения для GenAI (Semantic Conventions for GenAI), устанавливающие стандартизированный набор имён атрибутов и структур спанов для LLM-вызовов (имя модели, количество токенов, сообщения, определения инструментов и т. д.). Inference Perf читает трассировки, следующие этим соглашениям. Благодаря этому любой фреймворк, генерирующий OTel-совместимые GenAI-спаны — LangChain, LlamaIndex и другие фреймворки агентов — производит трассировки, которые можно воспроизводить напрямую.
Проблема: нагрузочное тестирование сложных агентных нагрузок
Представьте, что происходит, когда агент для работы с кодом выполняет обзор пулл-реквеста:
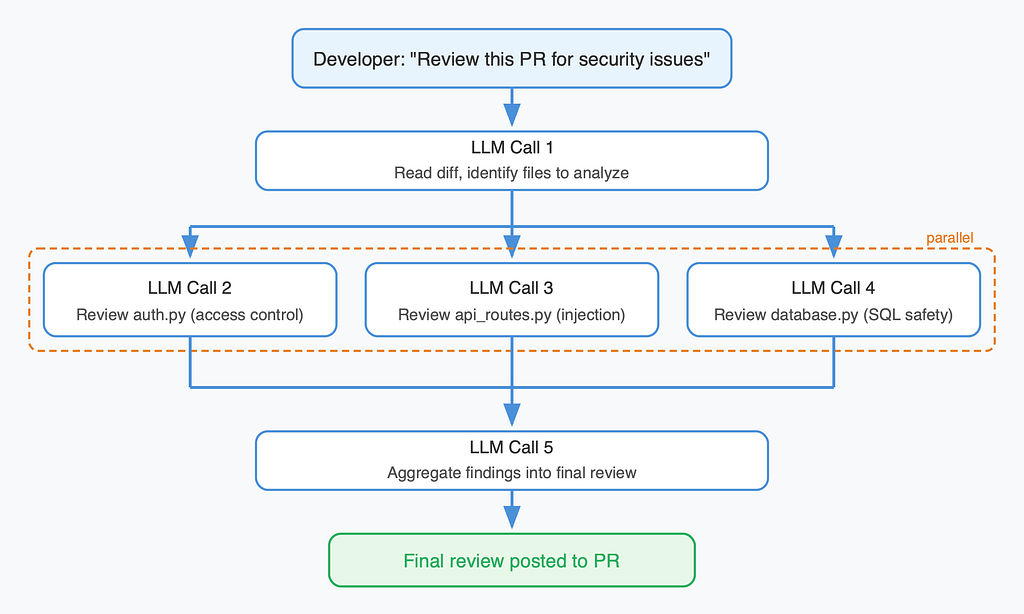
Такой граф зависимостей невозможно выразить стандартными паттернами нагрузки. Обычные типы нагрузки (постоянная, пуассоновская, конкурентная) отправляют запросы по заранее составленному расписанию. Они справляются с последовательными многоходовыми диалогами, но не могут работать с параллельными ветвями, зависимостями от нескольких предшественников или с тайммингом, который определяется логикой агента, а не часами.
С OTel Trace Replay вы теперь можете отвечать на такие вопросы:
-
«Какая конфигурация обслуживания или провайдер реально лучше справляется с моей нагрузкой?» Настройка инфраструктуры инференса подразумевает выбор между конфигурациями обслуживания, чей эффект проявляется только при реалистичном трафике. Например, llm-d — нативный для Kubernetes фреймворк распределённого инференса — предлагает маршрутизацию с учётом кеша префиксов, выгрузку KV-кеша и разделение (disaggregation) этапов предзаполнения (prefill) и декодирования (decode). Эти возможности целенаправленно рассчитаны на длинные общие префиксы, растущие контексты и пакетный параллелизм, характерные для агентных нагрузок, — но их влияние невидимо при синтетических бенчмарках с одиночными запросами. Даже при одинаковых весах модели смена провайдера меняет распределение задержек, поведение при таймаутах и ограничения на частоту запросов. Воспроизводите одни и те же трассировки для каждой конфигурации или эндпоинта — и получите честное сравнение, где структура зависимостей, распределение токенов и растущий контекст остаются идентичными, а меняется только цель обслуживания. Это даёт прямое сравнение долей успешных завершений сессий и p95-задержки рабочего процесса без шума от повторного запуска самого агента.
-
«Какова моя реальная сквозная задержка и при каком уровне параллелизма система ломается?» Метрики на уровне отдельных запросов (TTFT, TPOT) показывают скорость отдельных вызовов, но не отражают, сколько ждёт пользователь до получения полного ответа. Рабочий процесс агента из 12 вызовов может занимать от 8 до 45 секунд, причём узким местом нередко оказывается один медленный вызов в середине цепочки, а не среднее значение. Метрики уровня сессий закрывают этот пробел, отображая суммарную длительность рабочего процесса от первого запроса до финального ответа. Затем можно увеличивать количество параллельных сессий с 10 до 50 и до 200, используя одни и те же трассировки, и наблюдать, где доля успешных завершений падает, а p95-задержка резко возрастает. Это позволяет выявить реальный предел пропускной способности для агентного трафика, причём каждая итерация бьёт в реальное узкое место рабочего процесса, а не в синтетический суррогат.
Всё это работает за счёт захвата реальных продакшн-трассировок и их точного воспроизведения с сохранением зависимостей, таймингов и роста контекста.
Подходы к бенчмаркингу LLM-инференса
Существуют три широких подхода к бенчмаркингу LLM-инференса, каждый из которых подходит для разных вопросов. Inference Perf поддерживает все три:
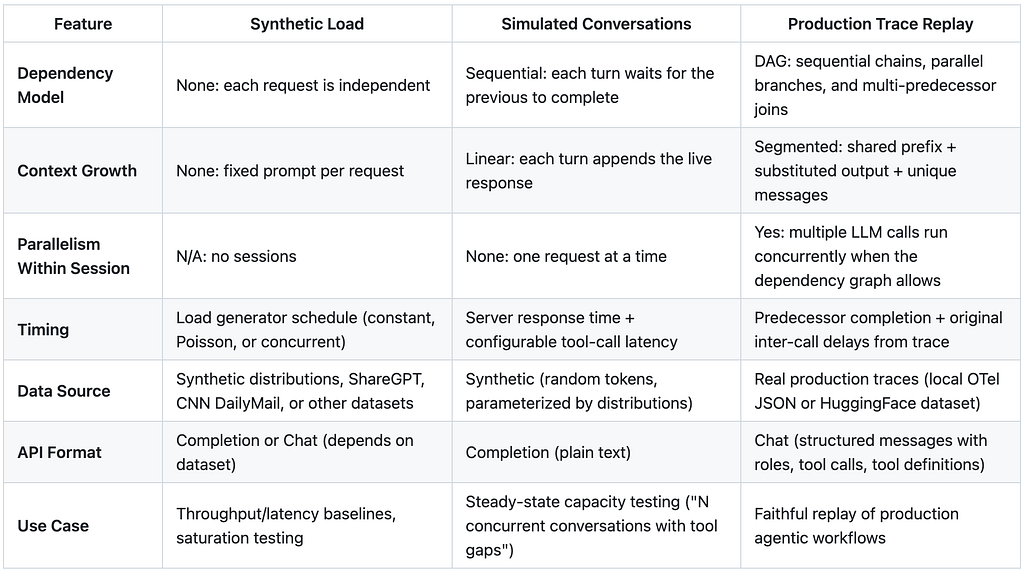
Используйте синтетические данные, ShareGPT или cnn_dailymail для быстрого получения базовых показателей пропускной способности и задержки при независимых запросах. Используйте conversation_replay, когда нужны рост контекста в многоходовых диалогах и задержки вызовов инструментов. Этот режим полностью синтетический, детерминированный при задании зерна генератора и не требует файлов трассировок. Наконец, используйте OTel Trace Replay тогда, когда значимые результаты может дать только реальный продакшн-трафик — с точной структурой зависимостей, параллельным выполнением, реальными тайммингами и реальными паттернами вызовов инструментов.
Как это работает
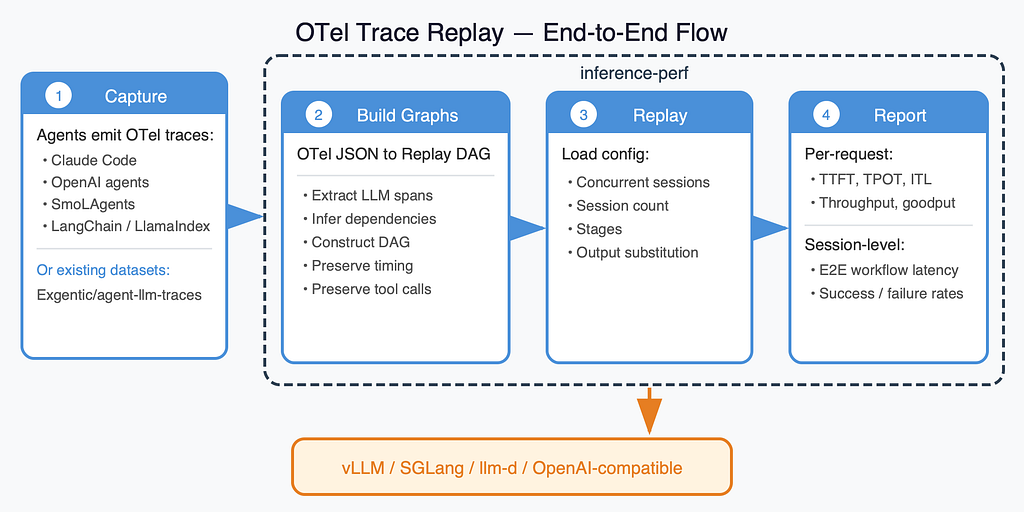
Сквозной рабочий процесс состоит из четырёх этапов:
-
Захват. Ваши агенты (Claude Code, агенты на базе OpenAI, SmoLAgents или любой фреймворк с OTel-инструментацией — LangChain, LlamaIndex) генерируют трассировки OpenTelemetry в ходе обычной работы. Каждая трассировка фиксирует полную последовательность LLM-вызовов одной агентной сессии: входные данные, выходные данные, тайминги и взаимодействия с инструментами. Захват выполняется один раз, воспроизведение — многократно. Повторный запуск агентов требует полного стека (фреймворк, API инструментов, учётные данные, датасеты, окружение), обходится дорого и ненадёжен, а главное — затрудняет разделение производительности обслуживания и недетерминизма агента. Трассировки можно экспортировать как JSON-файлы, публиковать на HuggingFace или использовать готовый датасет Exgentic/agent-llm-traces, содержащий 1 781 сессию, готовую к воспроизведению.
-
Построение графов воспроизведения. Inference Perf загружает трассировки, извлекает LLM-спаны, определяет причинно-следственные зависимости между вызовами и строит ориентированный ациклический граф (DAG, directed acyclic graph) для каждой сессии, сохраняя исходную временну́ю структуру и порядок выполнения вызовов.
-
Воспроизведение. Сессии параллельно отправляются на ваш эндпоинт инференса (vLLM, SGLang, llm-d или любой сервер с OpenAI API). Внутри каждой сессии выполнение управляется DAG: последовательные цепочки ждут завершения предшественников, параллельные ветви запускаются одновременно, а реальные выходные данные модели подставляются в последующие запросы для реалистичного роста контекста.
-
Отчётность. Метрики на уровне отдельных запросов (TTFT, TPOT, ITL, пропускная способность) и метрики уровня сессий (сквозная задержка рабочего процесса, доля успешных завершений) дают как микро-, так и макровзгляд на производительность.
От трассировки к графу воспроизведения
Каждый файл OTel-трассировки содержит плоский список спанов. Система воспроизведения восстанавливает исходный граф выполнения в виде ориентированного ациклического графа (DAG):
-
Извлекаются LLM-спаны в соответствии с Семантическими соглашениями OpenTelemetry для GenAI.
-
Зависимости определяются автоматически через анализ содержимого сообщений. Если сообщение ассистента в одном вызове точно совпадает с выходными данными предшественника, создаётся причинно-следственная связь. Для вызовов, не разделяющих содержимого, но следующих последовательно во времени, в качестве запасного варианта используются временны́е рёбра.
-
Применяется транзитивная редукция для устранения избыточных рёбер — сохраняются только прямые предшественники, что обеспечивает оптимальную эффективность воспроизведения.
-
Аутентичные тайминги сохраняются путём фиксации точных задержек (
wait_ms) между завершением предшественников и началом каждого вызова. Это воссоздаёт реальное время обработки, задержки выполнения инструментов и время ожидания пользователя. Настраиваемый порогmax_wait_ms(по умолчанию 15 с) не даёт необычно долгим исходным задержкам раздувать длительность воспроизведения.
Воспроизведение с учётом реальных выходных данных
Именно здесь большинство систем воспроизведения проигрывают: они воспроизводят записанные выходные данные, а не живые. Inference Perf придерживается более точного подхода. Когда запрос зависит от вывода предшественника, записанное сообщение ассистента заменяется текстом, реально сгенерированным во время живого прогона бенчмарка. Это обеспечивает реалистичное поведение KV-кеша и аутентичный рост контекста, позволяя многоходовым диалогам развиваться естественно на основе реальных выходных данных, а не статичного записанного текста.
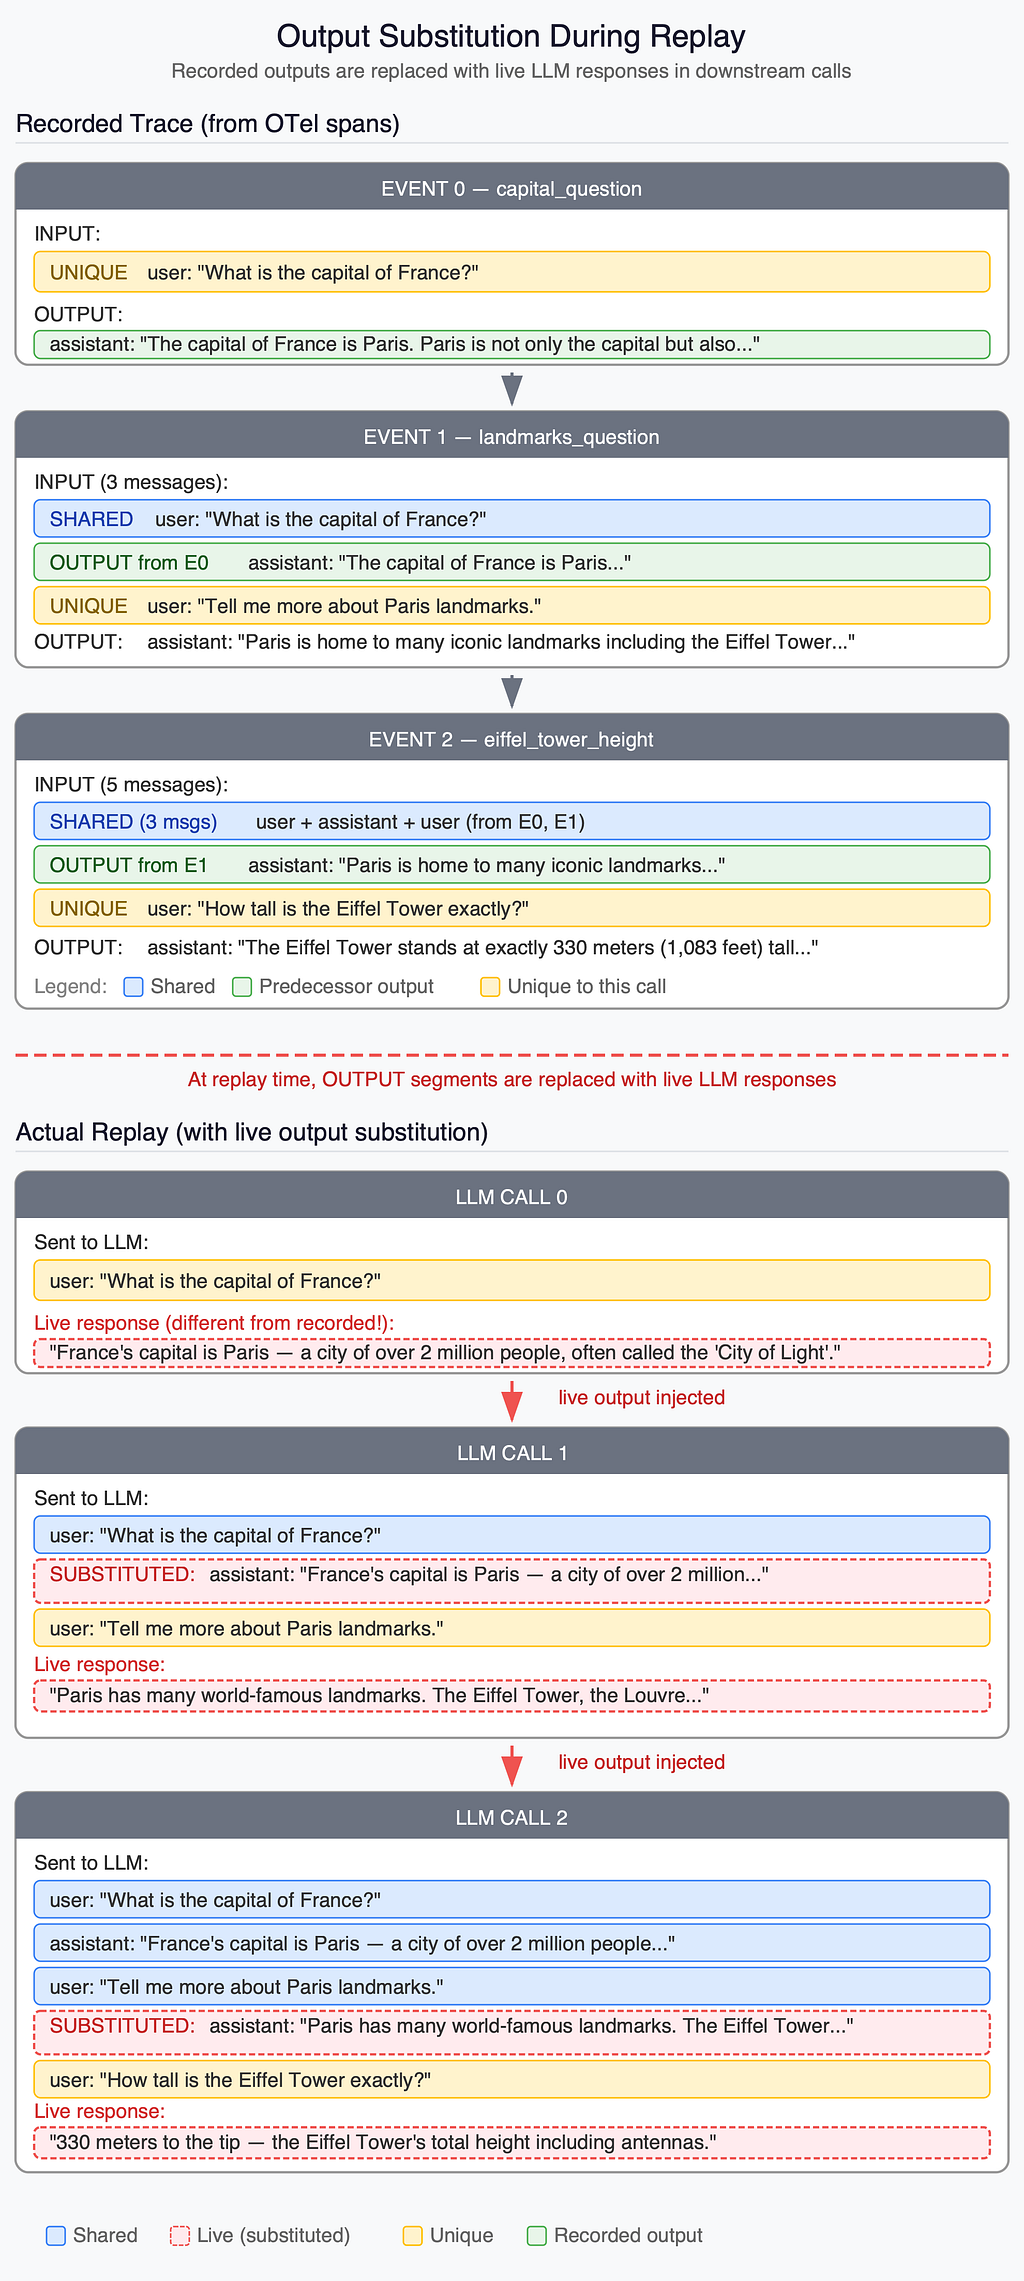
Подстановка живых выходных данных при воспроизведении — записанные ответы ассистента заменяются реальными выходными данными LLM в последующих запросах, что обеспечивает реалистичный рост контекста и правильное поведение KV-кеша
Это распространяется и на структурированные выходные данные вызовов инструментов: когда модель отвечает с tool_calls (имя функции, аргументы, идентификаторы), они захватываются в реальном времени и вставляются в последующие запросы. Идентификаторы вызовов инструментов перезаписываются, чтобы соответствовать идентификаторам живой модели, а tool_choice настраивается так, чтобы направлять модель к генерации вывода с вызовом инструмента там, где исходная трассировка это делала. В результате рабочие процессы с вызовом инструментов воспроизводятся с полной точностью, включая форматы структурированных сообщений, от которых зависят агенты, использующие инструменты.
Выполнение на основе сессий
Воспроизведение работает на уровне сессий, где каждый файл трассировки представляет один полный рабочий процесс:
-
Один файл трассировки соответствует одной сессии, содержащей несколько LLM-вызовов и их граф зависимостей.
-
Сессии выполняются параллельно согласно настройке
concurrent_sessions. -
Внутри каждой сессии события выполняются в соответствии с графом зависимостей: корневые события стартуют немедленно, зависимые — ждут завершения предшественников.
-
Завершение сессии отслеживается целостно: сессия считается успешной только в том случае, если все её события завершились без ошибок.
Такой подход на основе сессий позволяет управлять суммарной нагрузкой на систему (сколько рабочих процессов выполняется одновременно), сохраняя при этом внутреннюю структуру выполнения каждого рабочего процесса.
Для усиления нагрузки сверх доступного количества трассировок опция duplicate_sessions_target дублирует сессии до нужного количества. Каждый дубликат получает случайный идентификатор сессии, вставляемый в уникальные сегменты сообщений, что обеспечивает изоляцию KV-кеша между копиями. В результате дублированные сессии с точки зрения движка инференса ведут себя как независимые нагрузки.
Метрики уровня сессий
Помимо метрик отдельных запросов (TTFT, TPOT, пропускная способность), OTel Trace Replay предоставляет метрики уровня сессий, отражающие производительность полных рабочих процессов. Это даёт видимость в:
-
Сквозную задержку рабочего процесса: сколько времени занимает весь агентный рабочий процесс от начала до конца?
-
Долю успешных выполнений: какой процент полных рабочих процессов завершается успешно?
-
Потребление ресурсов: суммарное количество токенов, использованных во всех вызовах рабочего процесса.
Метрики уровня сессий дополняют метрики отдельных запросов, давая одновременно микро- (отдельные LLM-вызовы) и макро- (полные рабочие процессы) взгляды на производительность. Это необходимо для понимания того, как система работает в условиях реалистичных продакшн-паттернов.
Попробуйте сами
Предполагается, что у вас уже запущен эндпоинт с OpenAI API (vLLM, SGLang и т. д.):
git clone https://github.com/kubernetes-sigs/inference-perf.git
cd inference-perf
Трассировки можно загружать из локальной директории с JSON-файлами или напрямую из датасета HuggingFace. Вот оба варианта:
Из локальных файлов трассировок:
python -m inference_perf.main \
 --server.base_url http://localhost:8000 \
 --server.model_name HuggingFaceTB/SmolLM2-135M-Instruct \
 --api.type chat \
 --data.type otel_trace_replay \
 --data.otel_trace_replay.trace_directory examples/otel/test_traces/advanced \
 --load.type trace_session_replay \
 --load.stages '[{"concurrent_sessions": 2}]'
Из датасета HuggingFace:
python -m inference_perf.main \
 --server.base_url http://localhost:8000 \
 --server.model_name Qwen/Qwen2.5-7B-Instruct \
 --api.type chat \
 --data.type otel_trace_replay \
 --data.otel_trace_replay.hf_dataset_path '"Exgentic/agent-llm-traces"' \
 --load.type trace_session_replay \
 --load.stages '[{"concurrent_sessions": 20, "num_sessions": 100}]'
При первом запуске потребуется несколько минут на скачивание и кеширование датасета локально.
Эта команда загружает трассировки из датасета Exgentic/agent-llm-traces, содержащего 1 781 реальную агентную сессию из четырёх бенчмарков (AppWorld, BrowseComp+, SWE-Bench, Tau2), пяти агентных фреймворков (Claude Code, OpenAI Solo, SmoLAgents и варианты с вызовом инструментов) и шести моделей (Claude, GPT-4.1, GPT-5.2, DeepSeek-V3, Gemini и Kimi).
Сессии варьируются от ~8 LLM-вызовов для простых задач Tau2 по ретейлу до 44+ вызовов для сложных сессий кодирования в SWE-Bench. Количество токенов на сессию — от 250 тысяч до более миллиона.
Вы получите метрики отдельных запросов (TTFT, TPOT, ITL, пропускная способность) вместе с метриками уровня сессий — сквозной задержкой рабочего процесса и долей успешных завершений по всем агентным рабочим процессам.
Для более сложных сценариев можно использовать YAML-файлы конфигурации — примеры в examples/otel/configs/ включают дублирование сессий, ограничения таймингов и многоступенчатые профили нагрузки.
Дополнительные материалы
OTel Trace Replay — лишь часть масштабных усилий по повышению реалистичности и воспроизводимости бенчмаркинга LLM-инфраструктуры. Если вы занимаетесь производительностью инференса или просто интересуетесь этой темой, нам будет интересно узнать, какие нагрузки вы тестируете и как подходите к их бенчмаркингу.
-
Inference Perf: Репозиторий на GitHub | Документация
-
OTel Trace Replay: Полное руководство | Примеры конфигураций
-
Exgentic: exgentic.ai | Датасет Agent LLM Traces
-
Сообщество: Slack #inference-perf
|
Примечание
|
Inference Perf — проект Kubernetes SIG Scalability, разработанный для стандартизации бенчмаркинга инференса GenAI. |