Введение
Мы живём в захватывающую эпоху генеративного ИИ. Открытые большие языковые модели (large language models, LLM) открывают широкие возможности для кастомизации и развёртывания в узкоспециализированных областях. Большинство LLM работают на серверах или в облаке, однако существуют перспективные возможности для запуска мощных моделей локально.
Веб-браузеры представляют собой универсально доступную платформу: пользователи могут без труда взаимодействовать с любыми веб-приложениями, не устанавливая ничего дополнительно. Разве не было бы здорово запускать открытые языковые модели прямо в браузере — так, чтобы любой желающий мог работать с LLM локально, просто открыв веб-страницу?
В этой статье мы представляем движок WebLLM (WebLLM) — высокопроизводительный движок инференса LLM, работающий прямо в браузере. WebLLM — новая глава проекта MLC-LLM: это специализированный веб-бэкенд для MLCEngine, обеспечивающий эффективный инференс LLM в браузере с локальным ускорением на GPU. WebLLM работает быстро (нативное ускорение на GPU), конфиденциально (все вычисления выполняются на стороне клиента) и удобно (никакой настройки окружения). На рисунке ниже показано, как с помощью WebLLM API построен WebLLM Chat — полностью приватный чат, работающий локально в браузере. Тот же API открывает и другие сценарии использования: суммаризация текста, вопросы и ответы по локальным документам, создание веб-агентов прямо в браузере.
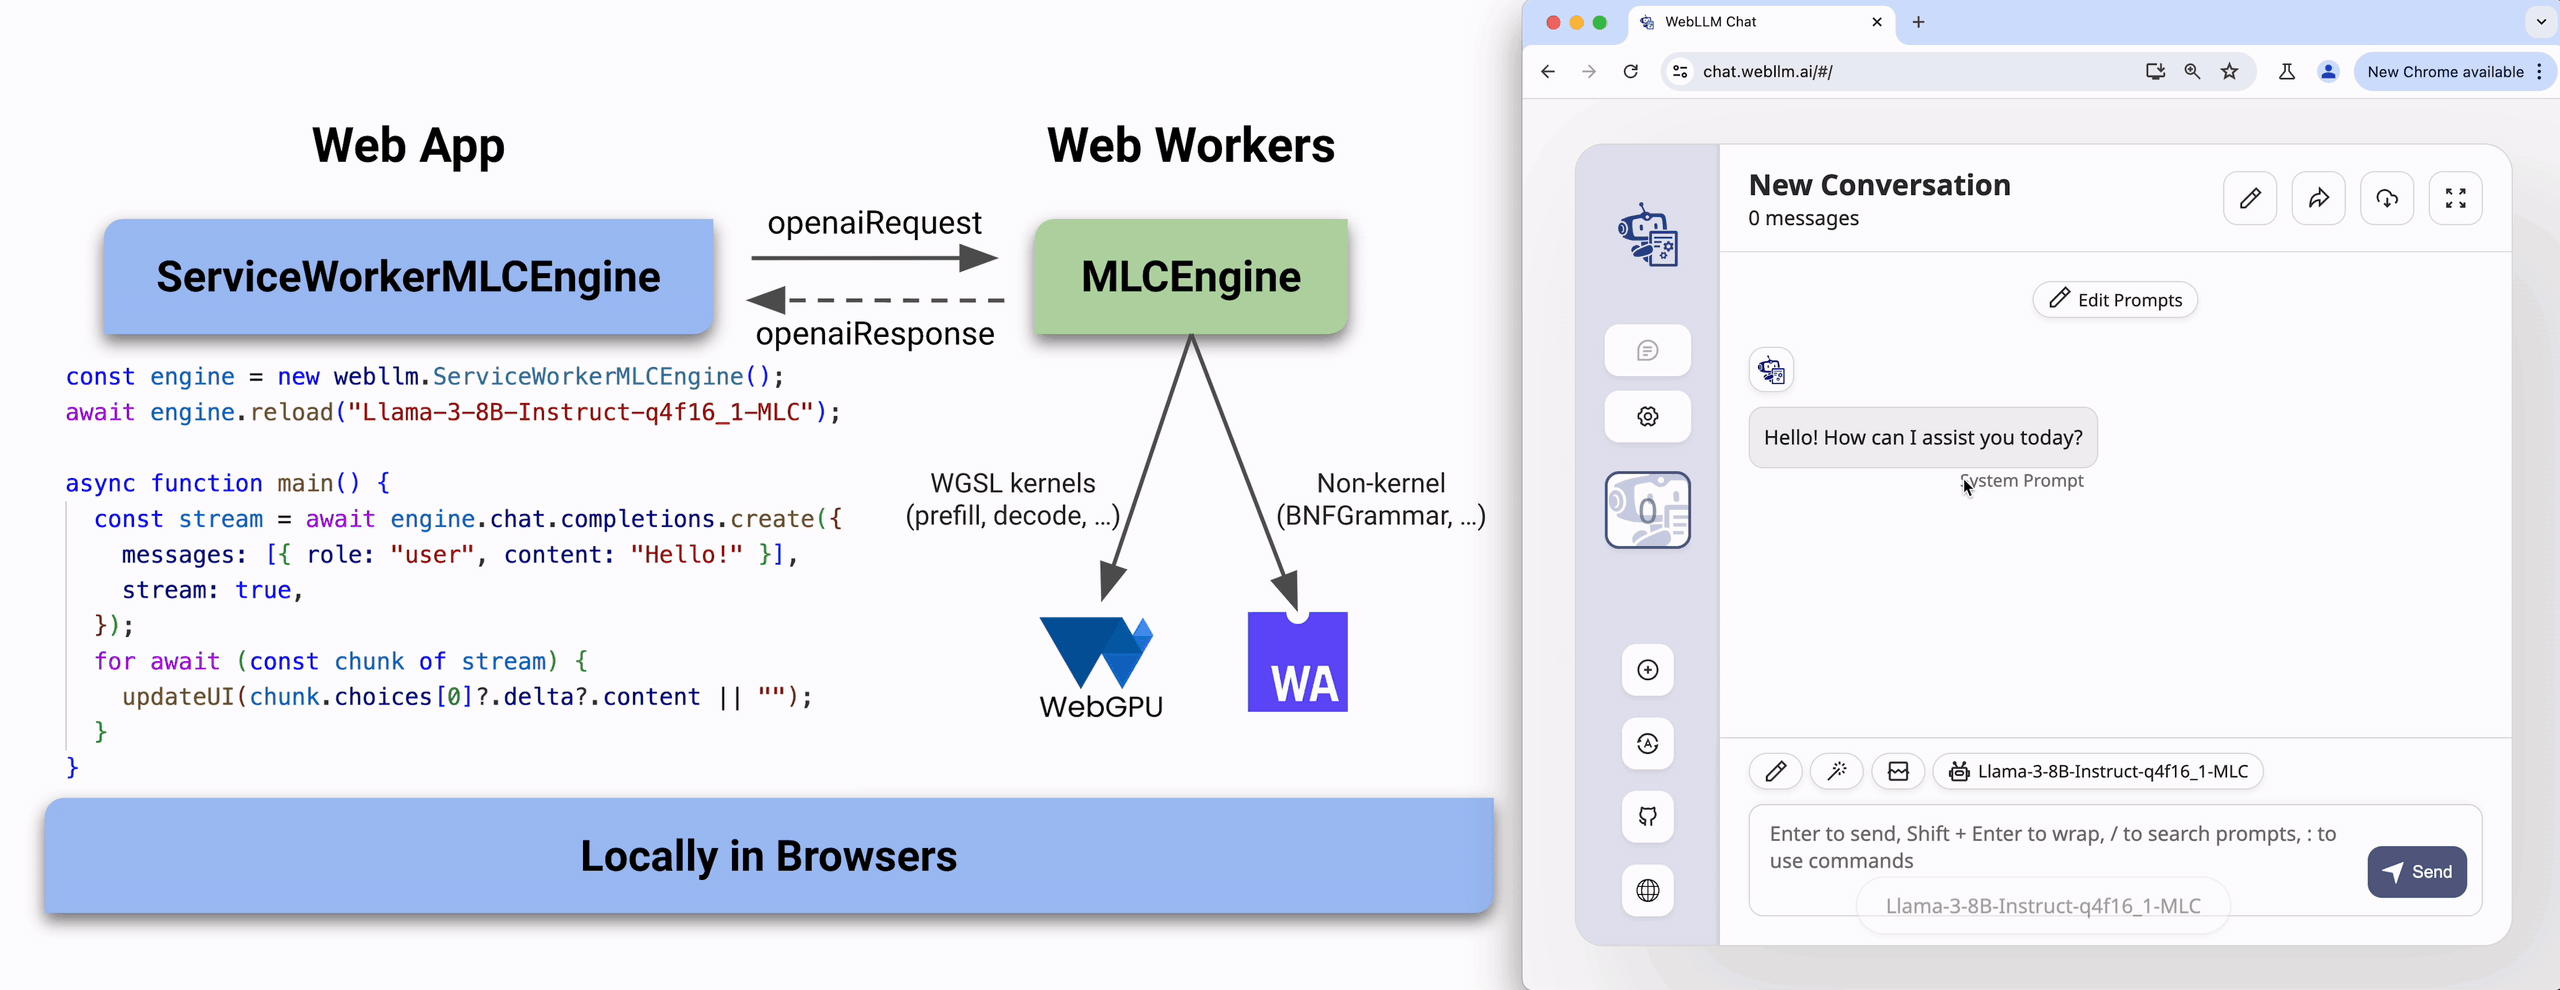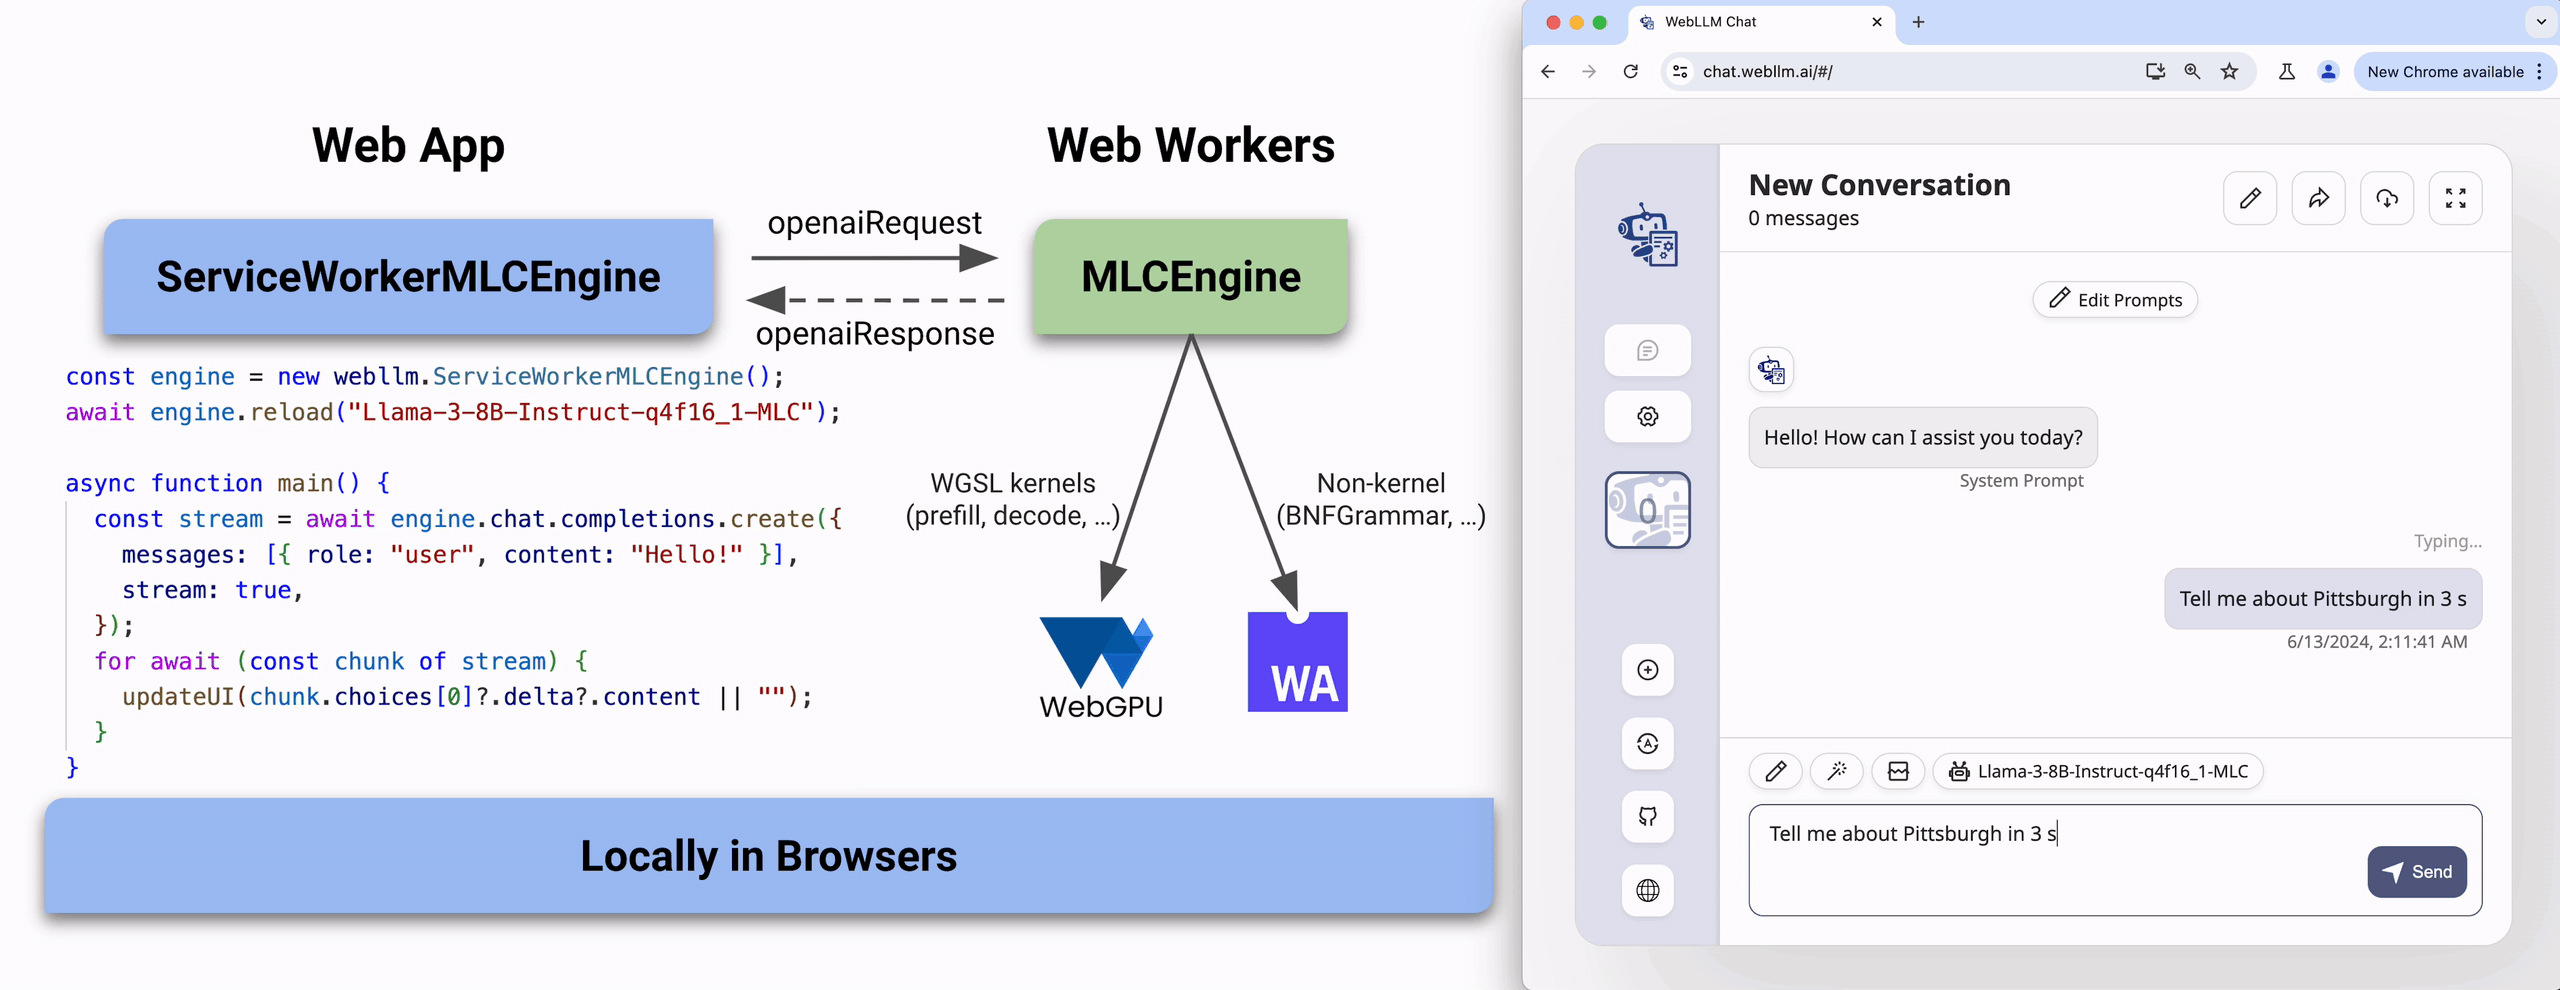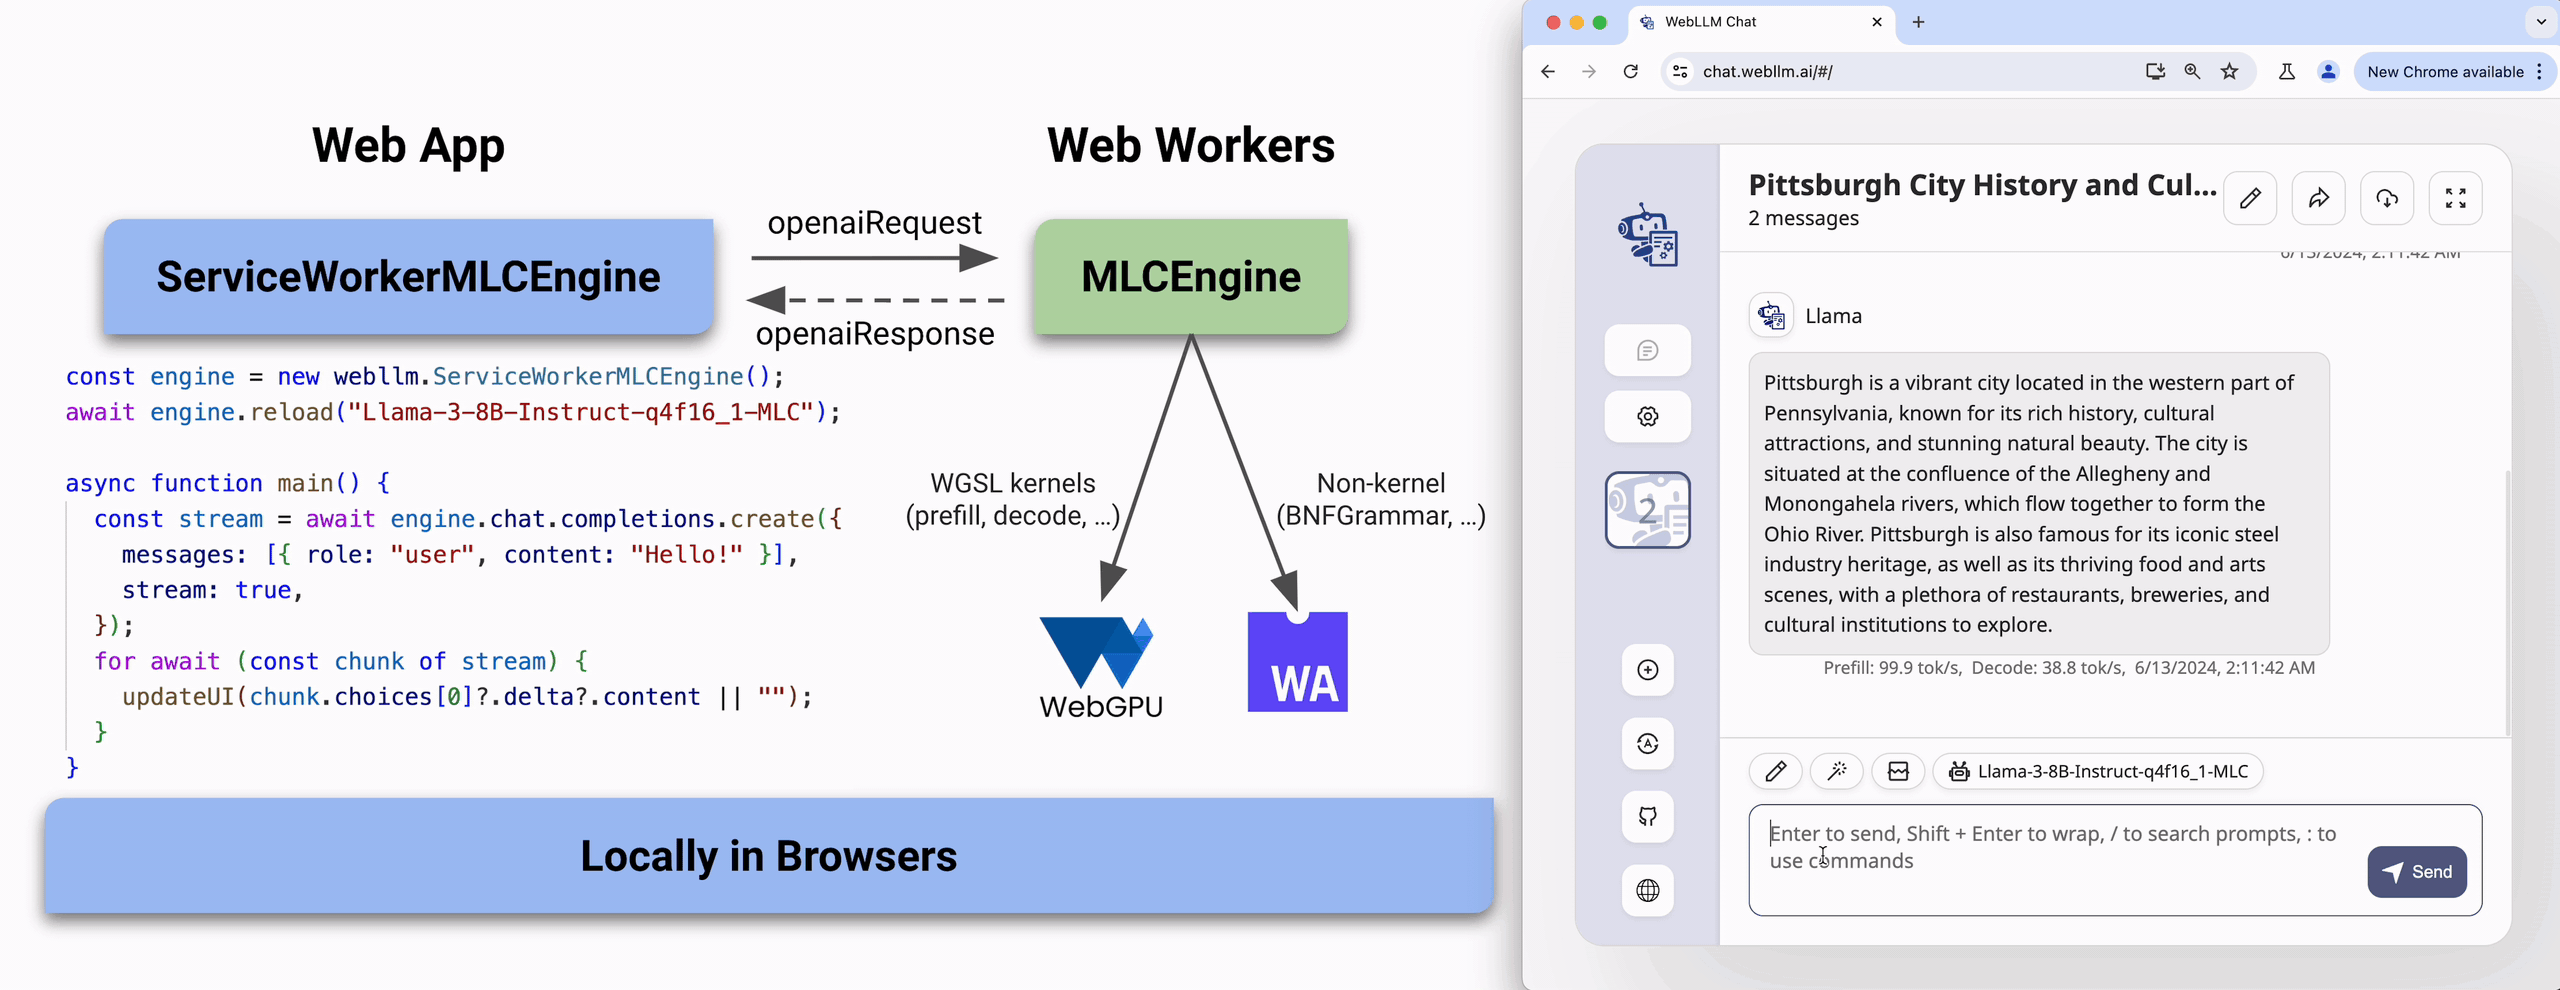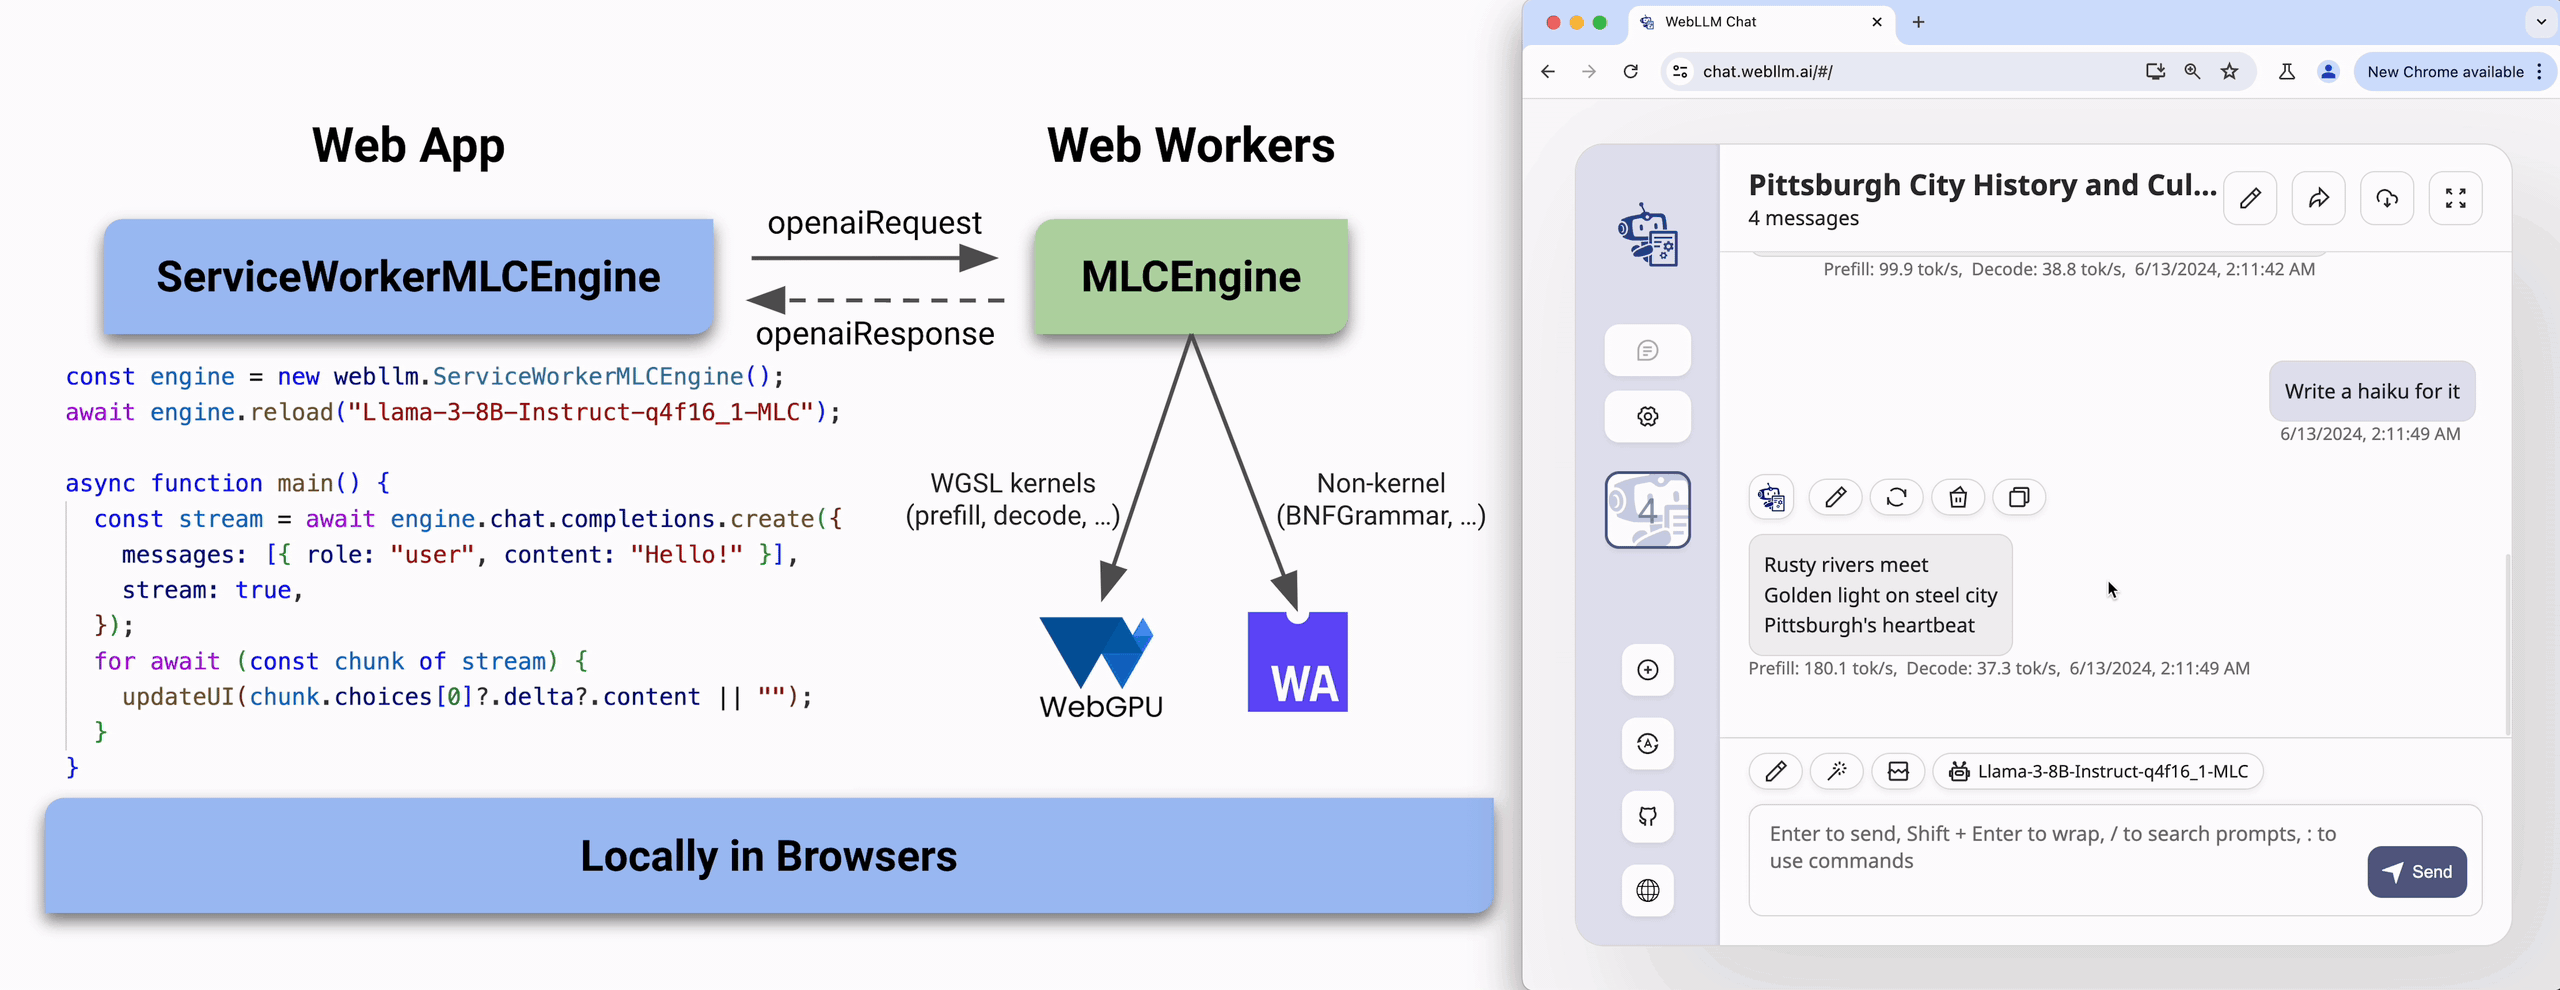
Чтобы встроить эффективное выполнение LLM в браузер, необходимо решить несколько ключевых задач: (1) обеспечить эффективное ускорение на GPU; (2) предоставить стандартизированный API, который разработчики веб-приложений смогут легко встроить в свой рабочий процесс; (3) грамотно вынести выполнение бэкенда в отдельный поток, чтобы не нарушать работу пользовательского интерфейса. Каждую из этих задач мы рассмотрим ниже.
Для ускорения на GPU WebLLM использует WebGPU и WebAssembly. WebGPU — новый стандарт W3C, позволяющий выполнять GPU-код прямо в браузере. Он уже интегрирован в крупные браузеры — Chrome, Edge и Firefox — и в перспективе будет поддержан всеми браузерами. Браузеры реализуют WebGPU, транслируя шейдеры на языке WGSL (WebGPU Shading Language) в нативные GPU-шейдеры: это позволяет веб-приложениям пользоваться GPU-ускорением, абстрагируясь от конкретных бэкендов (MacBook, ноутбук с NVIDIA, Android-телефон). В отличие от популярных платформ вроде NVIDIA, WebGPU — платформа молодая и не имеет готовых ускоренных GPU-библиотек. Поэтому мы используем MLC LLM для компиляции эффективных WebGPU-ядер и встраиваем их в WASM-библиотеку, которая затем работает совместно с рантаймом WebLLM для выполнения LLM-инференса в браузере.
Движок WebLLM предоставляет интерфейс в стиле OpenAI API для стандартизированной интеграции — с поддержкой чат-приложений и эффективной структурированной генерации JSON. Кроме того, в него встроена поддержка Web Workers и Service Workers, благодаря чему выполнение бэкенда не зависит от потока UI. WebLLM разделяет многие оптимизационные подходы с MLCEngine, что обеспечивает поддержку актуальных моделей посредством компиляции машинного обучения (machine learning compilation).
Общая архитектура
Архитектуру WebLLM можно разделить на три части, как показано на рисунке 2. Разработчики веб-приложений взаимодействуют только с частью Web App. (Примечание: мы поддерживаем как Service Worker, так и Web Worker, но в этой статье сосредоточимся на первом варианте.)
Web App. Разработчик создаёт экземпляр ServiceWorkerMLCEngine во фронтенде веб-приложения и работает с ним как с эндпоинтом. ServiceWorkerMLCEngine загружает указанную модель (например, Llama3 или Phi3), принимает запросы в стиле OpenAI в любой момент и возвращает ответ потоком. Всё просто!
Web Workers. Мы скрываем все тяжёлые вычисления в фоновом потоке посредством различных видов Web Workers (например, Service Workers) — это упрощает разработку веб-приложений и гарантирует плавную работу интерфейса. Под капотом ServiceWorkerMLCEngine обменивается сообщениями с внутренним MLCEngine в рабочем потоке (worker thread), пересылая запросы в формате OpenAI API и получая потоковые ответы обратно. MLCEngine загружает указанную модель, выполняет WGSL-ядра через WebGPU (который транслирует их в нативный GPU-код) и запускает функции без ядер через WebAssembly. Всё это происходит внутри рабочего потока браузера с производительностью, близкой к нативной.
Этап компиляции. Модель, которую загружает MLCEngine, компилируется заранее (ahead of time) и размещается онлайн. Мы используем MLC-LLM и Apache TVM для компиляции любой открытой модели (например, Llama3 или Phi3) в два компонента: конвертированные/квантованные веса модели и WASM-библиотеку. WASM-библиотека содержит как вычислительные ядра на WGSL (например, prefill и decode), так и функции без ядер на WebAssembly (например, BNFGrammar для режима JSON). WebLLM предоставляет предсобранные модели и одновременно позволяет использовать собственные. Веса и WASM загружаются один раз и кэшируются локально.
Использование WebLLM через OpenAI-style API
При создании движка инференса в браузере крайне важно разработать набор API, знакомых разработчикам и удобных в использовании. Именно поэтому мы выбрали интерфейс в стиле OpenAI API. Разработчики могут применять WebLLM как прямую замену OpenAI API — но с любыми открытыми моделями и локальным инференсом.
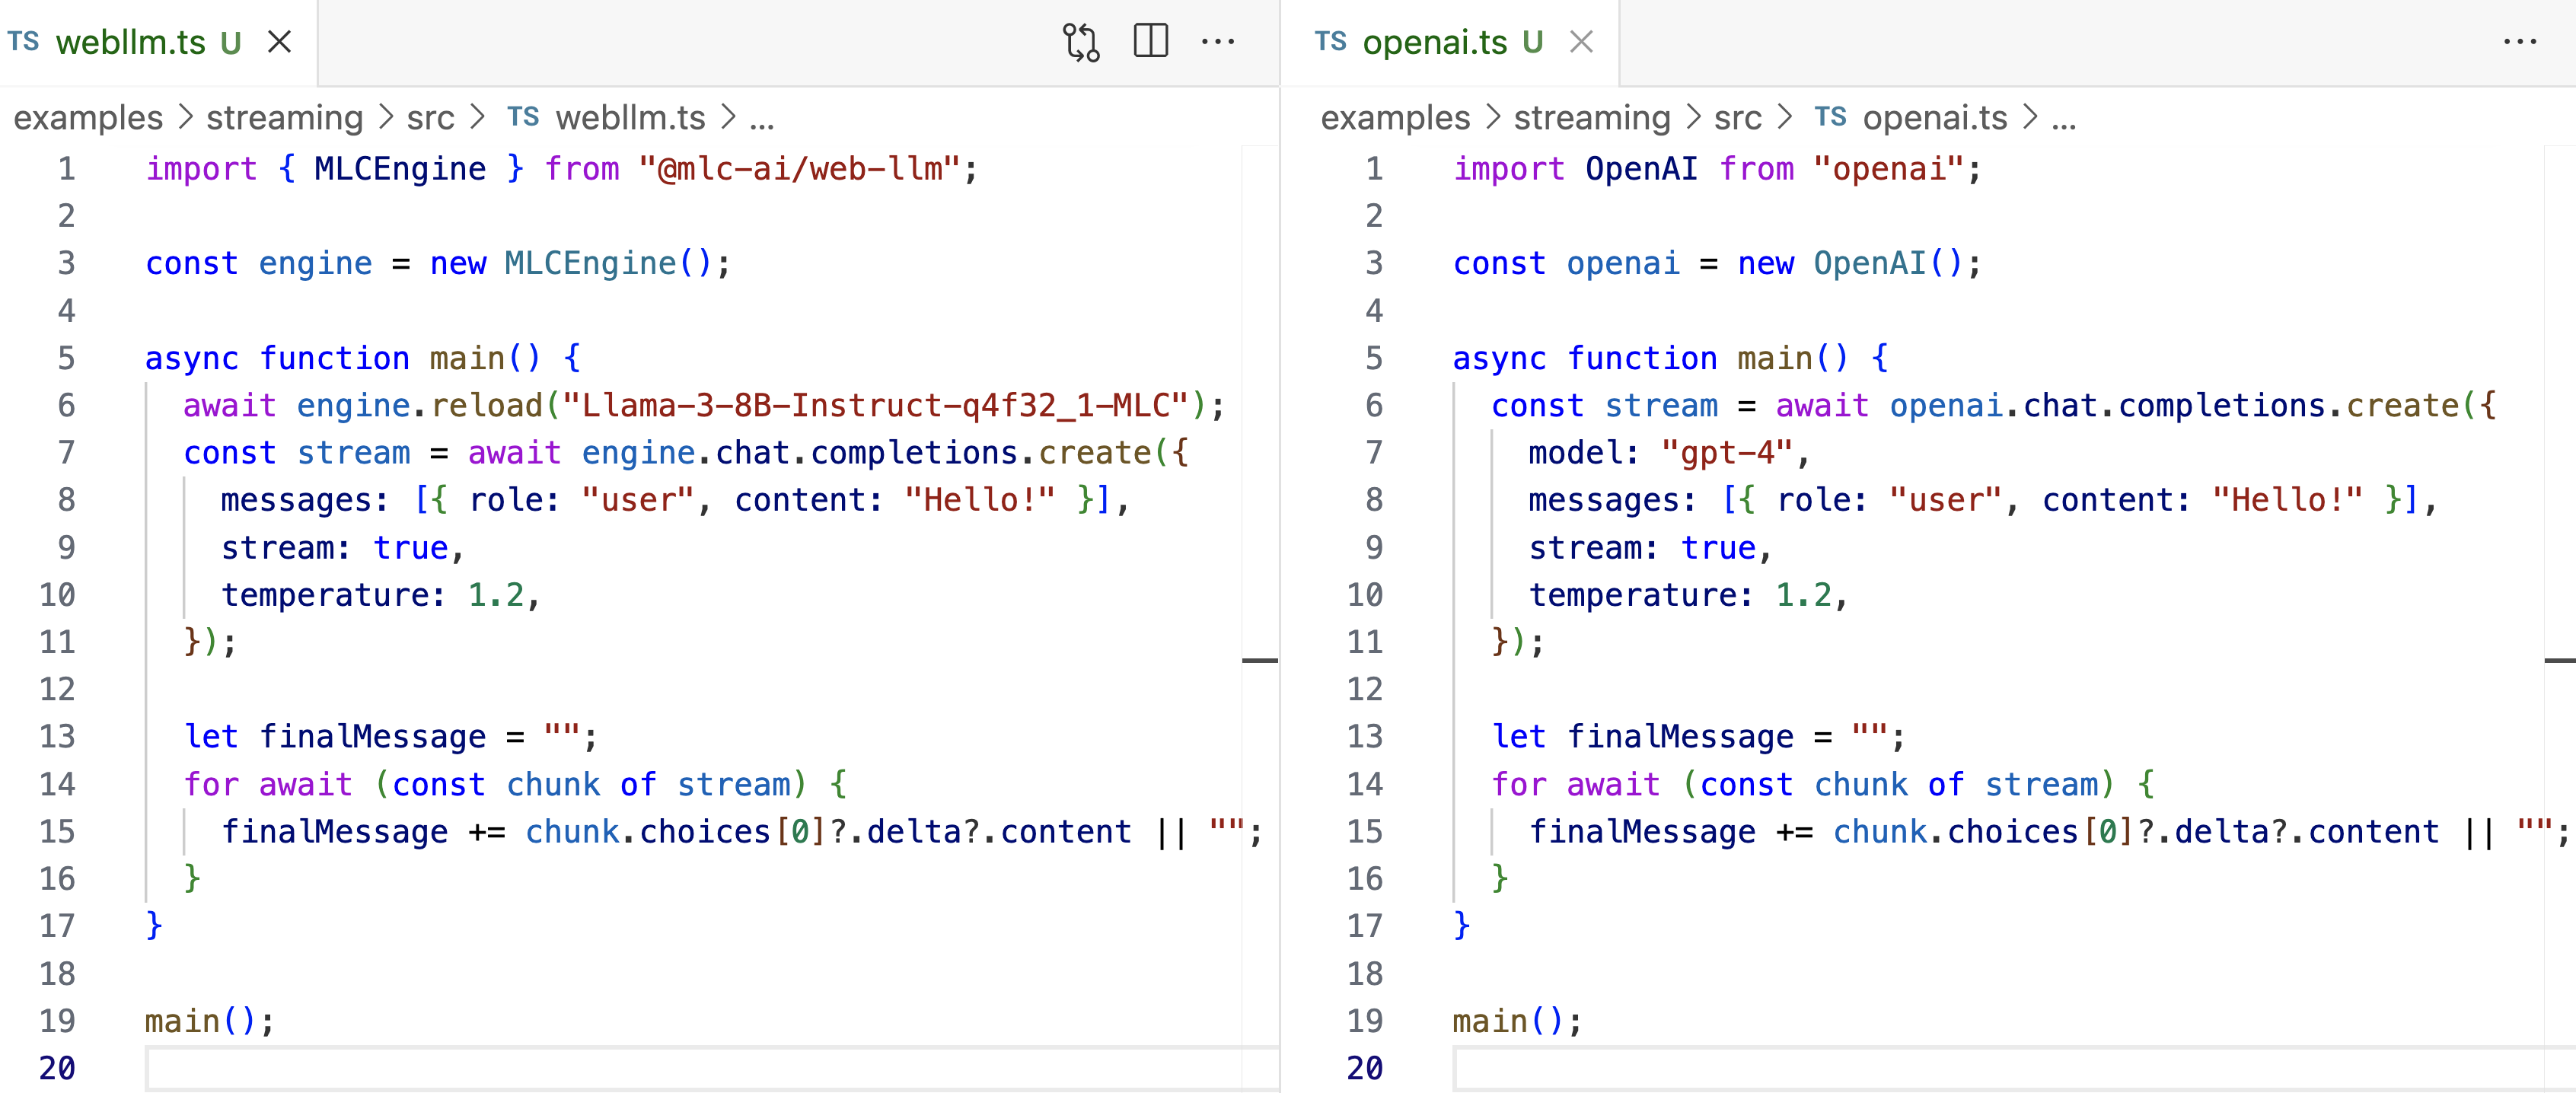
Как и OpenAI API, WebLLM поддерживает потоковую передачу (streaming), управление логитами через параметры logit_bias и logprobs, параметры генерации temperature и frequency_penalty, а также задание начального значения (seed) для воспроизводимых результатов.
Таким образом, WebLLM не только внешне повторяет OpenAI API, но и поддерживает все возможности OpenAI API для LLM (по состоянию на июнь 2024 года).
Начало работы с MLCEngine в WebLLM
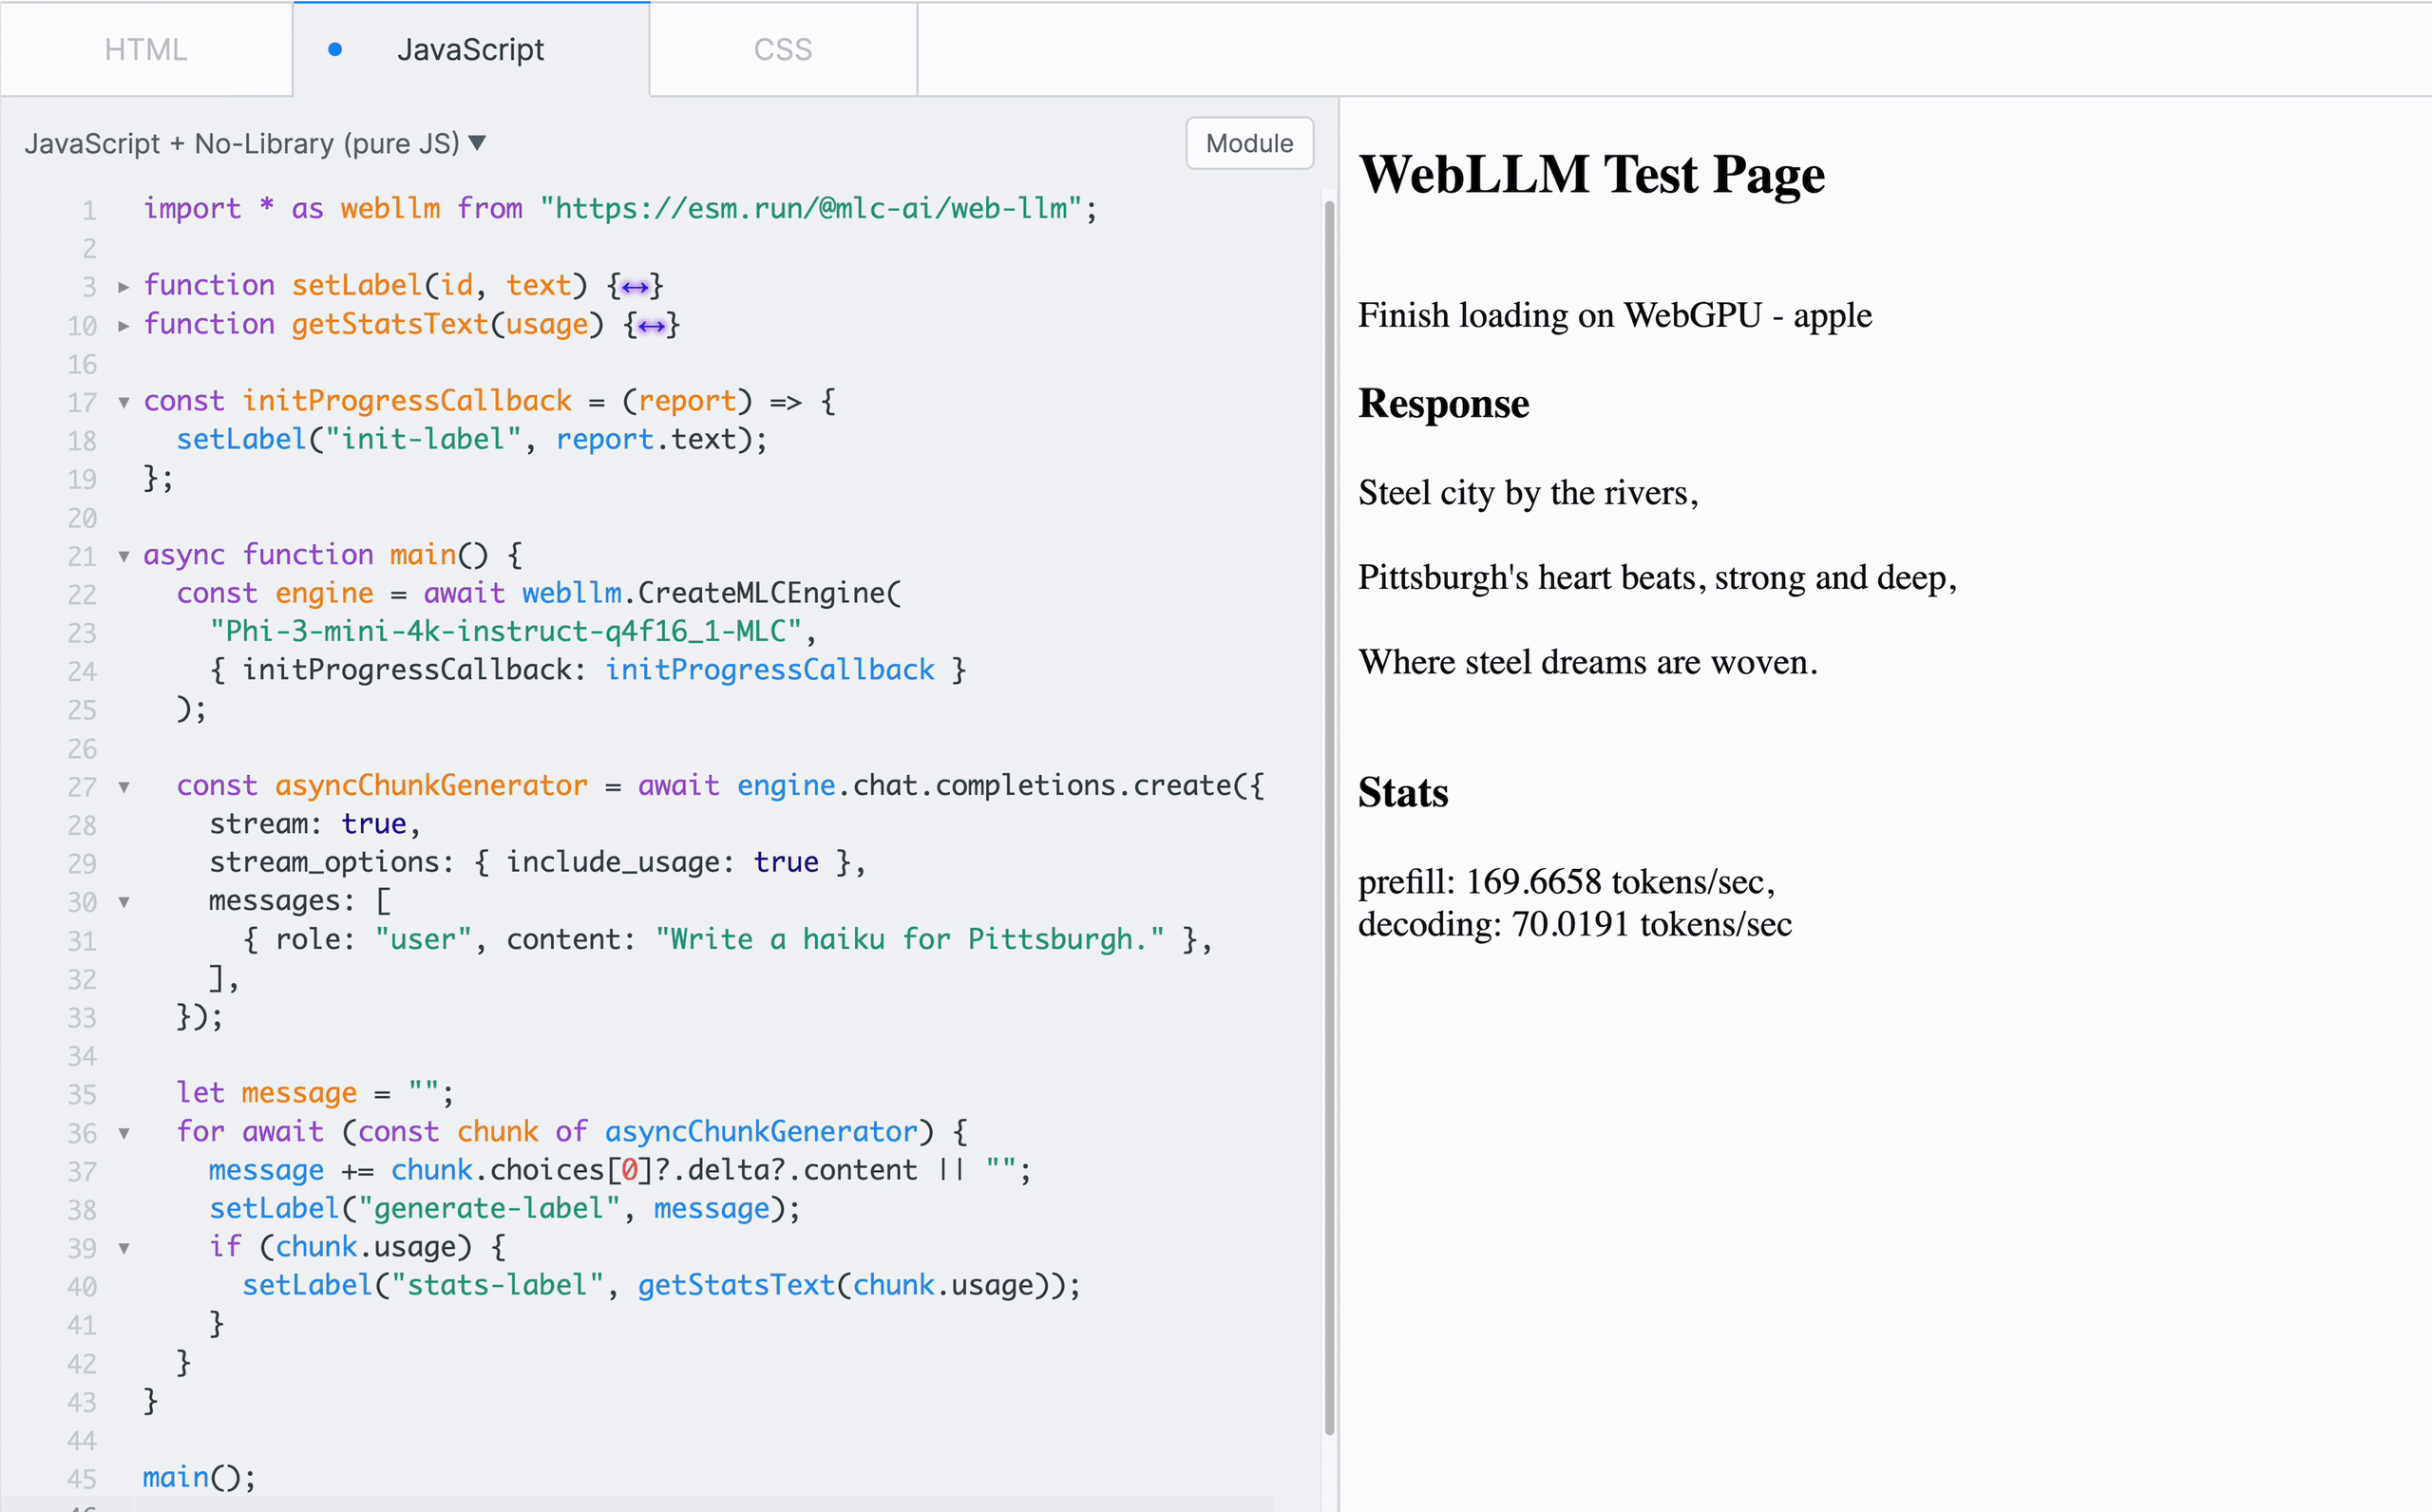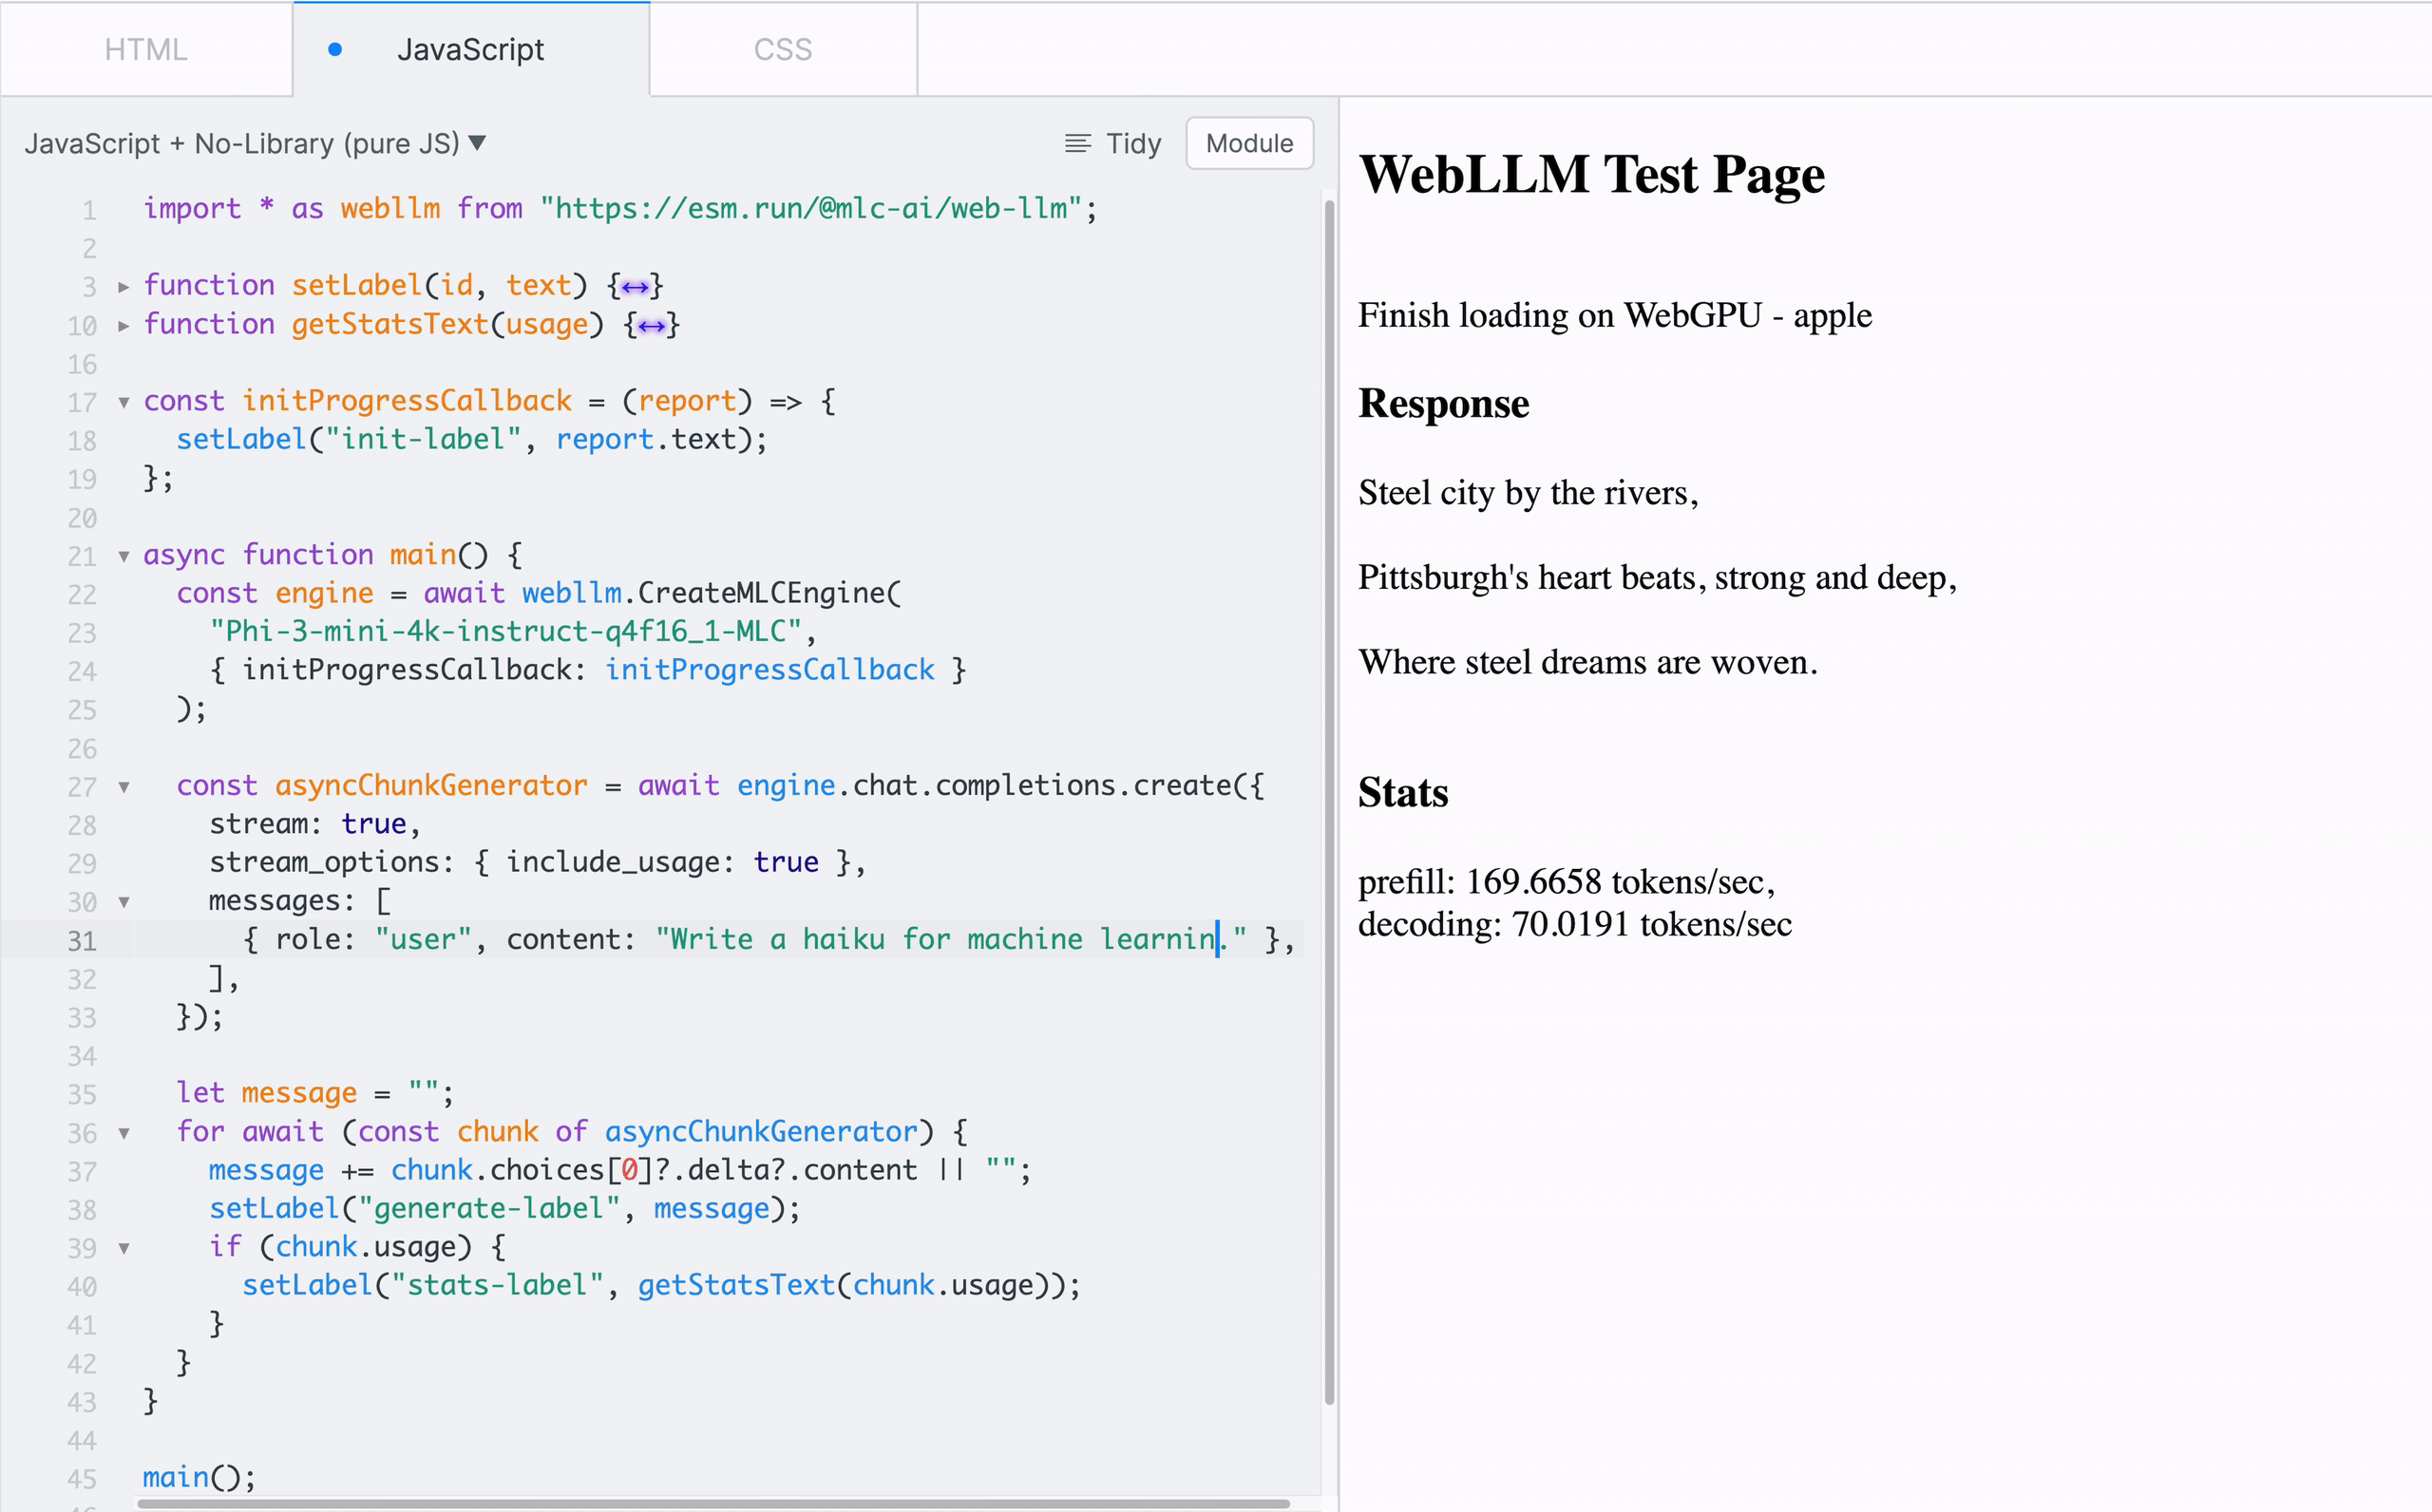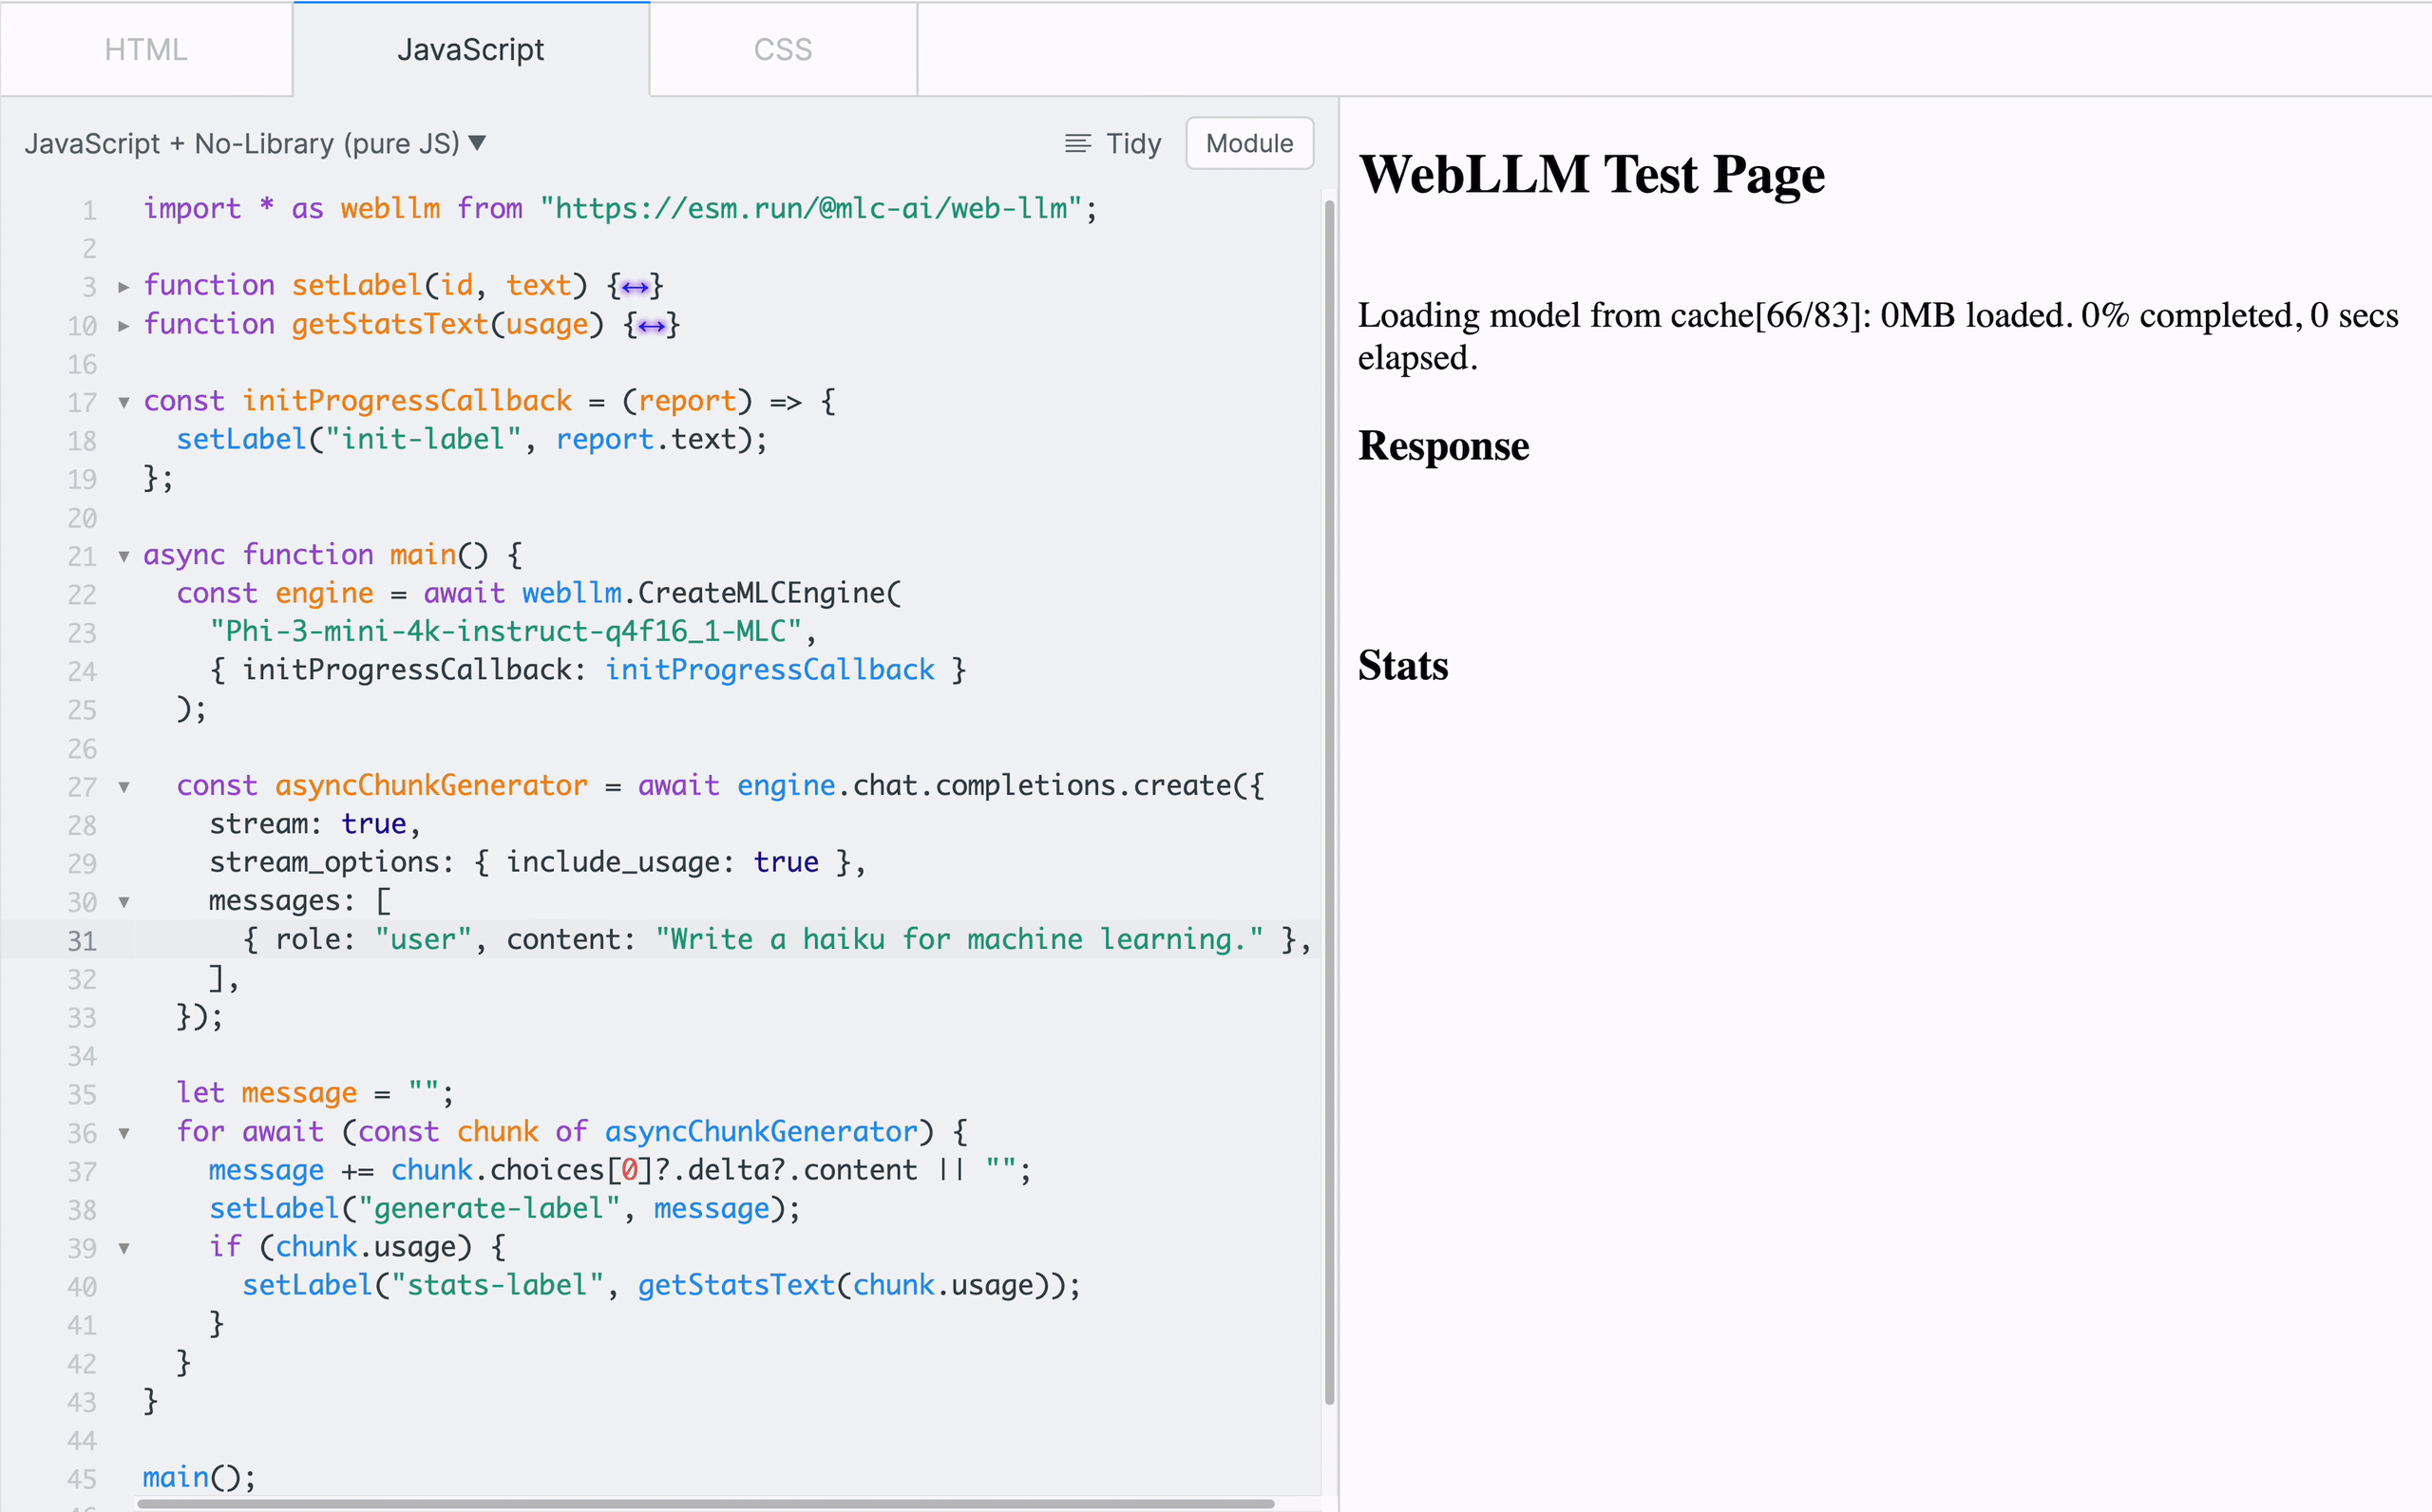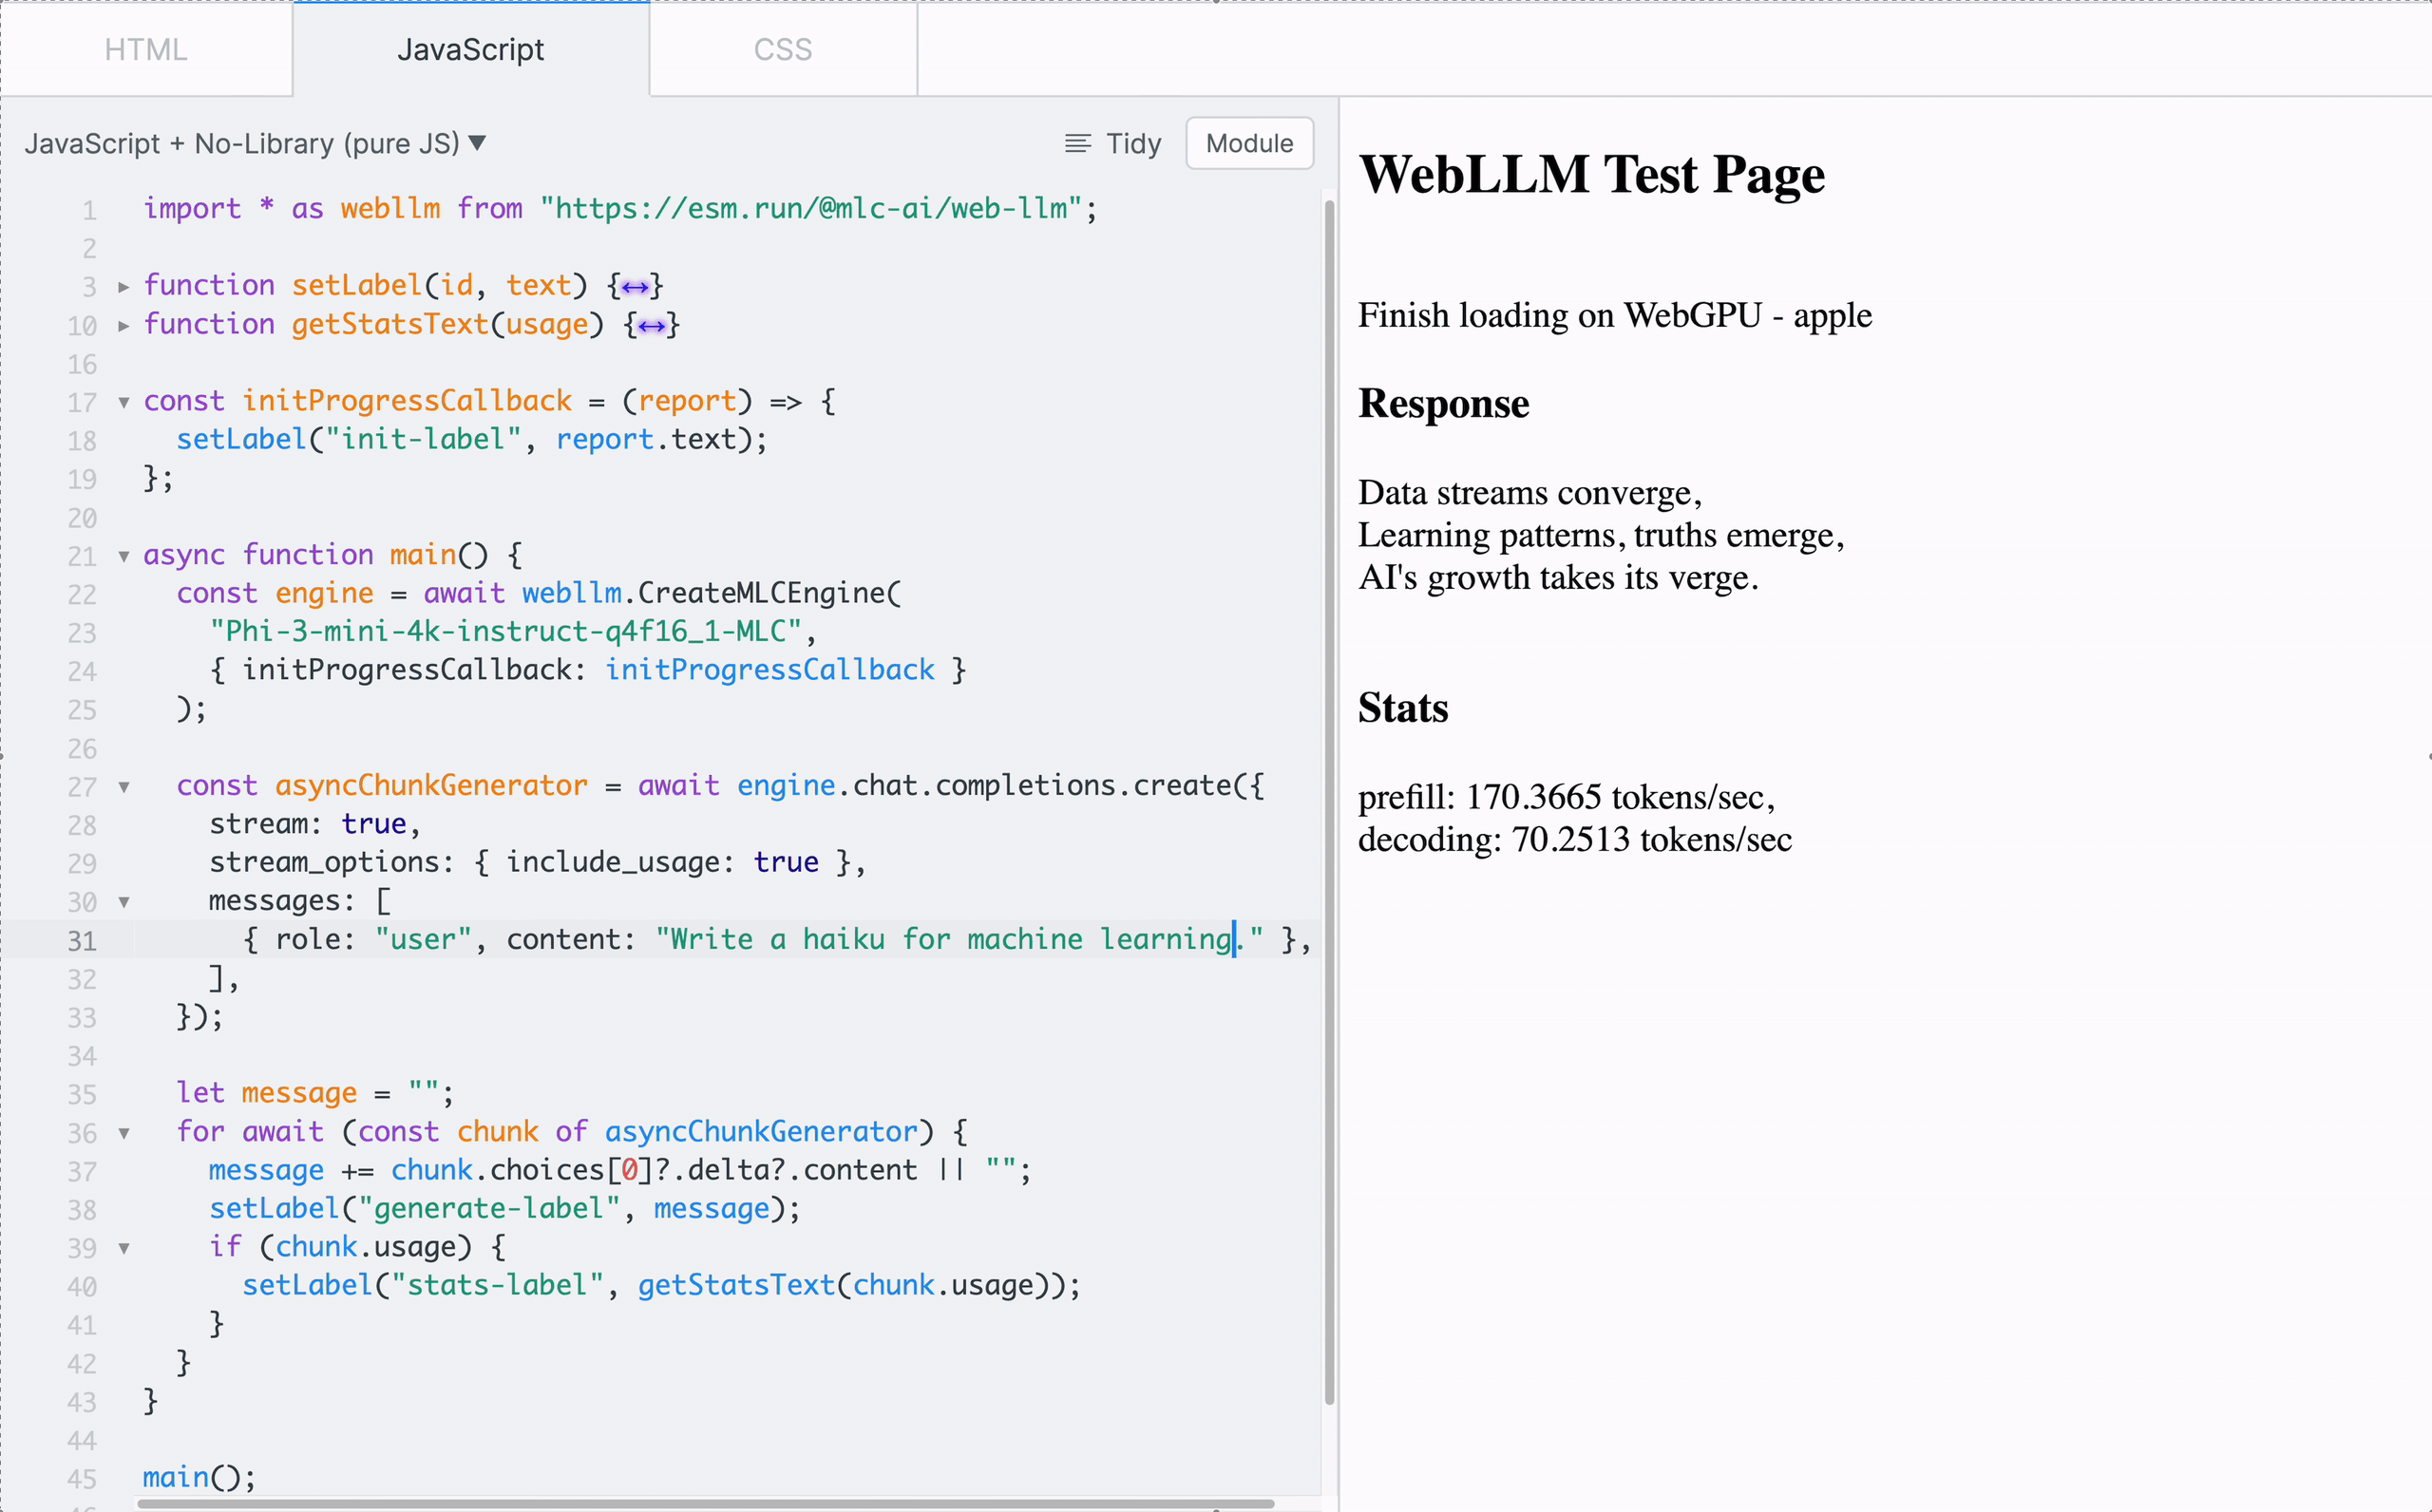
Чтобы познакомиться с возможностями WebLLM, можно начать с низкоуровневого MLCEngine в sandbox-среде вроде JSFiddle, используя пакет WebLLM, доставляемый через CDN, — как показано на рисунке 4.
Разработка веб-приложений с WebLLM
Поскольку мы позиционируем WebLLM как бэкенд для веб-приложений с поддержкой ИИ, мы вложили значительные усилия в то, чтобы упростить процесс разработки таких приложений. Все тяжёлые вычисления скрыты в рабочем потоке, так что разработчику достаточно взаимодействовать только с ServiceWorkerMLCEngine, воспринимая его как эндпоинт, открытый для фронтенда.
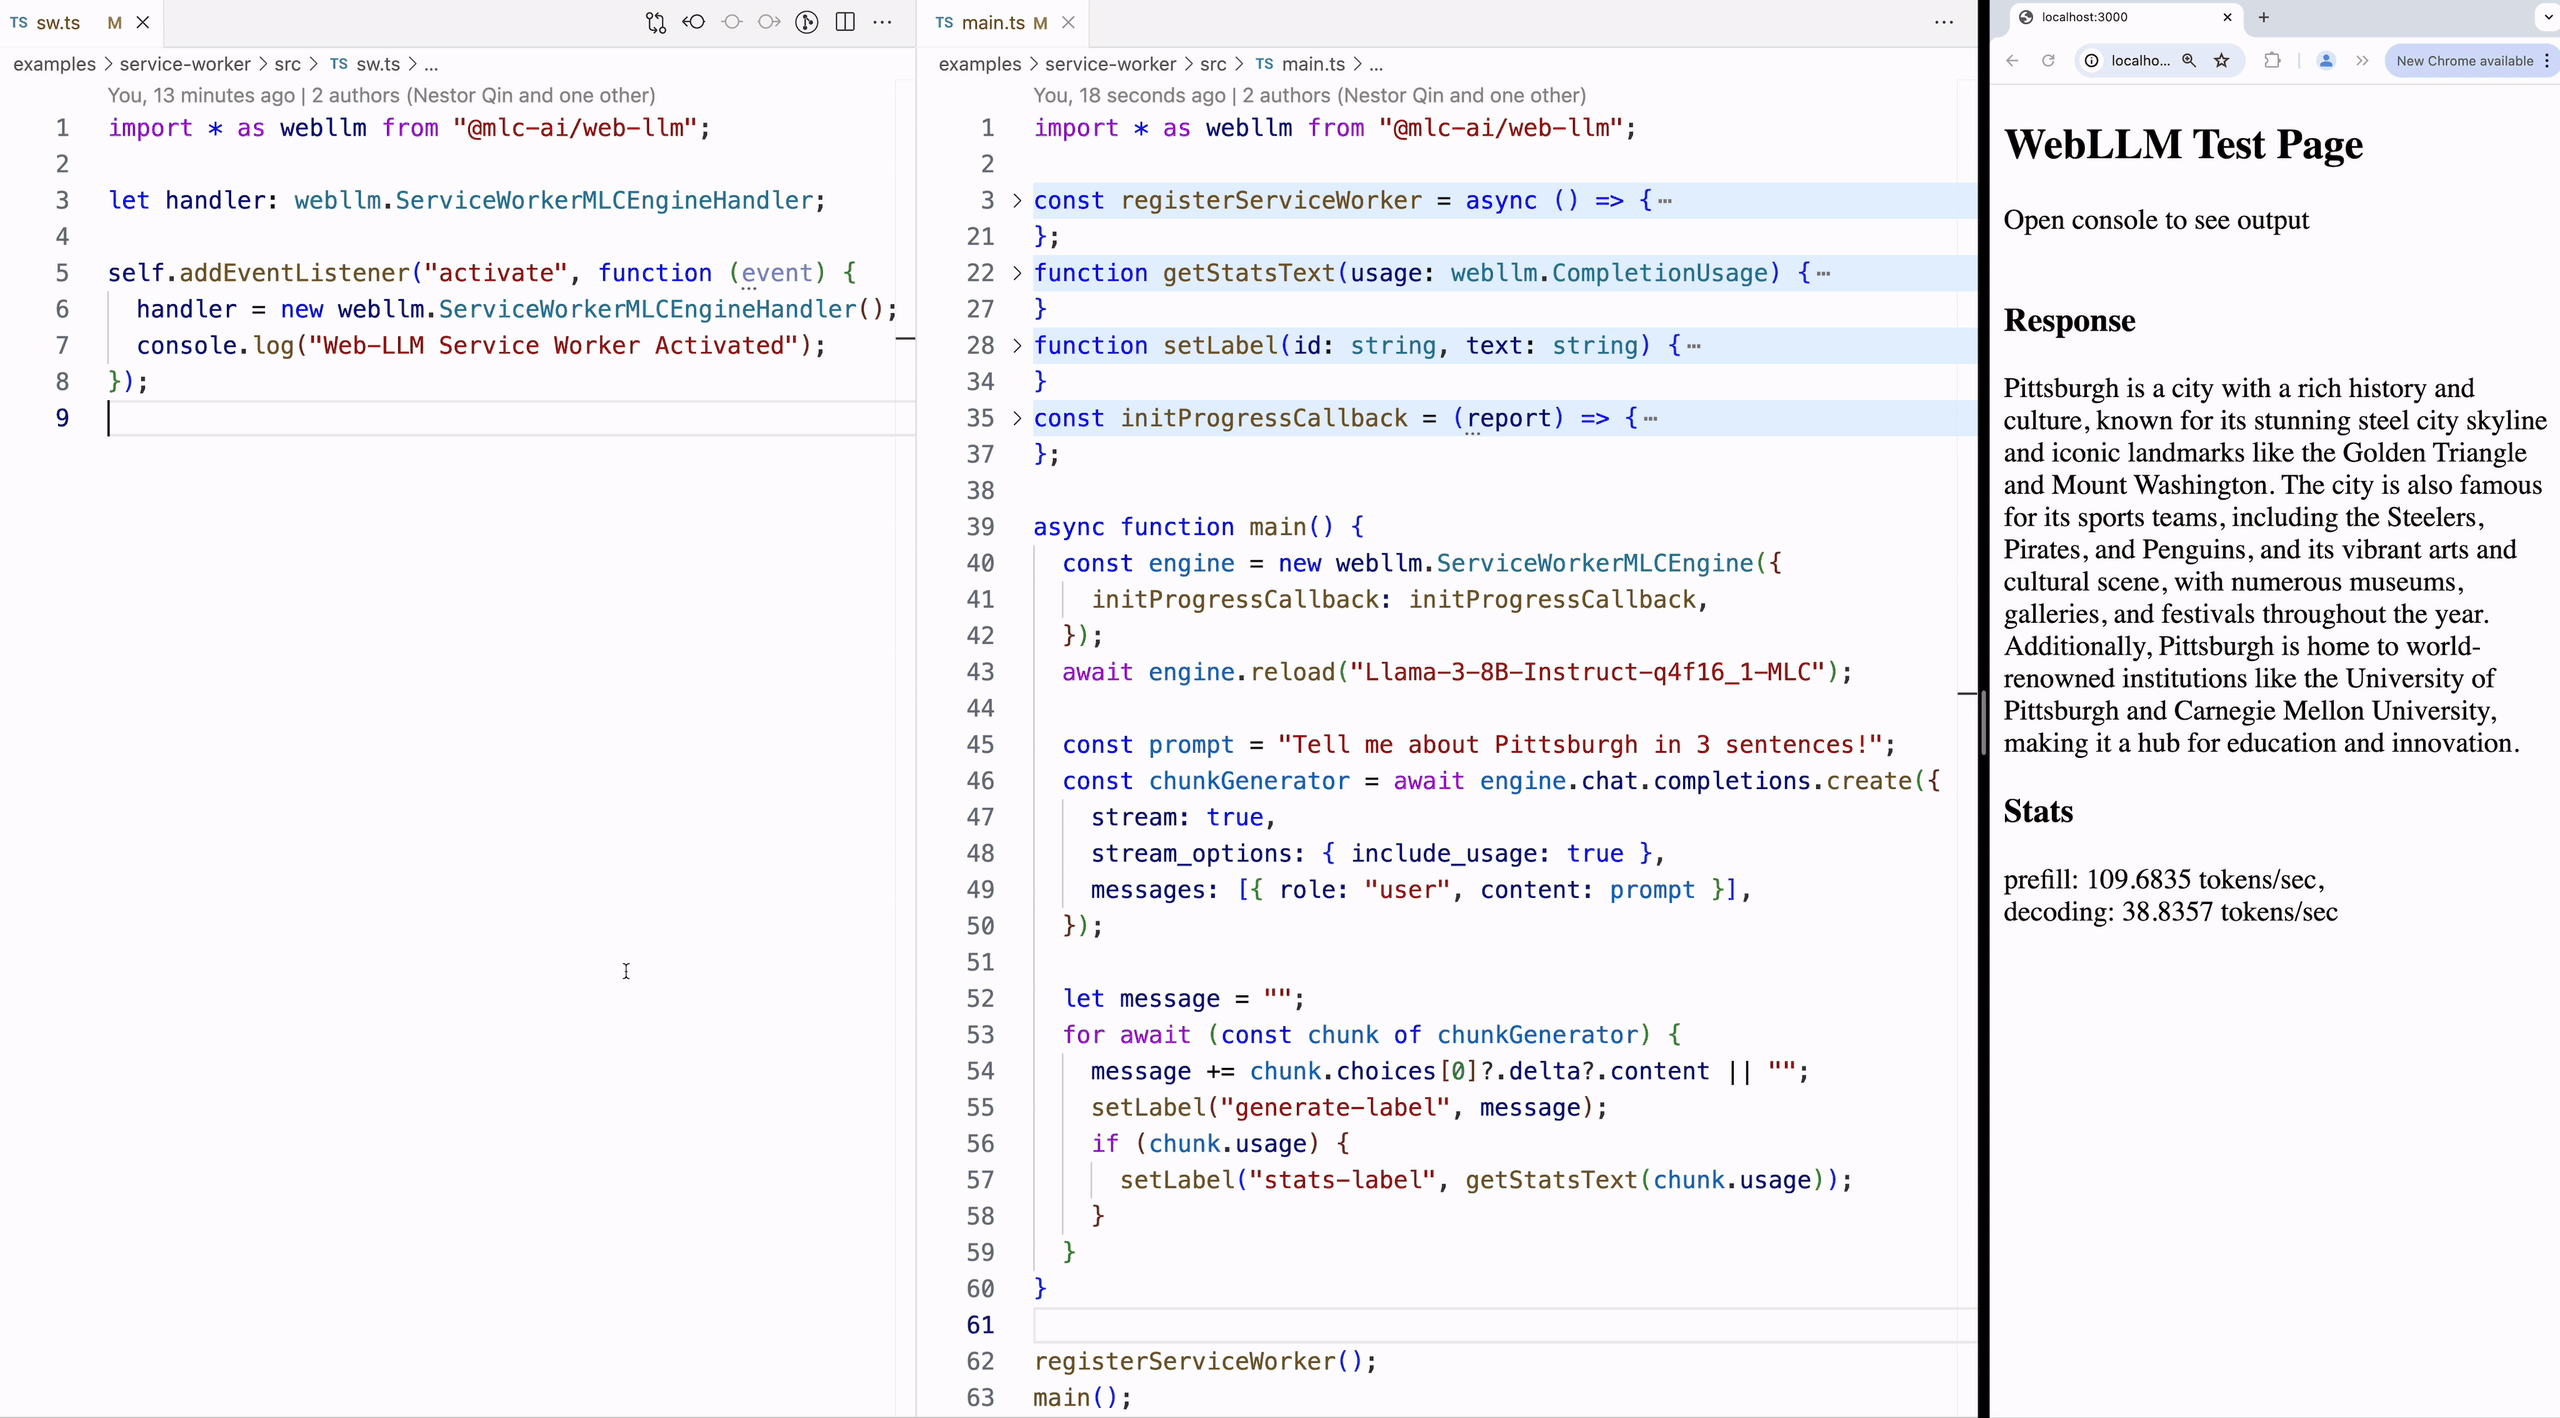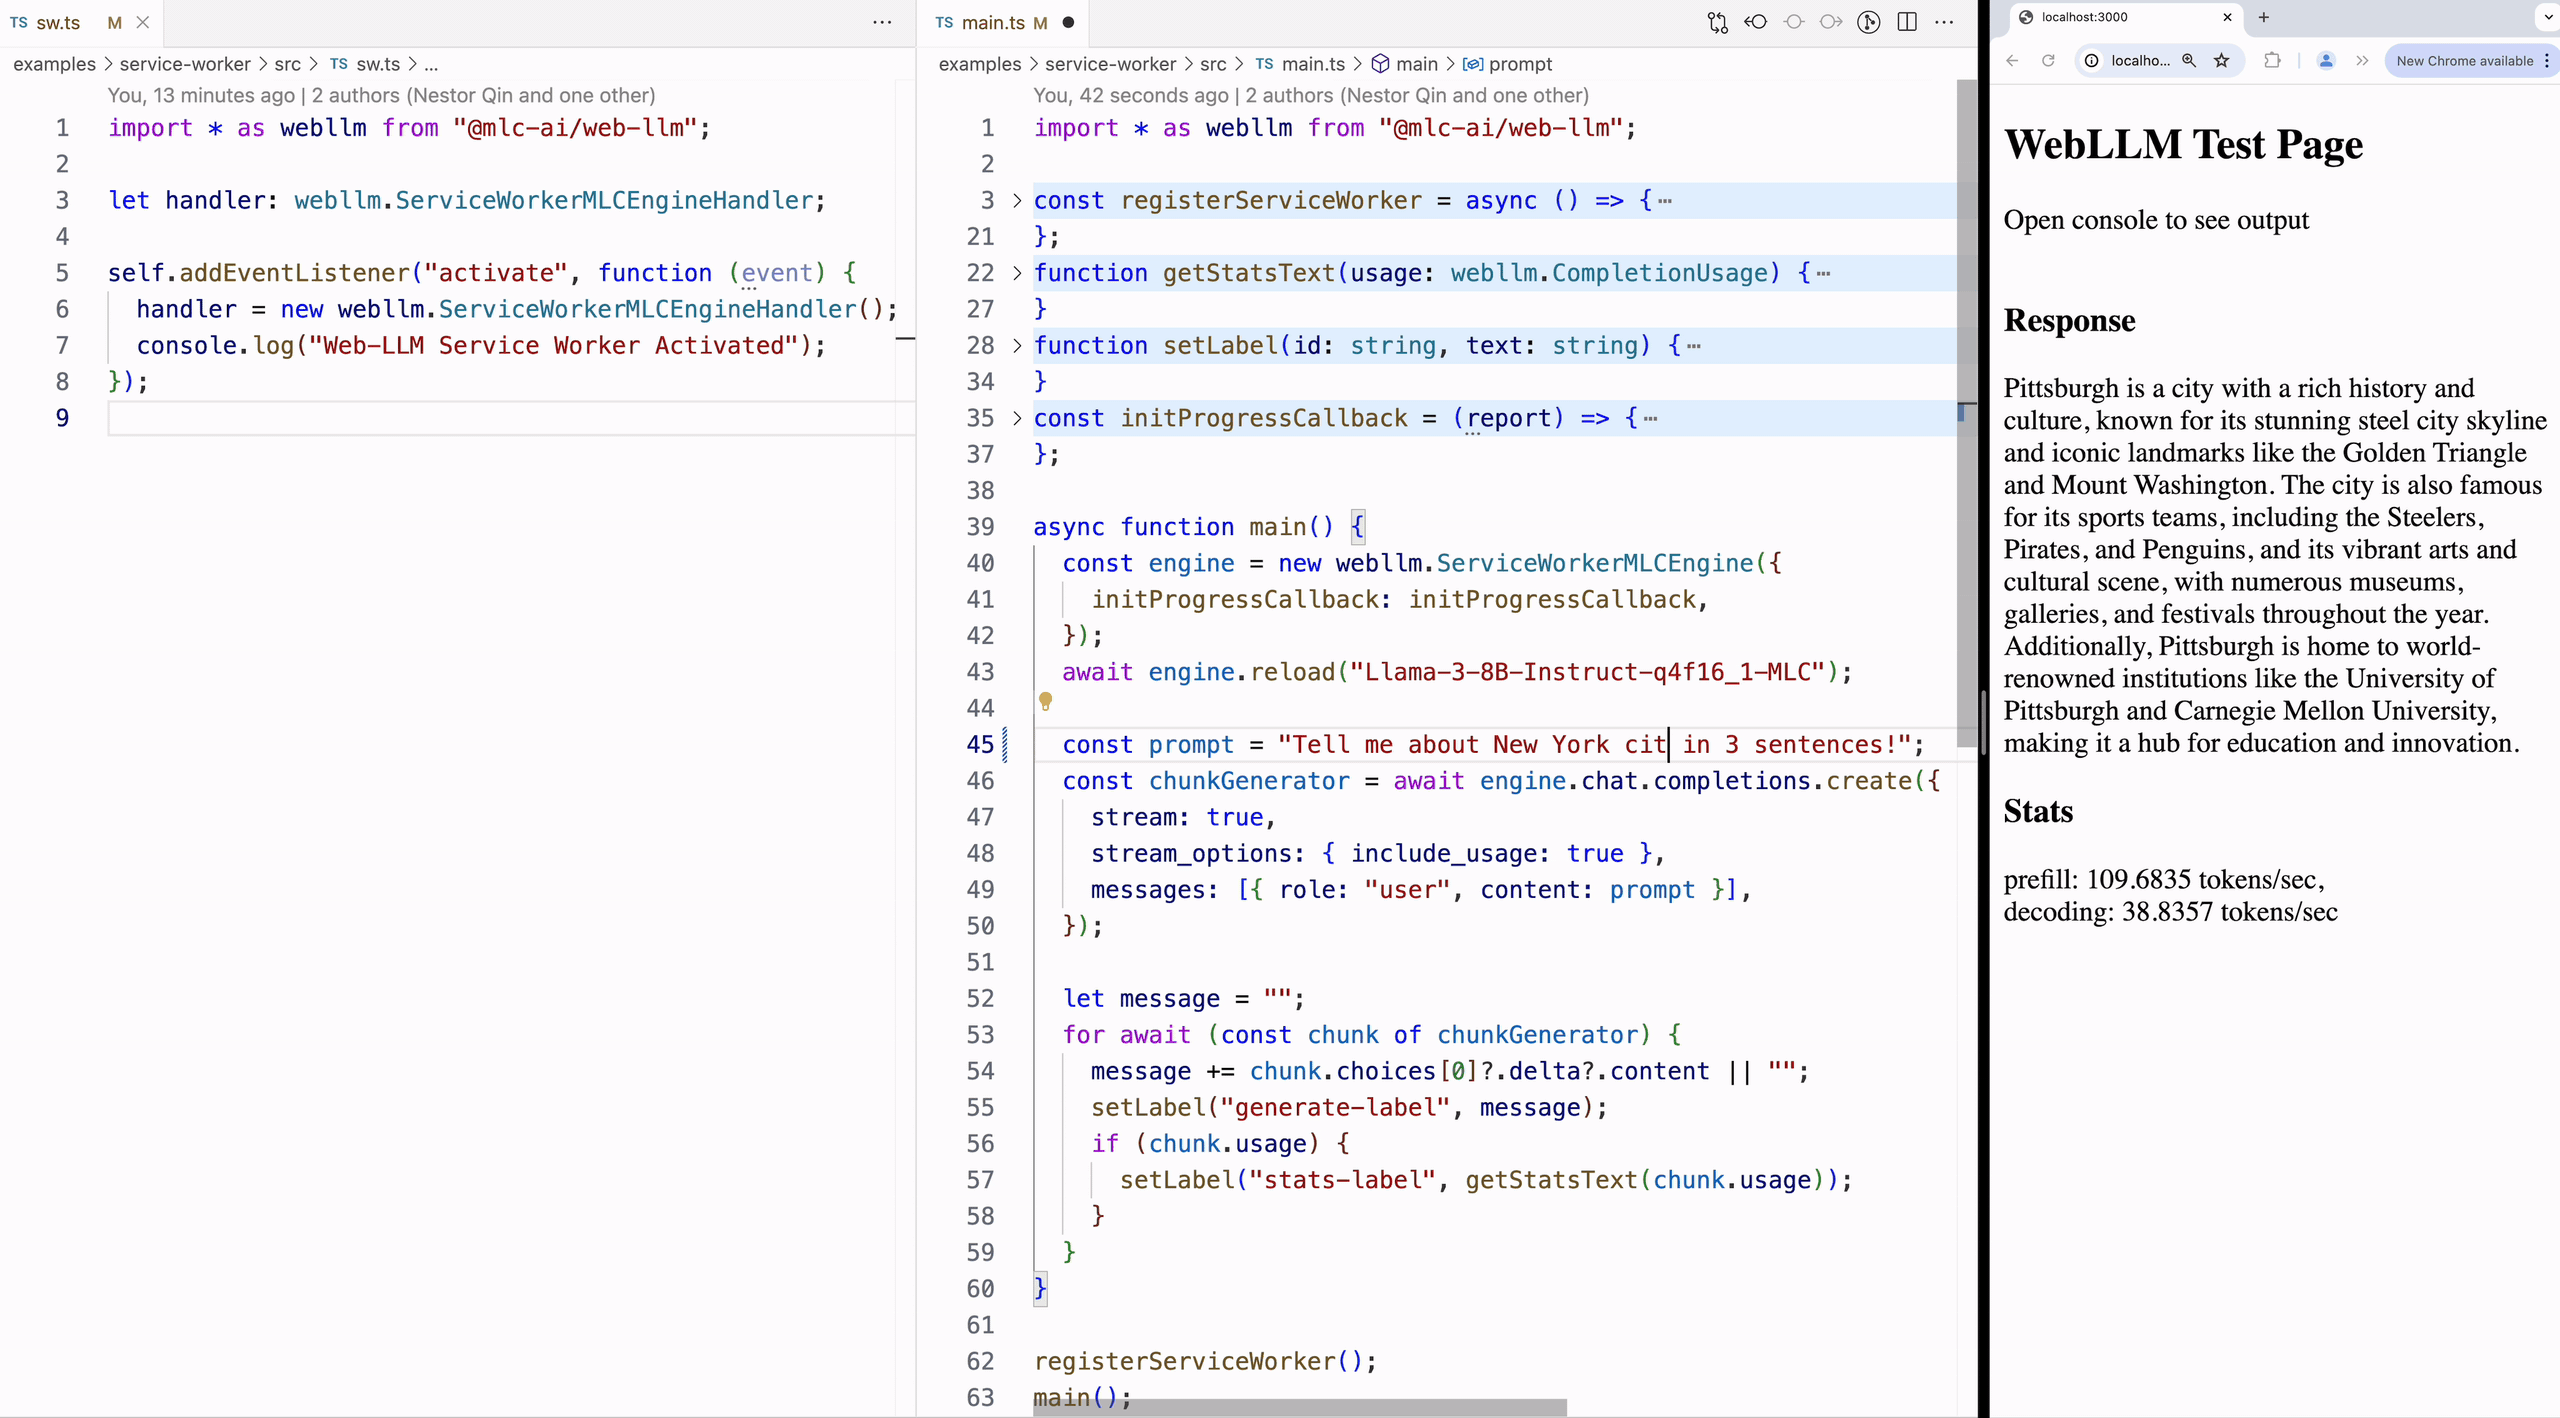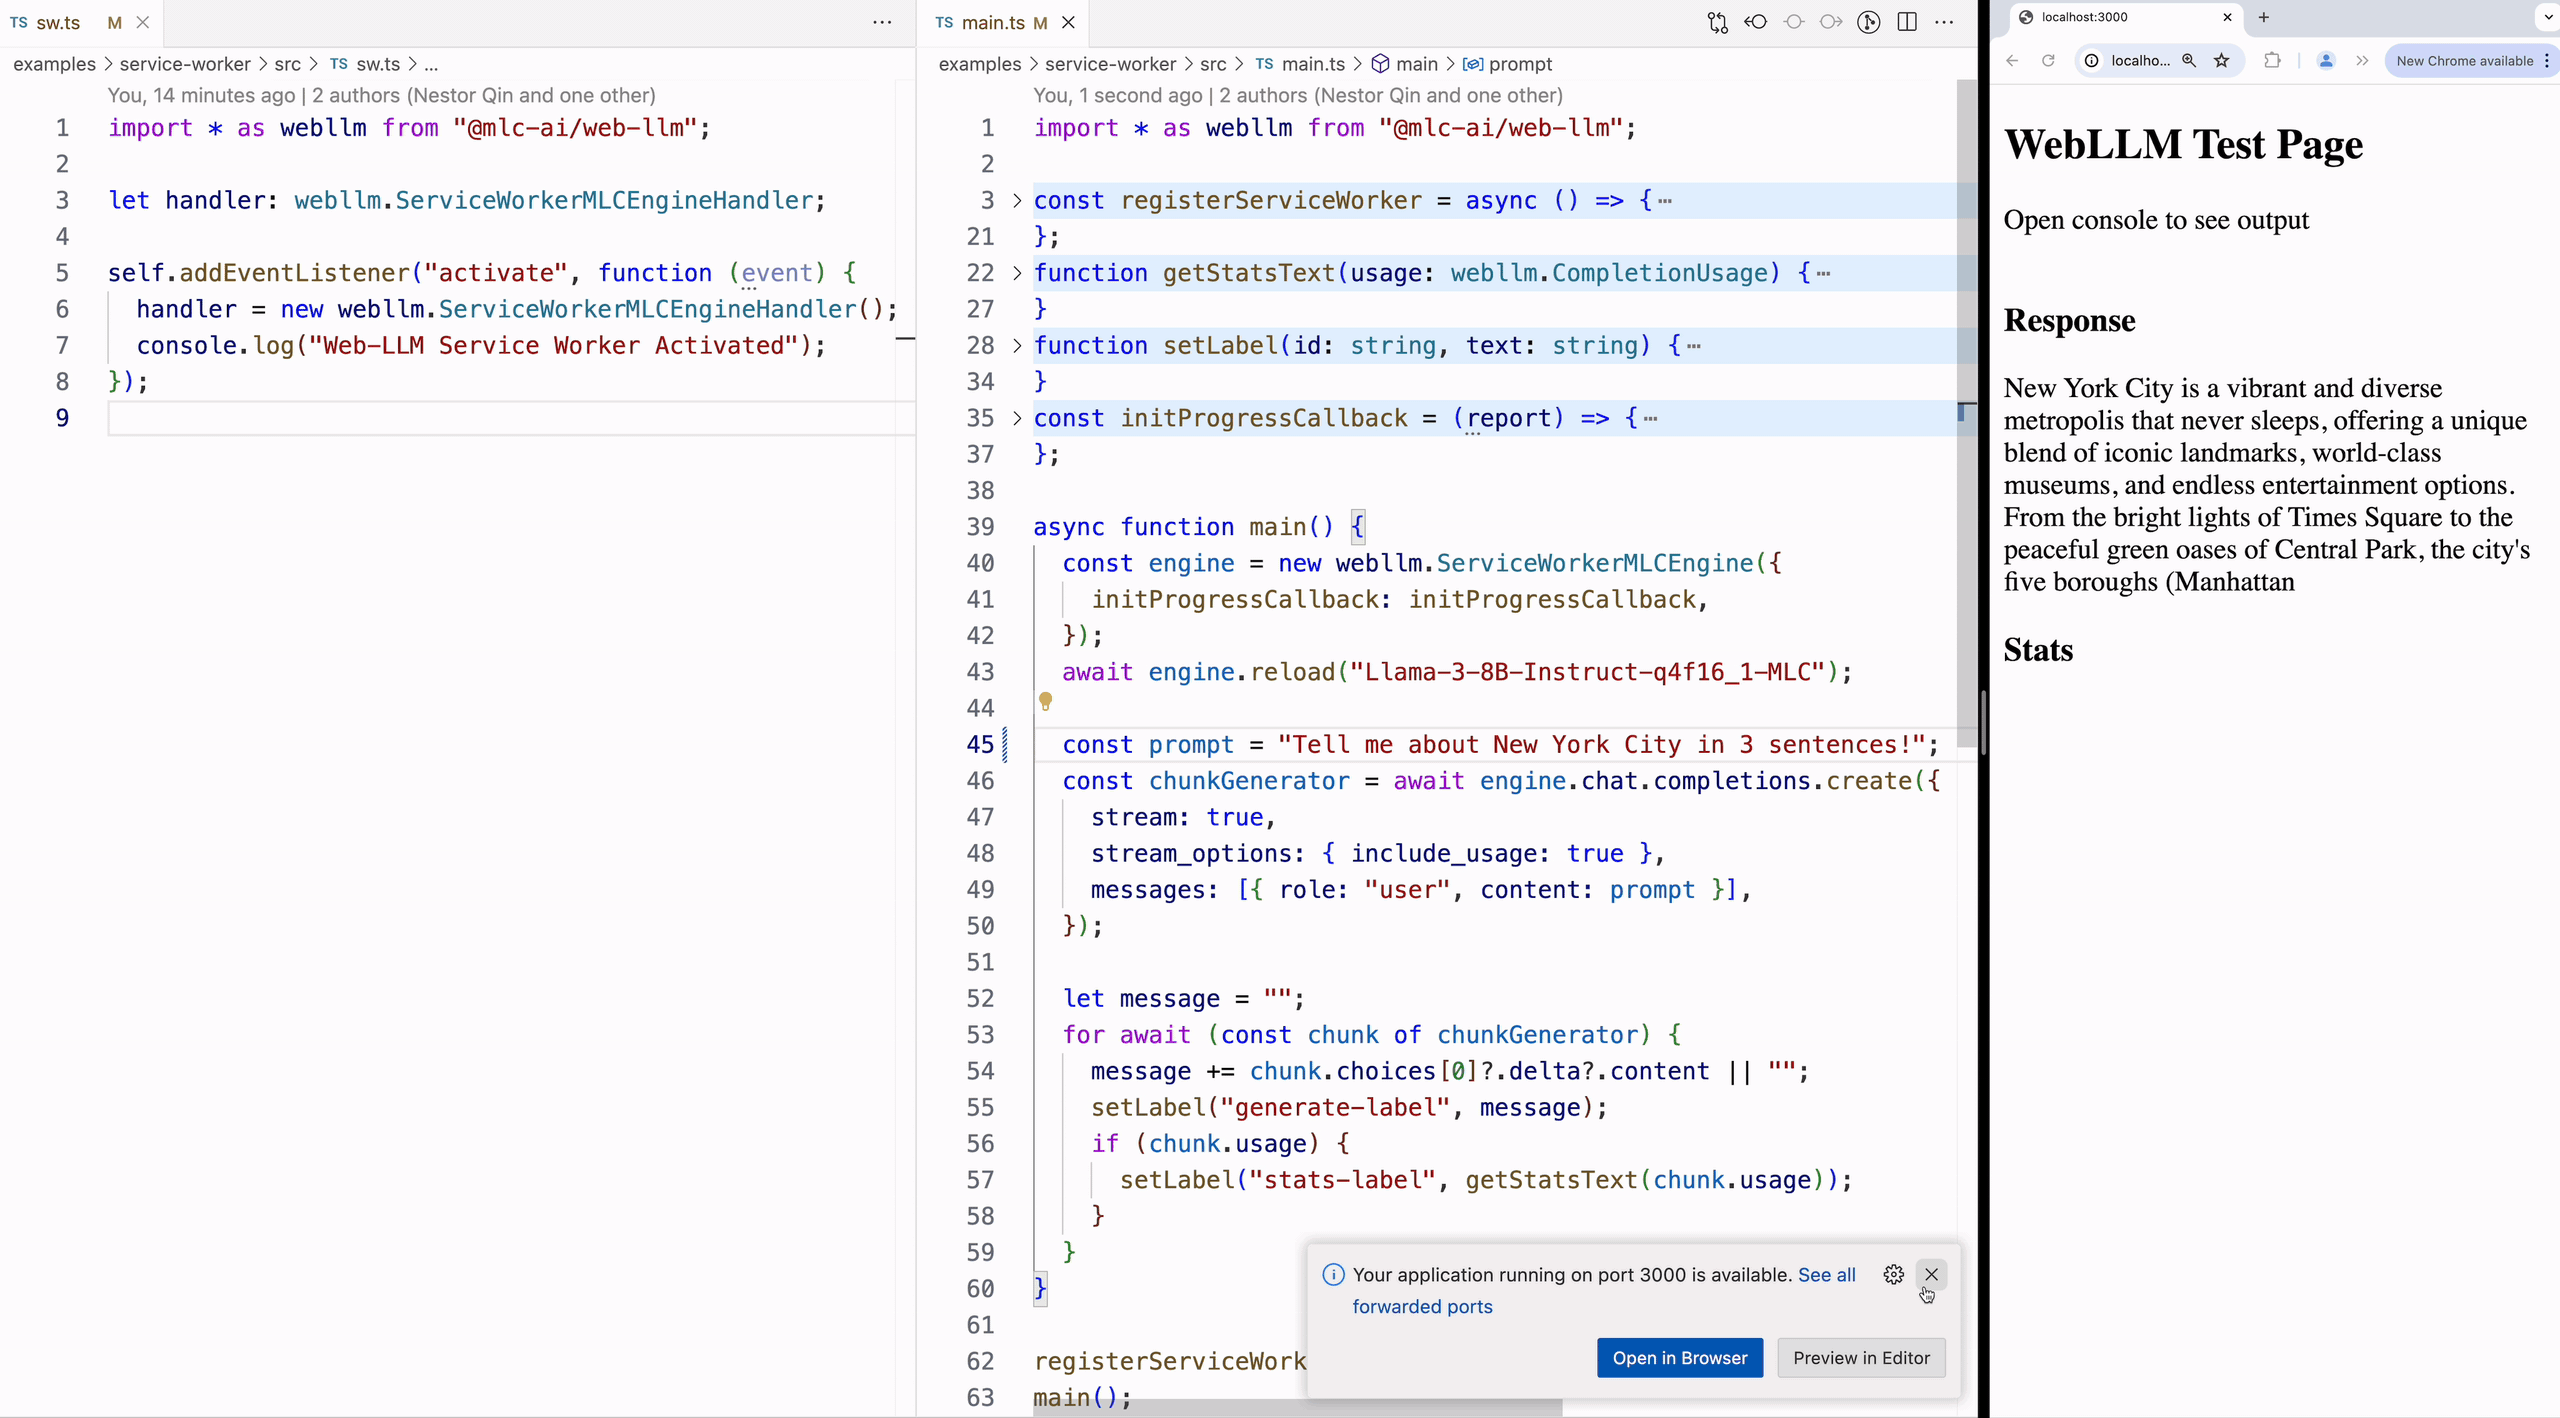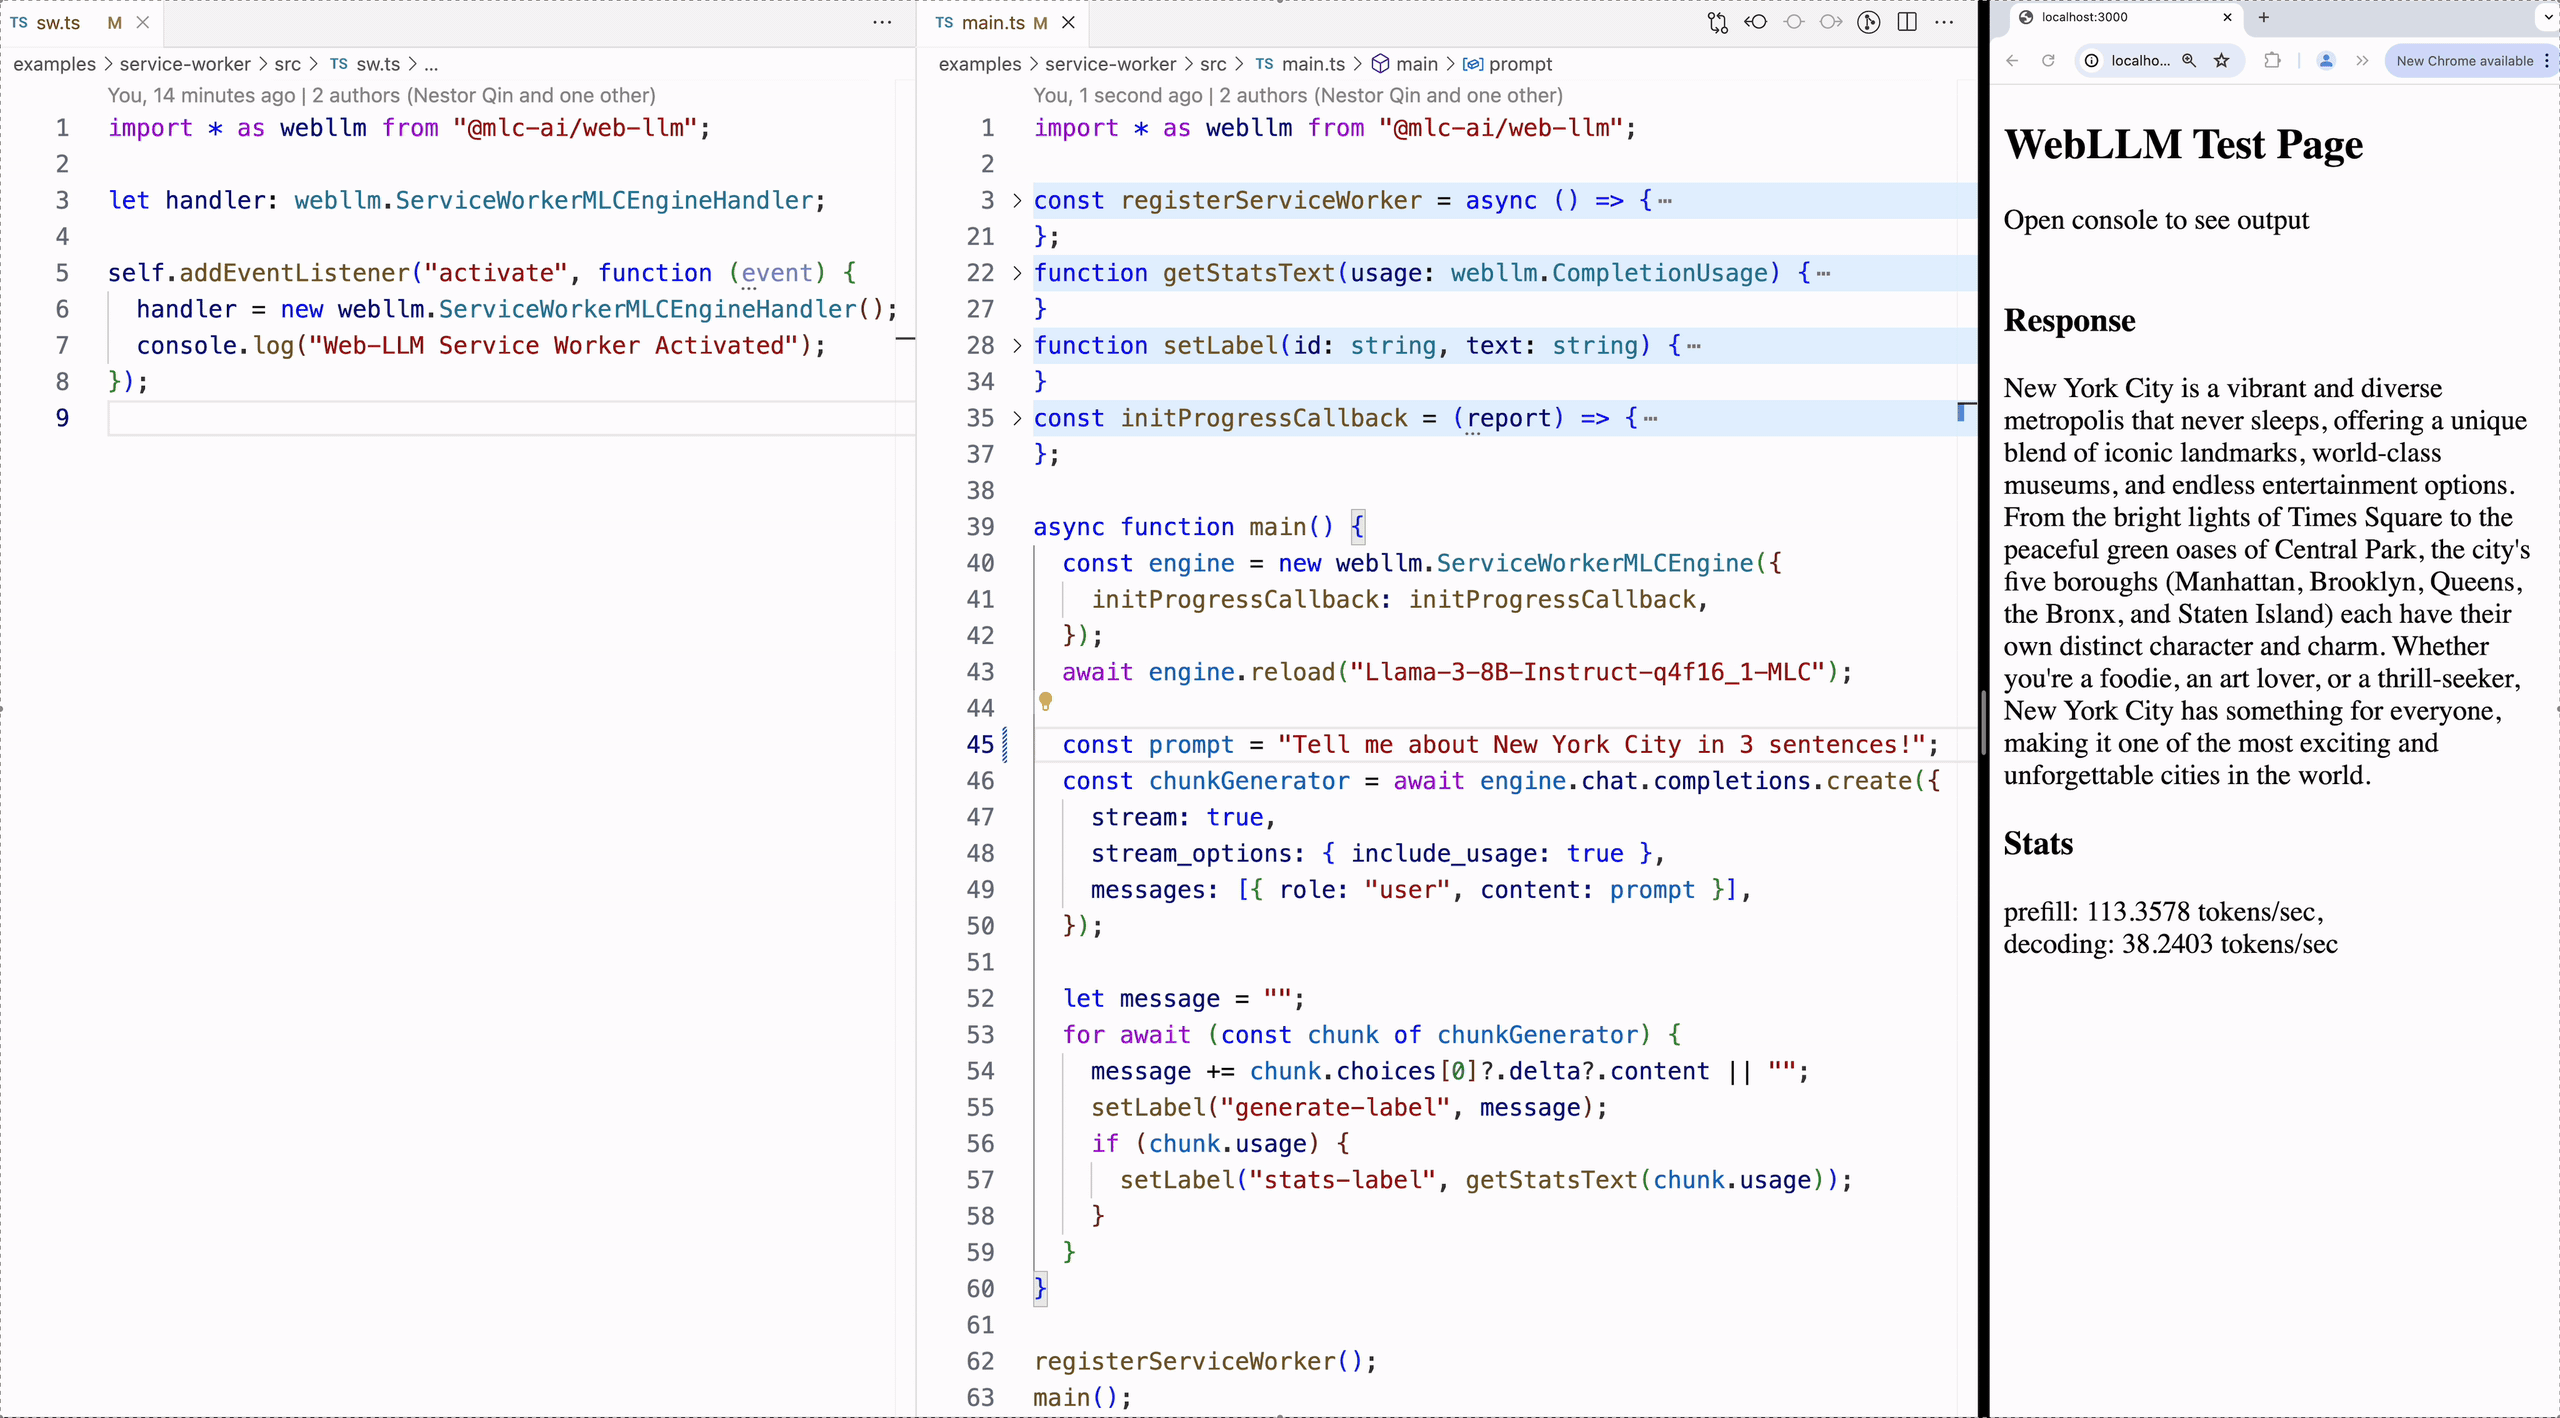
Как показано на рисунке 5, sw.ts слева — это фоновый рабочий поток: в нём находится ServiceWorkerMLCEngineHandler, который хранит внутренний MLCEngine и передаёт сообщения между фронтендом и рабочим потоком. В центре — main.ts, где располагается логика фронтенда веб-приложения: он получает потоковый вывод и наполняет им веб-страницу.
ServiceWorkerMLCEngine спроектирован так, чтобы сохраняться между страницами и перезагрузками, минимизируя накладные расходы на загрузку модели на GPU. Кроме того, мы предоставляем ExtensionServiceWorkerMLCEngine для создания расширений Chrome по аналогичной схеме.
WebLLM Chat — отличный пример интеграции WebLLM в полноценное веб-приложение, что показано на рисунке 6.
Эффективная структурированная генерация JSON
Нам также хотелось выйти за рамки чат-приложений. Структурированная генерация (structured generation) — ключевая функциональность для создания агентов, выходящих за рамки чатбота: она гарантирует, что LLM всегда будет генерировать валидный JSON. Это позволяет использовать LLM в качестве стандартизированных инструментов, интегрированных в другие приложения в продуктивной среде.
WebLLM поддерживает современный режим структурированной генерации JSON (JSON mode), реализованный в WebAssembly-части библиотеки модели для максимальной производительности. WebLLM предлагает два уровня JSON mode: общий режим JSON и настраиваемый режим JSON через схему (schema).
Чтобы использовать общий режим JSON, достаточно указать response_format: { type: "json_object"} в запросе на завершение чата:
Кроме того, WebLLM позволяет задавать формат вывода через JSON-схему, которой результат будет строго соответствовать. Просто укажите response_format: { type: "json_object", schema: mySchema} в запросе:
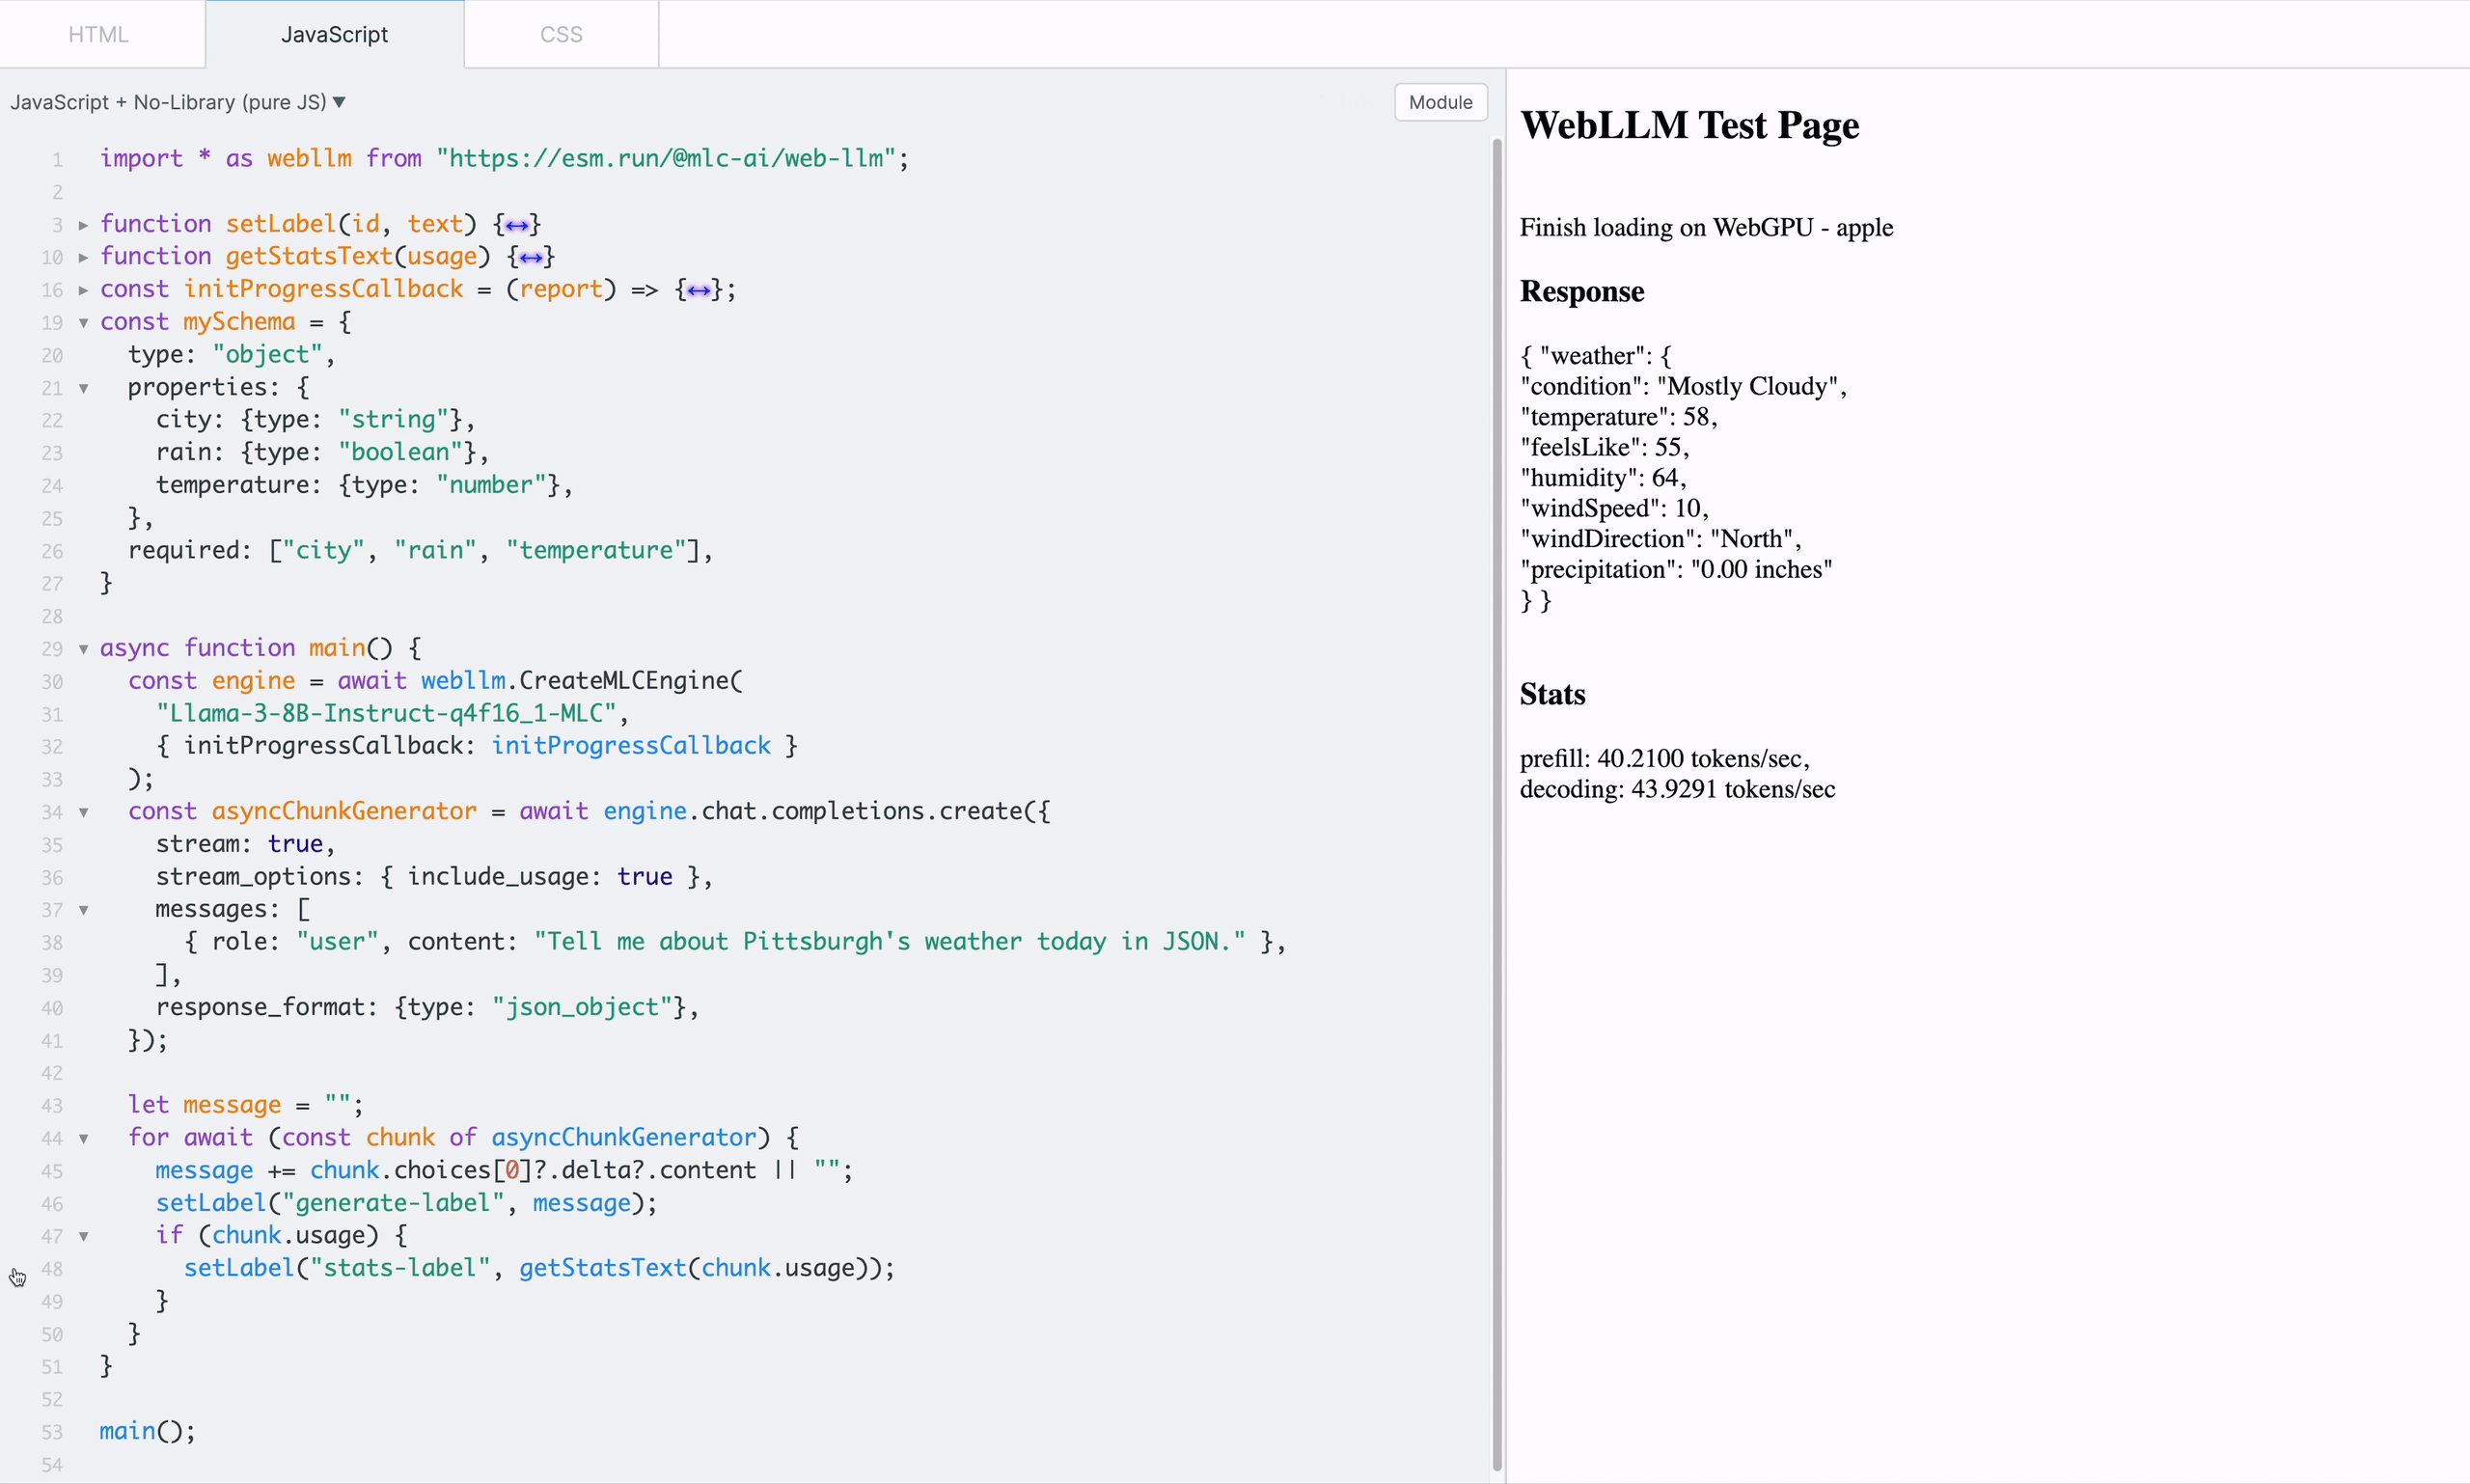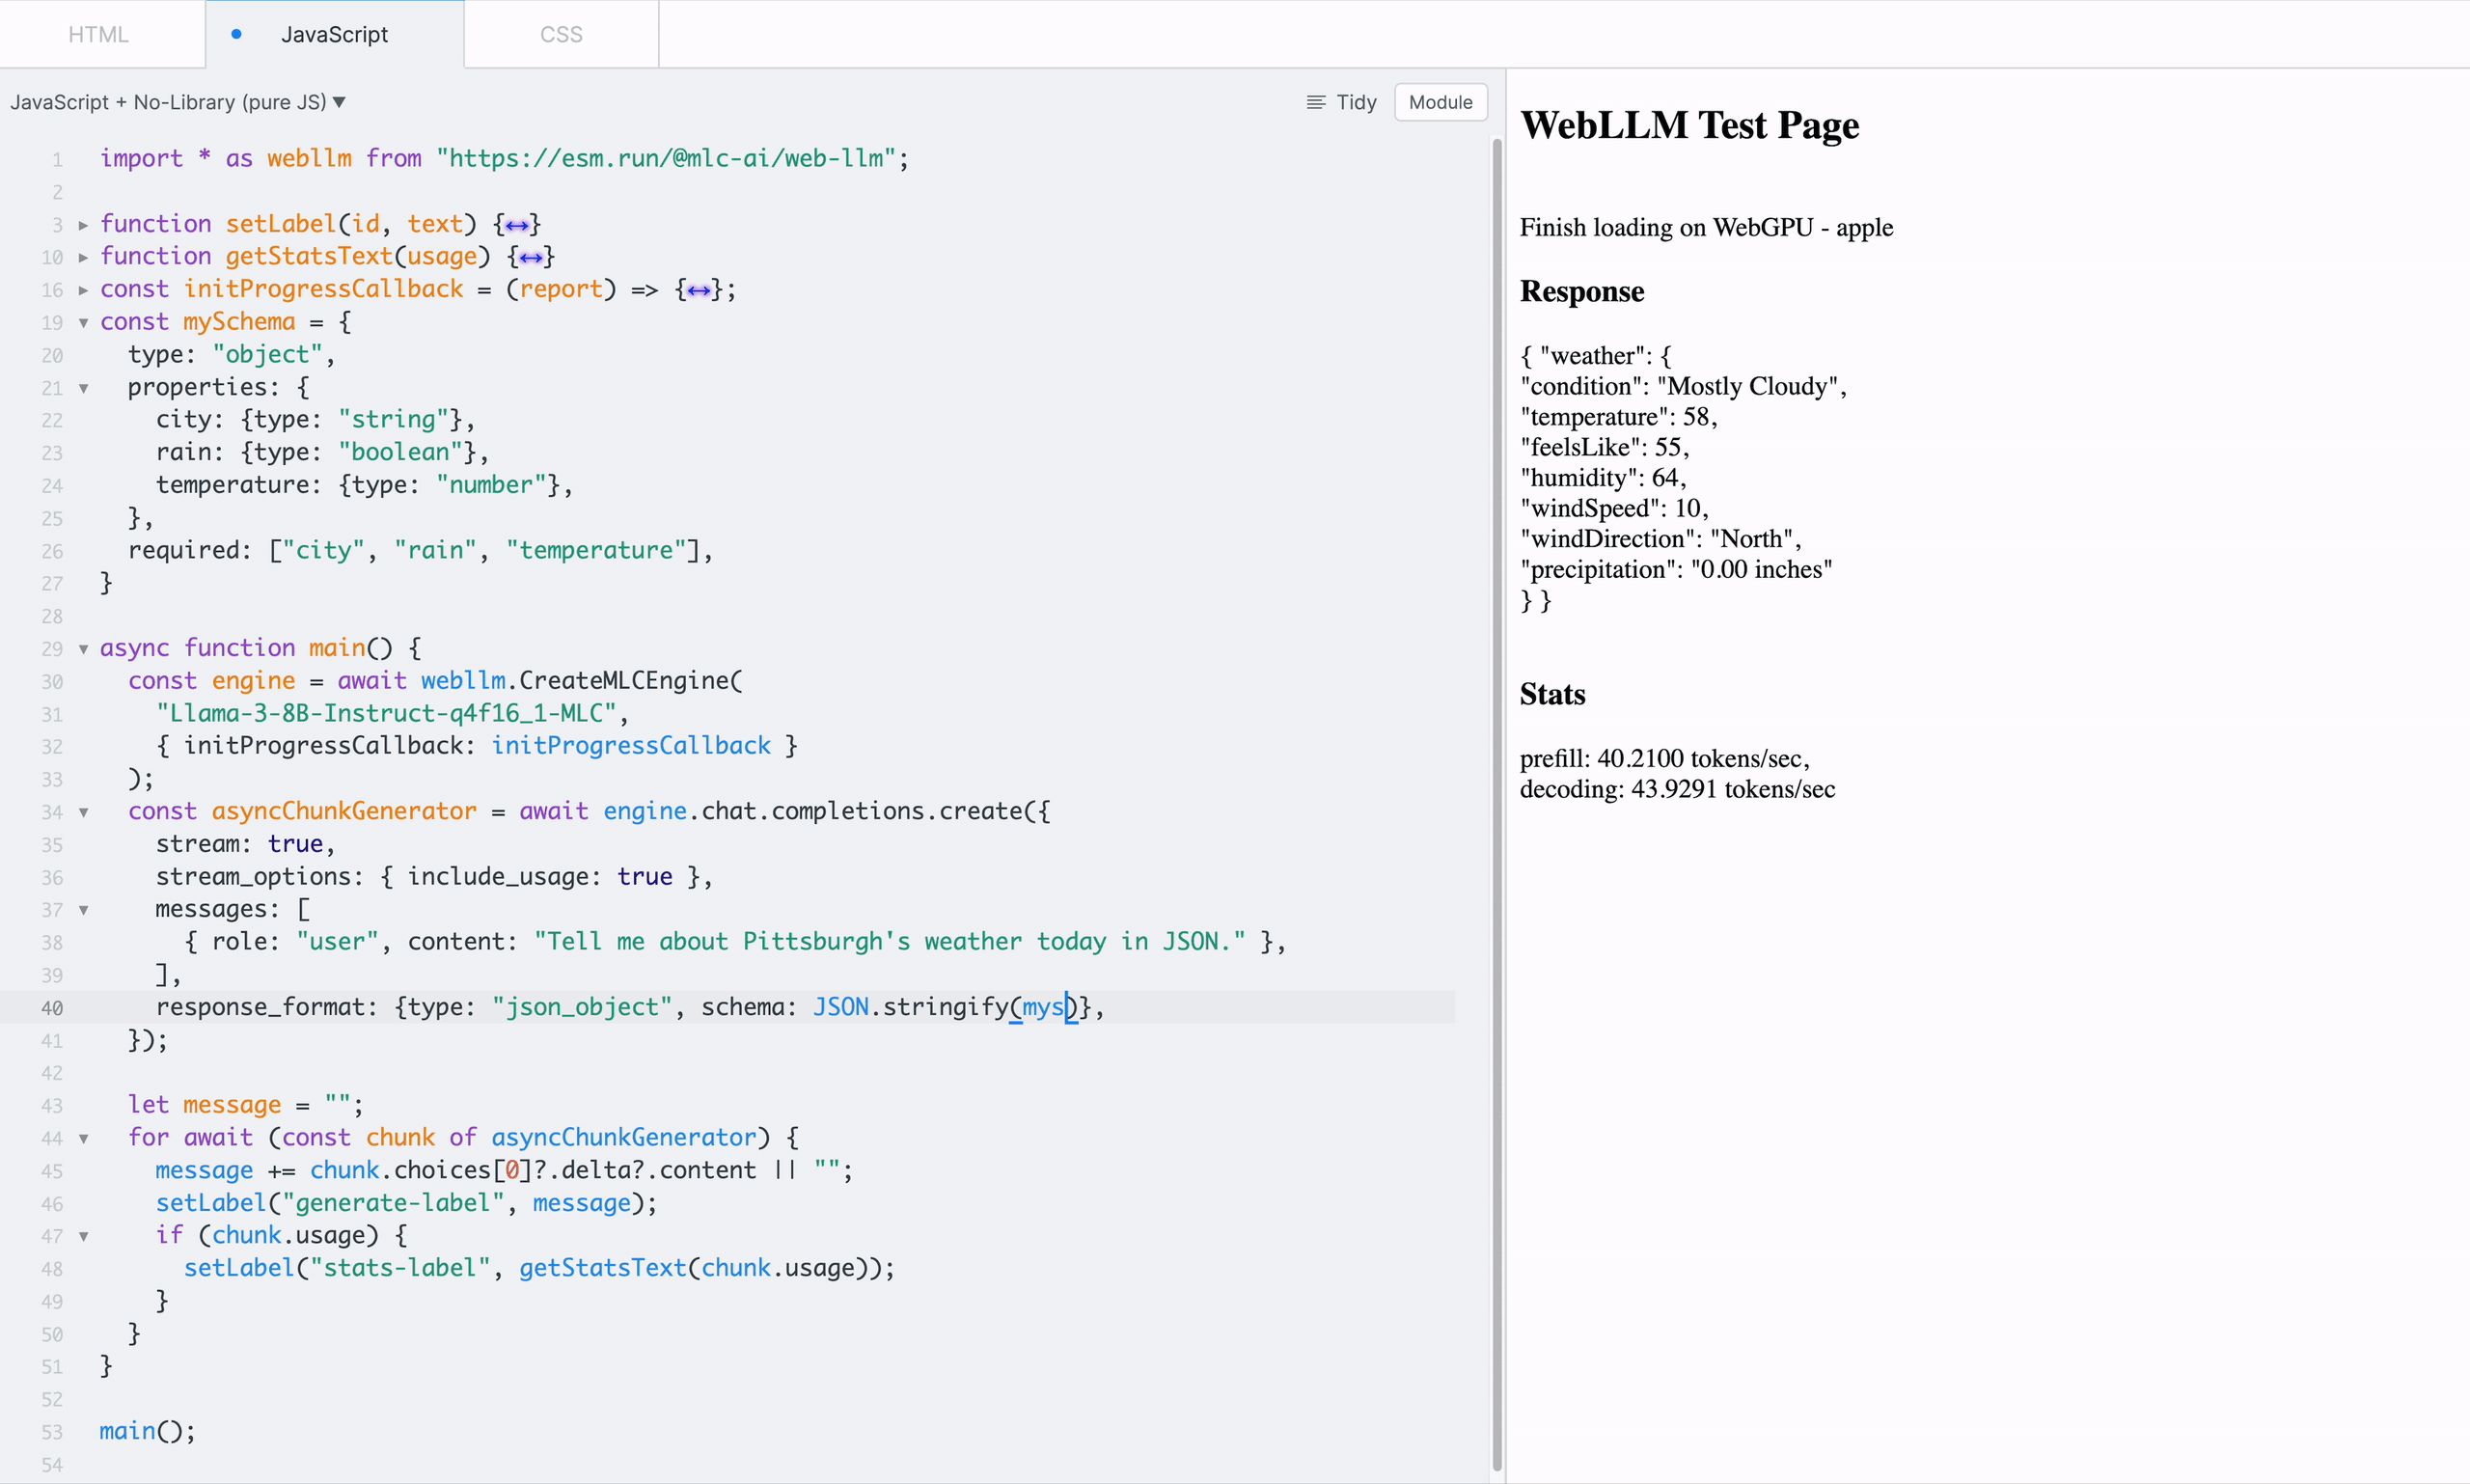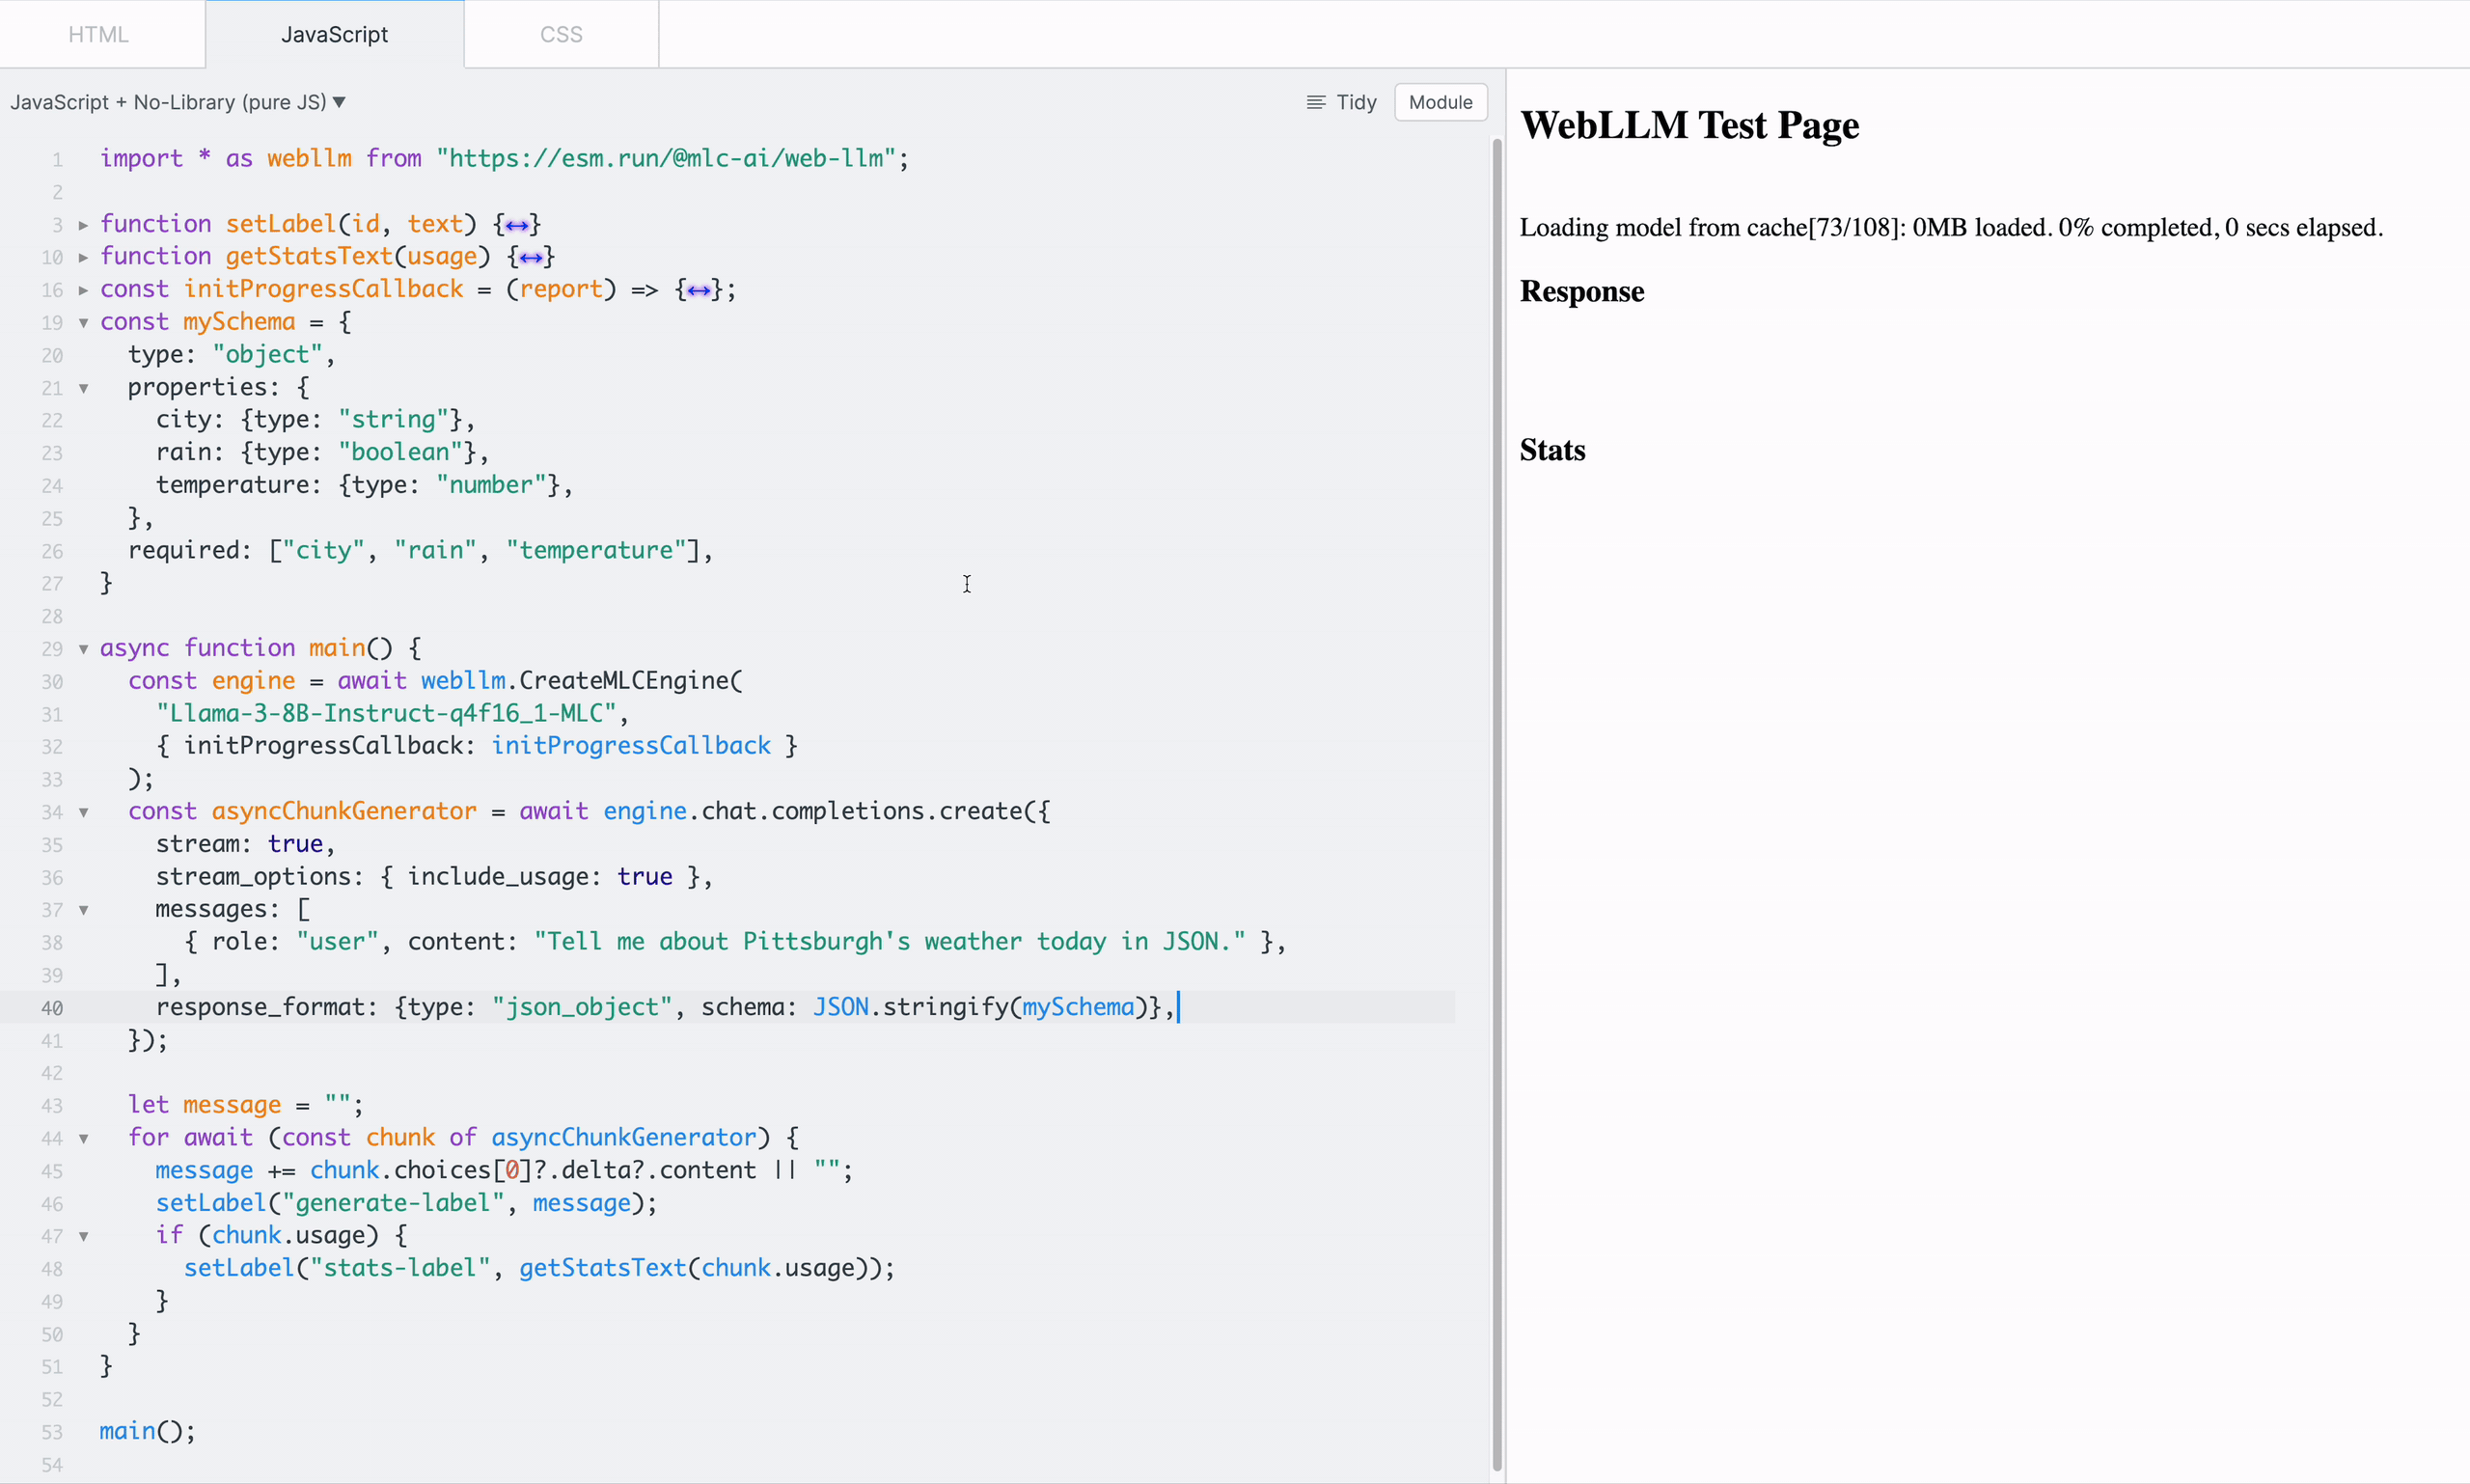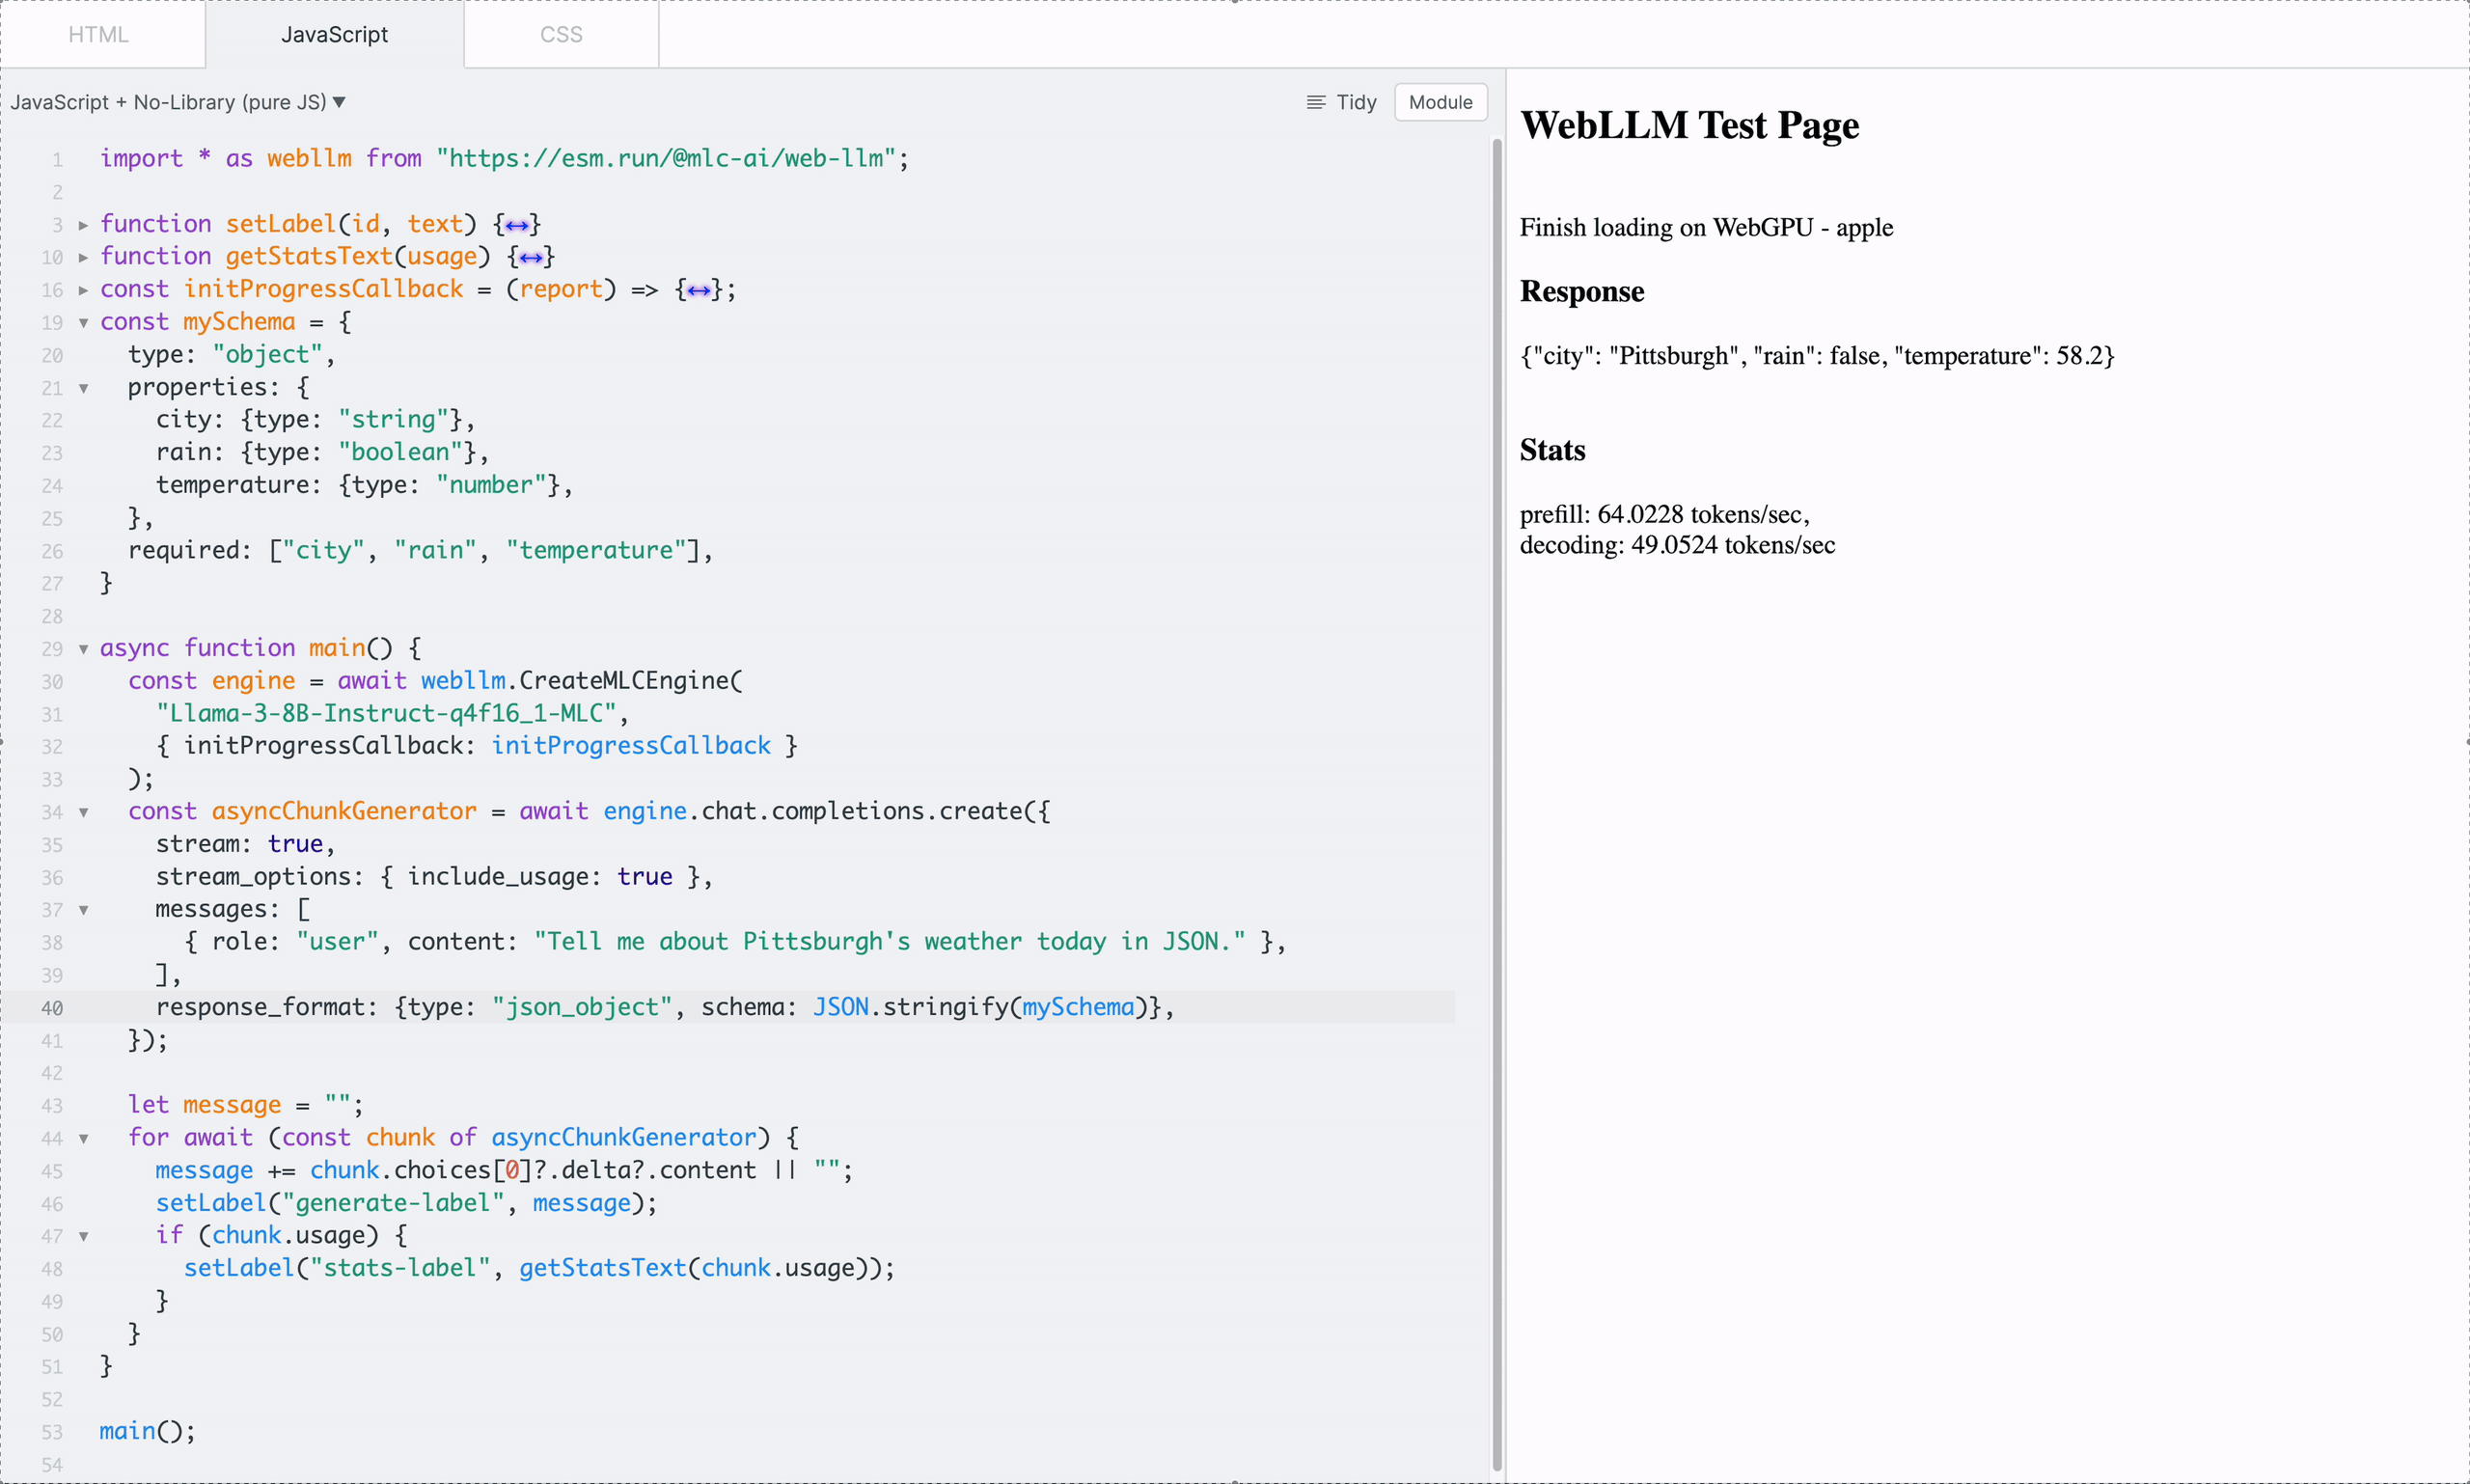
JSON-схема также обеспечивает надёжный вызов функций (function calling), что принципиально важно для создания агентов в браузере. WebLLM уже имеет предварительную поддержку вызова функций, а полная поддержка появится в ближайших обновлениях.
Широкая поддержка моделей
WebLLM предлагает обширный список предсобранных моделей, включая Llama3, Phi3, Gemma, Mistral и другие. Кроме того, интегрировать собственную дообученную модель не составляет труда.
Как показано на рисунке 2, для запуска модели в WebLLM необходимы два компонента: веса модели (конвертированные в формат MLC) и WASM (библиотека модели). Допустим, вы дообучили модель Llama3 для решения узкоспециализированных задач — вы просто конвертируете свои веса через MLC-LLM и повторно используете предоставляемый нами WASM для Llama3. Если же нужная семейство моделей пока не поддерживается WebLLM, вы можете скомпилировать её самостоятельно.
Производительность
Как упоминалось во введении, WebGPU можно рассматривать как абстракцию над различными бэкендами (CUDA, Metal и т.д.), позволяющую выполнять одинаковые ядра на разном железе и тем самым охватить широкую аудиторию пользователей. Однако удобство такой абстракции имеет свою цену: вместо прямого использования нативных ядер GPU должен придерживаться того, что поддерживает WGSL.
Тем не менее мы демонстрируем, что производительность WebLLM близка к нативной — благодаря оптимизациям, выполненным с помощью техник компиляции машинного обучения в MLC-LLM и TVM. Ниже мы сравниваем инференс через WebGPU с нативным инференсом через Metal: оба варианта скомпилированы MLC-LLM и запущены на MacBook Pro с чипом M3 Max.
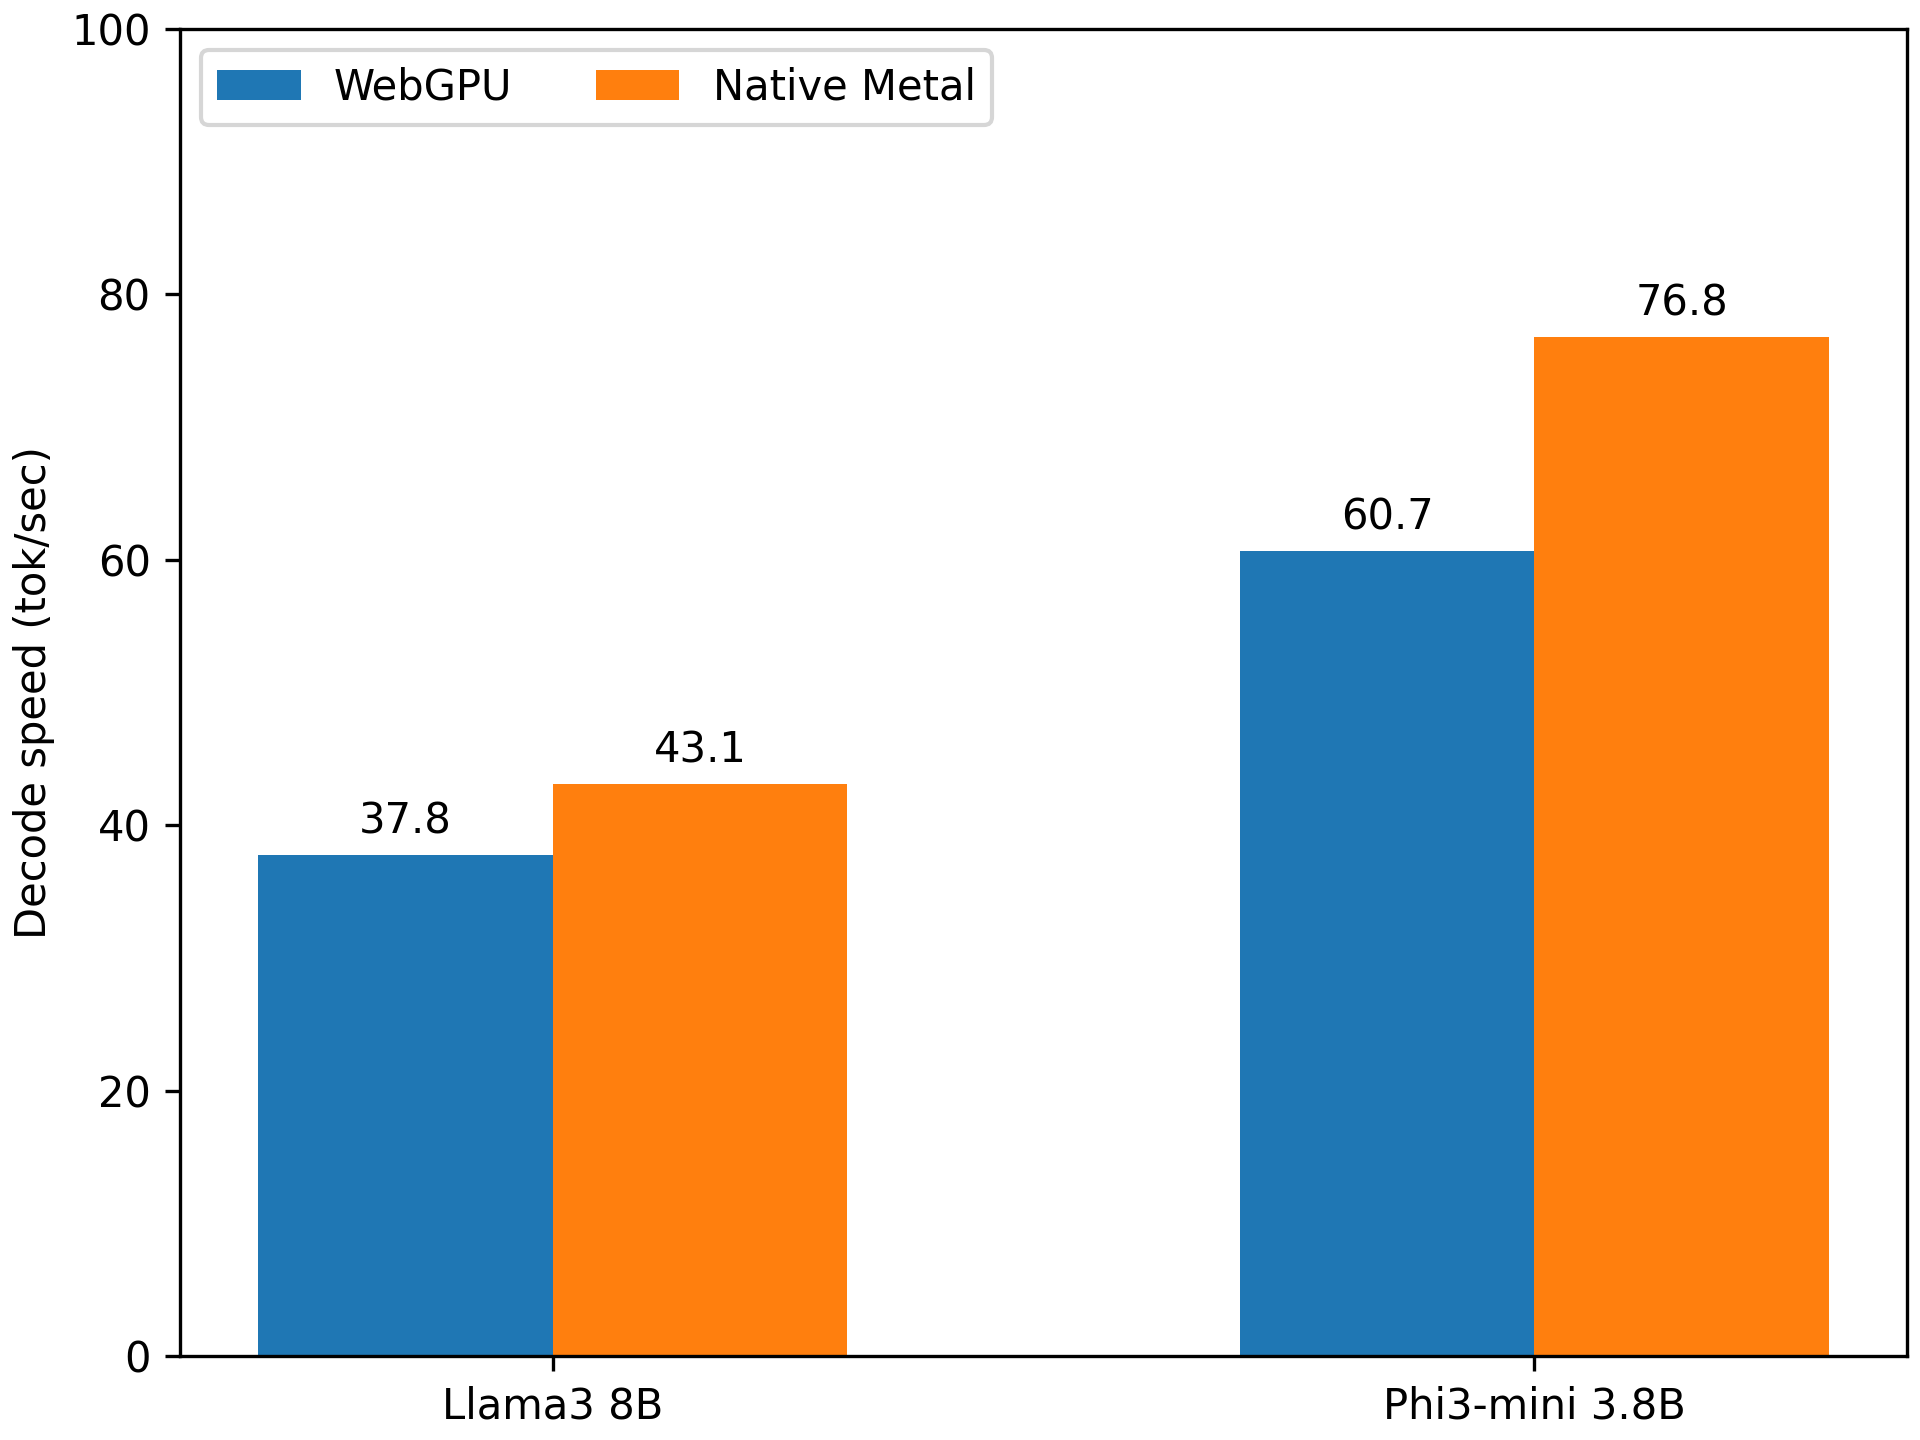
Результаты показывают, что WebGPU сохраняет до 85% нативной производительности. Поддержка WebGPU ещё находится на раннем этапе — большинство браузеров получили её лишь в этом году. Мы ожидаем, что разрыв будет постепенно сокращаться по мере улучшения трансляции WebGPU-кода в нативные шейдеры.
Перспективы развития
Миссия WebLLM — стать бэкендом для ИИ-агентов в браузере. Мы верим в будущее, где агенты прямо в браузере смогут помогать вам бронировать встречи в календаре, составлять письма, покупать билеты и многое другое — и все эти задачи можно воспринимать как запросы к движку WebLLM.
В ближайшее время WebLLM интегрирует полноценный API вызова функций (предварительная поддержка уже есть), модели эмбеддингов, а также мультимодальные модели, такие как Phi-3 Vision и LLaVA, что позволит движку справляться с ещё более широким спектром задач.
Приглашаем сообщество к участию
Мы приглашаем всех попробовать WebLLM Chat — оцените удобство и производительность, которые обеспечивает WebGPU. Поэкспериментируйте с npm-пакетом WebLLM с помощью быстрого примера без какой-либо настройки, создавайте веб-приложения на основе WebLLM, опираясь на готовые примеры, и оставляйте обратную связь в нашем репозитории на GitHub!
Этот проект стал возможным благодаря многочисленным участникам сообщества открытого исходного кода, включая вклад от CMU Catalyst, OctoAI, UW SAMPL, SJTU и более широкого сообщества MLC. Мы также хотим поблагодарить команду Google Chrome и сообщество WebAI за плодотворное сотрудничество и дискуссии. Мы планируем продолжать работу с сообществом открытого кода, чтобы сделать открытые фундаментальные модели доступными для всех!