В Kubernetes 1.36 мы дали планировщику групповой примитив. Workload стал статическим шаблоном политики, PodGroup — отдельным объектом времени выполнения, а плагин gang научился удерживать поды на этапах PreEnqueue и Permit до тех пор, пока не будет набран кворум. Контроллер Job мог создавать эти объекты автоматически через флаг WorkloadWithJob.
Это отвечало на вопрос «что из себя представляет API». Оставался второй вопрос: «как каждый контроллер примет это решение, не изобретая одну и ту же обвязку заново?».
Если ответ — «читайте KEP-ы и вручную собирайте объекты Workload и PodGroup», мы воссоздадим ровно ту фрагментацию, которую Workload-Aware Scheduling (WAS) и призвано было устранить, только на уровень выше. Контроллер Job будет использовать один диалект, JobSet — другой, LeaderWorkerSet — третий, а каждый внешний контроллер — свой.
Kubernetes 1.37 закрывает этот пробел тремя вещами: набором повторно используемых блочных API (building block APIs), общей Go-библиотекой workloadbuilder и обновлённой, явной интеграцией Job, построенной на их основе. В этой статье разобраны все три составляющие, а также путь, который проходит внешний контроллер при подключении к WAS с их помощью.
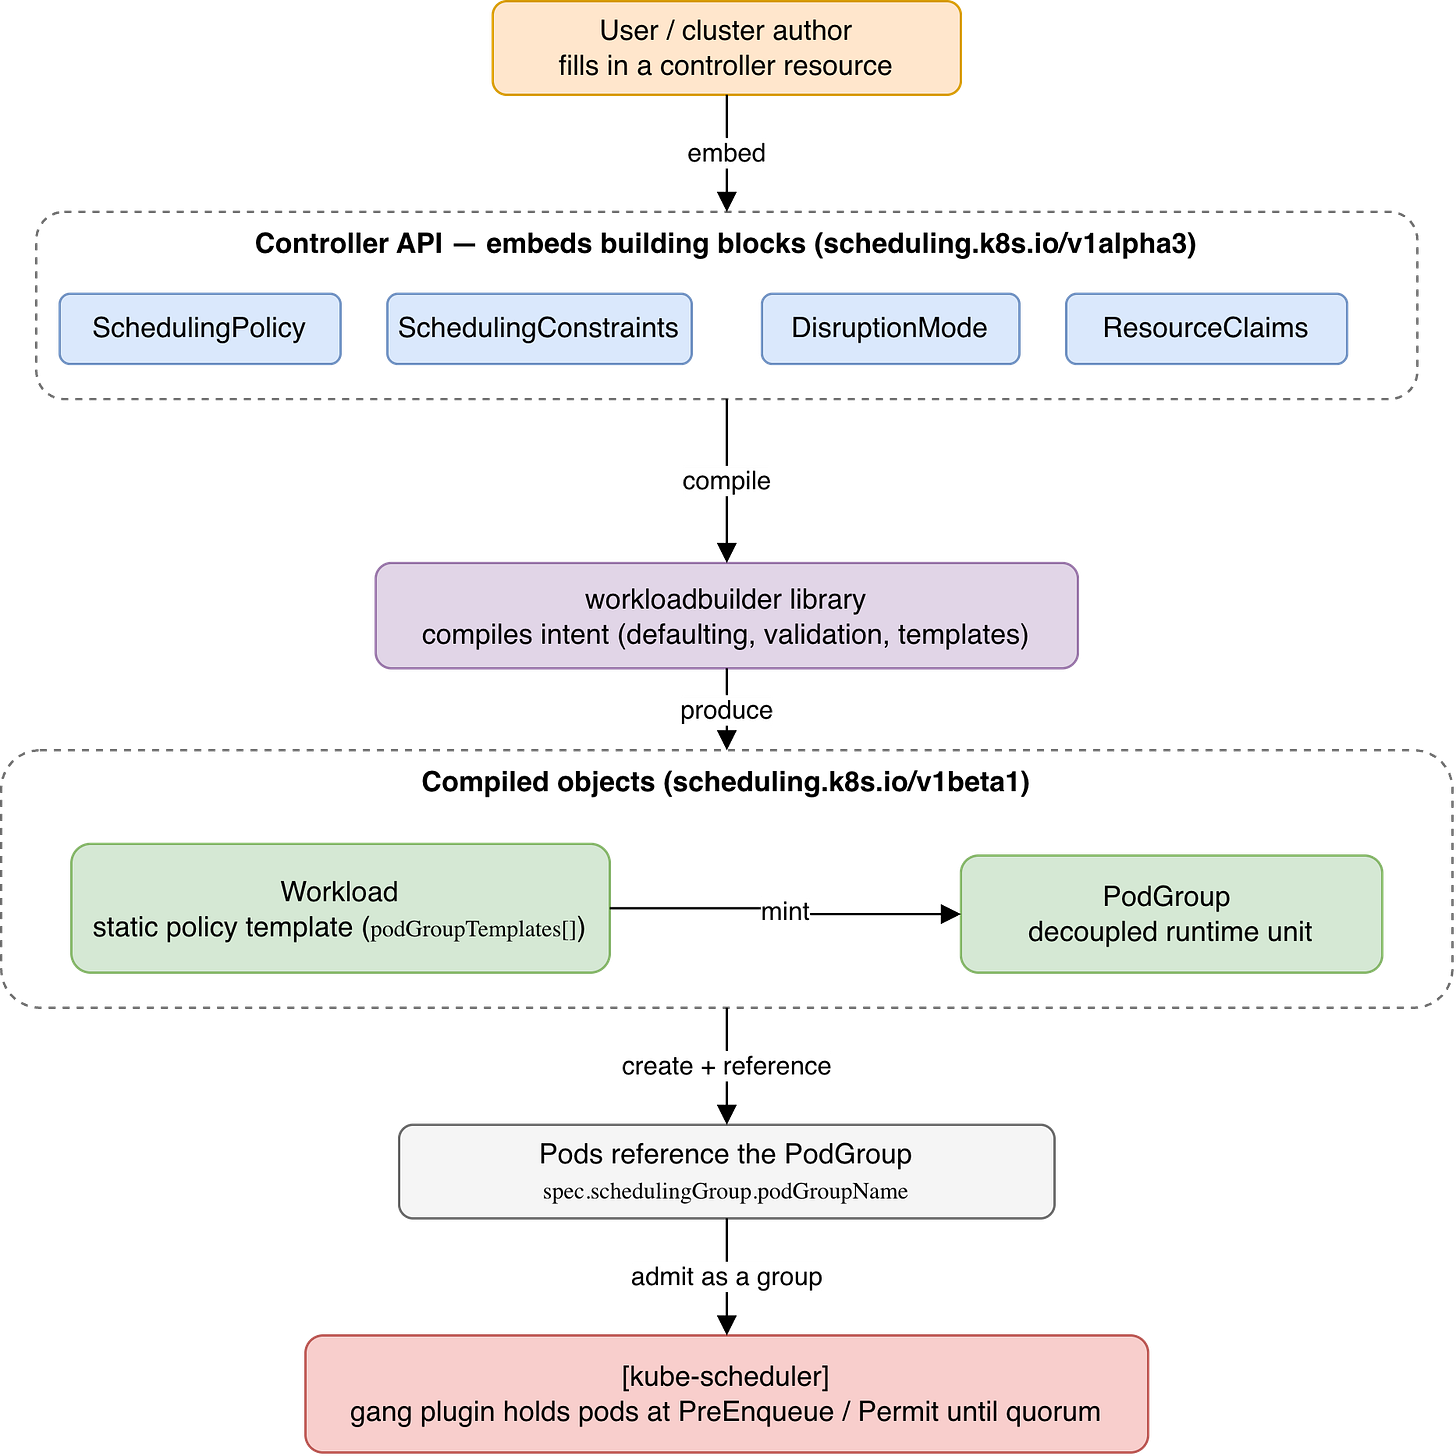
Блочные API (Building Blocks APIs)
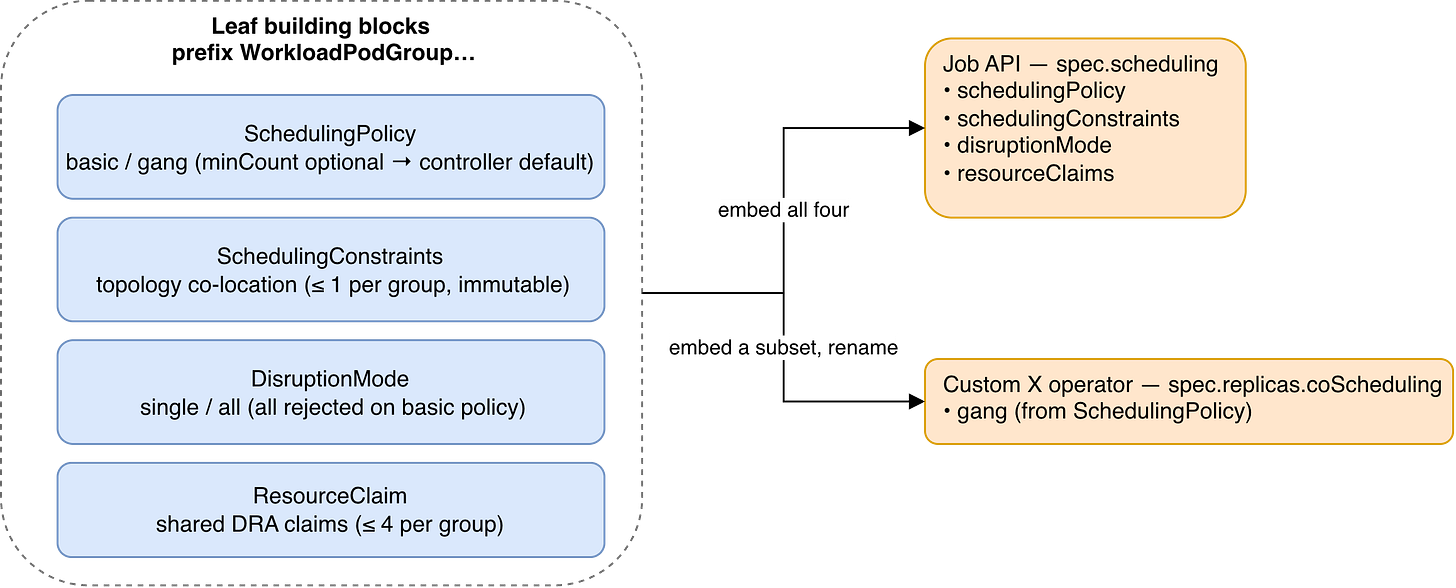
Блочные API — это строго типизированные Go-структуры в scheduling.k8s.io/v1alpha3, каждая из которых выражает одну концепцию планирования. Авторы контроллеров встраивают эти структуры как поля в собственные типы API; библиотека workloadbuilder их компилирует. Пользователи никогда не создают объекты Workload напрямую — они заполняют поля знакомого им ресурса.
Имена типов следуют двум соглашениям. Блоки листового уровня получают префикс WorkloadPodGroup… (например, WorkloadPodGroupSchedulingPolicy), а многоуровневые варианты — префикс WorkloadCompositePodGroup….
Ключевое проектное решение: «блок не навязывает фиксированную форму верхнего уровня». Каждый контроллер выбирает имена полей и структуру, характерные для его собственного API. Рекомендуется использовать стандартные имена — чтобы пользователь, настраивавший gang-планирование на одном контроллере, узнал его на другом, — однако это соглашение, а не жёстко заданная схема. API Job, например, группирует все четыре блока под spec.scheduling через один тип:
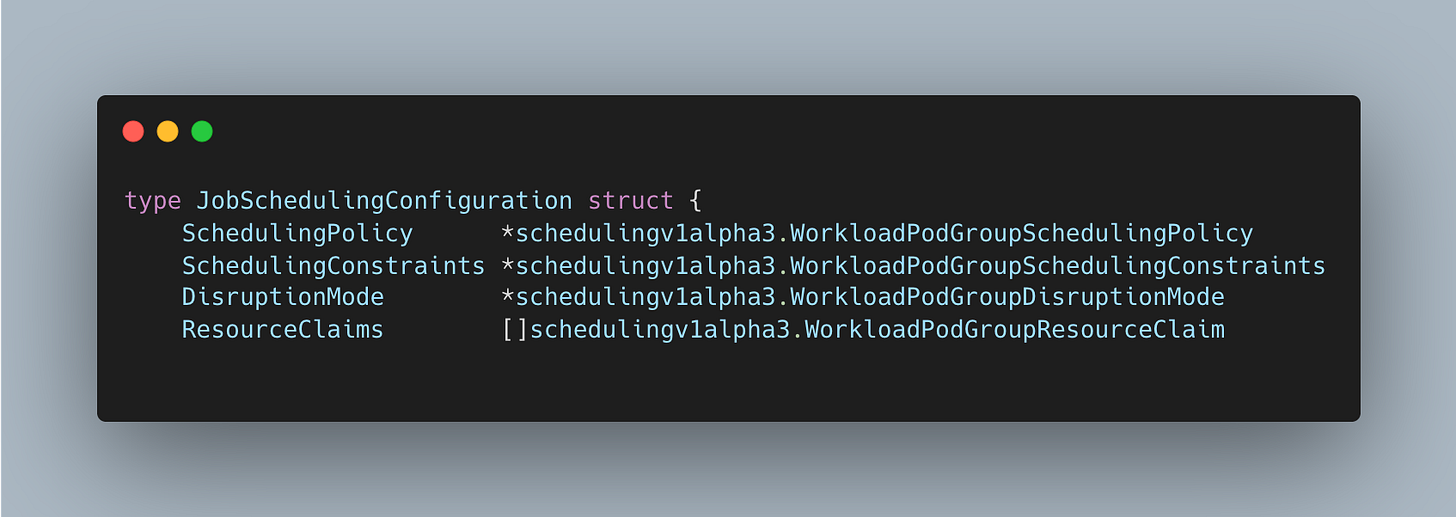
Другой контроллер может вкладывать те же блоки по одному на каждый компонент многочастной рабочей нагрузки или поддерживать только их подмножество. Листовых блоков четыре.
Политика планирования (Scheduling policy)
Те же политики basic и gang, что и у spec.schedulingPolicy объекта PodGroup. Единственное отличие: поле gang.minCount блока необязательно — если оставить его пустым, контроллер подставит разумное значение по умолчанию для своего домена. Контроллер Job по умолчанию берёт значение parallelism задания.
Ограничения планирования (Scheduling constraints)
Топологическое совместное размещение: ключ метки узла, задающий домен (стойку, зону), который должны разделять все поды группы, — не более одного топологического ограничения на группу. Ограничения неизменяемы в скомпилированном Workload, поэтому контроллерам следует фиксировать это поле после создания.
Режим вытеснения (Disruption mode)
Определяет, можно ли вытеснять поды группы по одному (single) или только целиком (all). Библиотека отклоняет лишённые смысла комбинации — в частности, режим all при политике basic, поскольку единица вытеснения не должна быть крупнее единицы планирования. У группы, которая планируется под за подом, нет групповой единицы для вытеснения.
Требования к ресурсам (Resource claims)
DRA-заявки разделяются всеми подами группы, а не выделяются каждому поду отдельно. Каждая запись называет заявку внутри группы и указывает на существующий ResourceClaim или ResourceClaimTemplate. Поды потребляют устройства группы, объявляя совпадающую заявку в собственном spec с тем же именем и ссылкой на тот же объект.
Составные блоки (Composite building blocks)
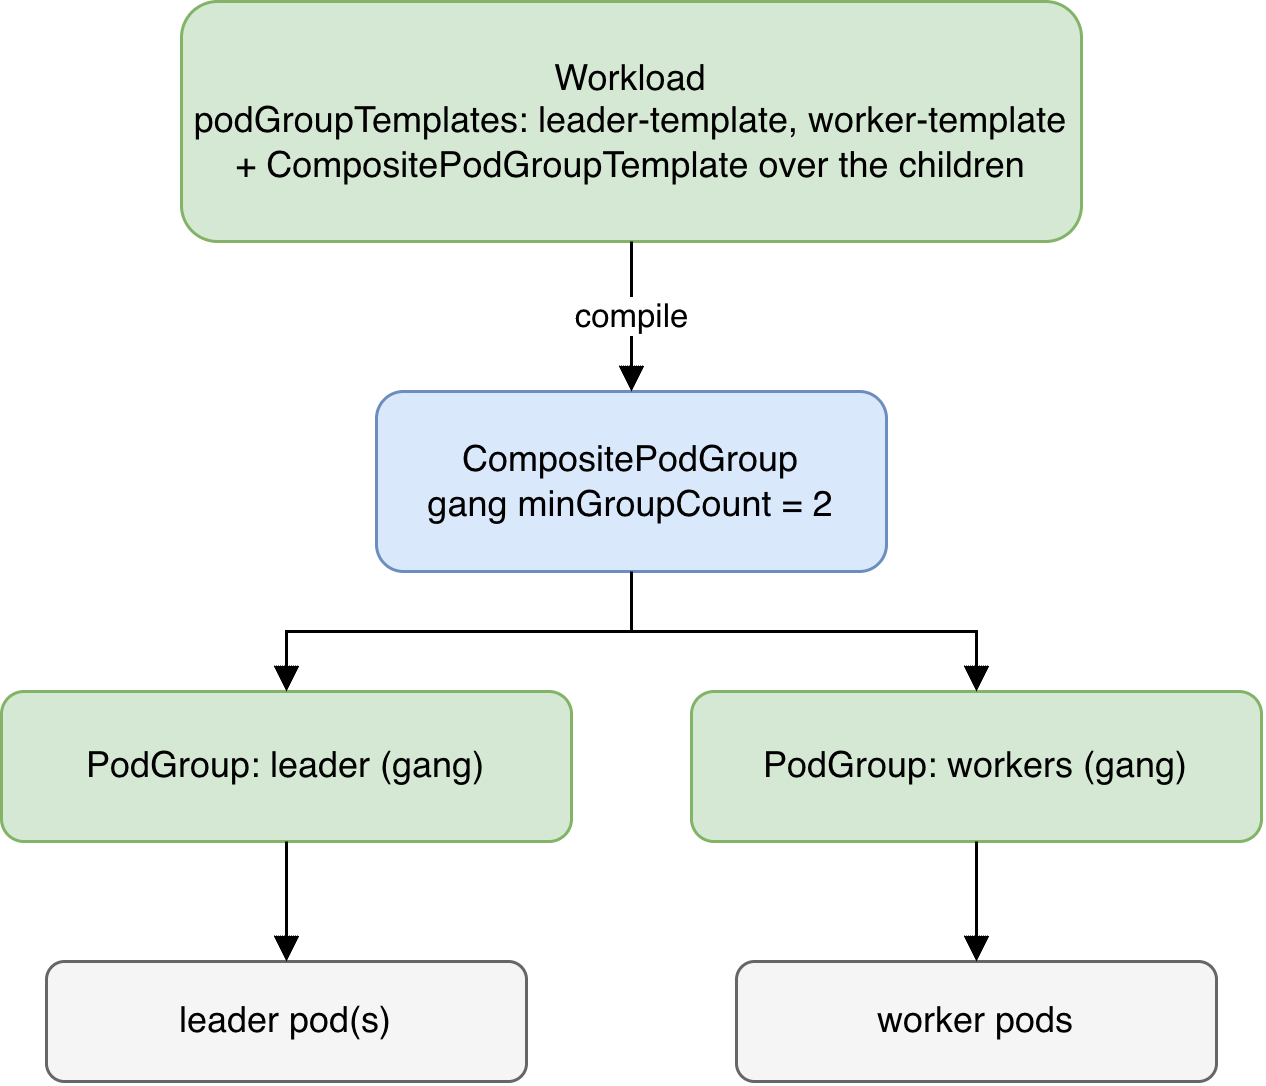
Многоуровневые контроллеры, оркестрирующие другие контроллеры, — JobSet, создающий Jobs, или разгруженный инференс на базе LeaderWorkerSet, координирующего группу групп. Для этого уровня API предоставляет аналогичный набор примитивов с префиксом WorkloadCompositePodGroup…. Они зеркалируют листовые блоки с одним важным отличием: составная gang-политика использует minGroupCount — минимальное количество дочерних групп, которые должны быть запланированы вместе, — вместо minCount листового уровня. Разделение листовых и составных типов позволяет каждому уровню иерархии развиваться независимо.
Библиотека workloadbuilder
Встроенные блоки сообщают планировщику, что вы хотите. workloadbuilder — инструмент, превращающий это намерение в объекты Workload и PodGroup, которые планировщик фактически читает. Ни один контроллер не переизобретает дефолтизацию, валидацию и компиляцию шаблонов.
Библиотека рассчитана как на встроенные, так и на внешние контроллеры. Контроллер Job использует её; внешний контроллер вроде JobSet или Kubeflow TrainJob добавляет её как обычную Go-зависимость. Она поставляется из staging/component-helpers.
В версии 1.37 она принимает блоки v1alpha3 и компилирует их в объекты Workload и PodGroup версии v1beta1; объекты CompositePodGroup остаются v1alpha3.
Дерево WorkloadItem
Контроллер описывает свою рабочую нагрузку в виде дерева узлов WorkloadItem, по одному на каждый логический компонент. Узел без дочерних элементов превращается в один PodGroupTemplate; узел с дочерними — в CompositePodGroupTemplate над ними, что в точности соответствует тому, как многоуровневый контроллер представляет группу групп.
Каждый узел содержит три составляющих:
-
Конфигурация по умолчанию: собственные дефолты контроллера для всего, что пользователь не задал (именно здесь ненастроенный Job остаётся на политике
basic). -
Входные данные: намерение пользователя из API контроллера, записанное вместе с путём поля, в котором оно находится, — чтобы ошибки валидации указывали на конкретное поле, которое задал пользователь.
-
Колбэки (необязательно): корректировки объединённой конфигурации, например заполнение незаданного
gang.minCountиз значения parallelism задания Job.
Деталь с путём поля — это тихая победа: ошибки всплывают применительно к полю CRD самого пользователя, а не к какому-то синтетическому Workload, который он никогда не писал.
Процесс работы с builder
Передайте дерево объекту Builder и последовательно выполните четыре вызова:
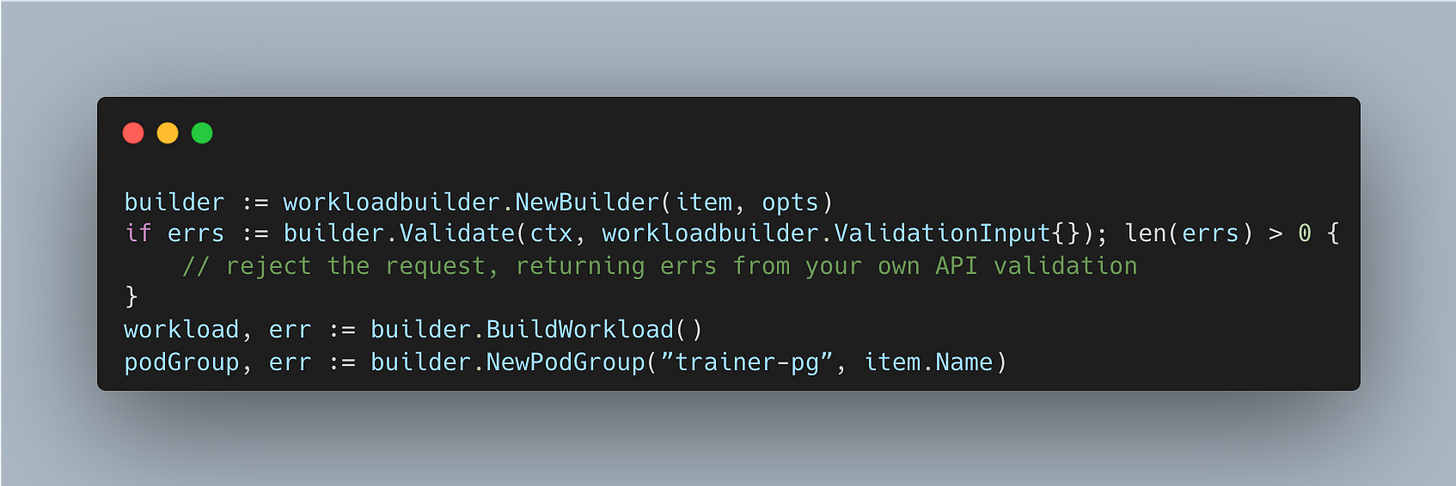
-
NewBuilder создаёт builder из дерева, а также имени, пространства имён и ссылки владельца для создаваемого объекта. Владелец становится ссылкой контроллера
Workload, используемой при поиске и сборке мусора. -
Validate разрешает дерево и сообщает о проблемах в виде списка ошибок полей, которые ваш контроллер возвращает из собственной валидации.
-
BuildWorkload компилирует дерево в
Workload. Результат кэшируется, так что несколько PodGroup можно создать из одного скомпилированного результата. -
NewPodGroup создаёт именованный runtime-объект
PodGroupиз одного из скомпилированных шаблонов.
Валидация
Validate работает в два слоя:
-
Структурная валидация самих блоков — обязательные поля, диапазоны значений, объединения типа «один из», неизменяемость — генерируется из типов API через декларативную валидацию.
-
Проверки политик контроллера, которые декларативная валидация не способна выразить, — списки разрешённых значений (allow-lists) и межполевые правила, например отклонение режима
allв сочетании с политикойbasic.
Валидация также различается для создания и обновления: при обновлении библиотека проверяет поля, замороженные после создания, а значит, нужно передать ранее сохранённую конфигурацию наряду с новой.
Нужен ли вам первый слой, зависит от места запуска:
-
Внешние контроллеры оставляют декларативную валидацию включённой (по умолчанию) — ничто другое не применяет структурные правила к пользовательскому ресурсу, поэтому один вызов
Validateпокрывает оба слоя. -
Встроенные контроллеры устанавливают DisableDeclarativeValidation, поскольку API-сервер уже выполняет декларативную валидацию встроенных блоков при валидации родительского объекта. Отключение первого слоя позволяет не проверять одни и те же поля дважды.
Списки разрешённых значений (Allow-lists)
Поскольку типы блоков используются разными контроллерами, будущие релизы могут добавлять опции, которые не имеют смысла для каждого из них. workloadbuilder применяет модель allow-list: контроллер объявляет поддерживаемые политики и режимы вытеснения, а Validate отклоняет всё, что выходит за их рамки, сообщая об ошибке по пути поля нарушающего блока.
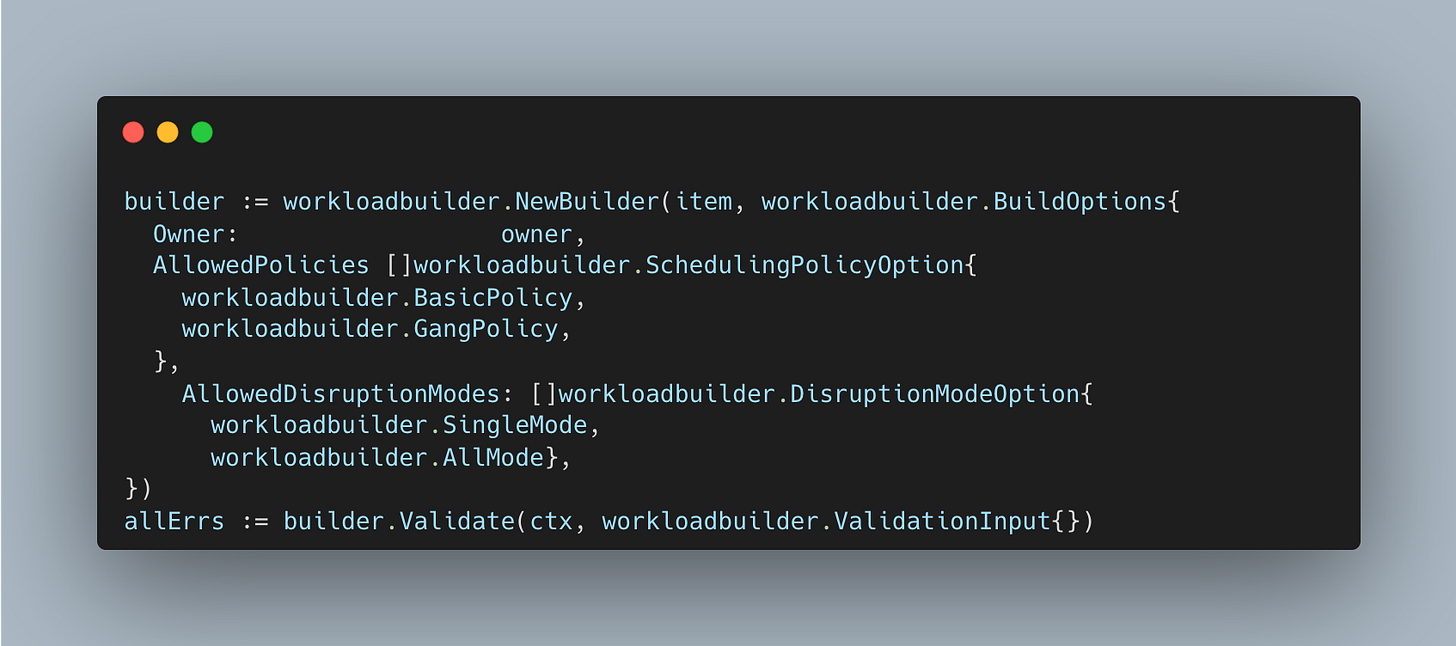
Опции, таким образом, запрещены по умолчанию. Когда апстрим добавляет новую политику, существующий контроллер продолжает её отклонять, пока его мейнтейнеры не расширят allow-list — а для внешнего контроллера это также означает обновление вендорной копии библиотеки. Это гарантирует, что новое поведение планирования никогда не просочится молча в контроллер, который на него не подписался.
Создание PodGroup из существующего Workload
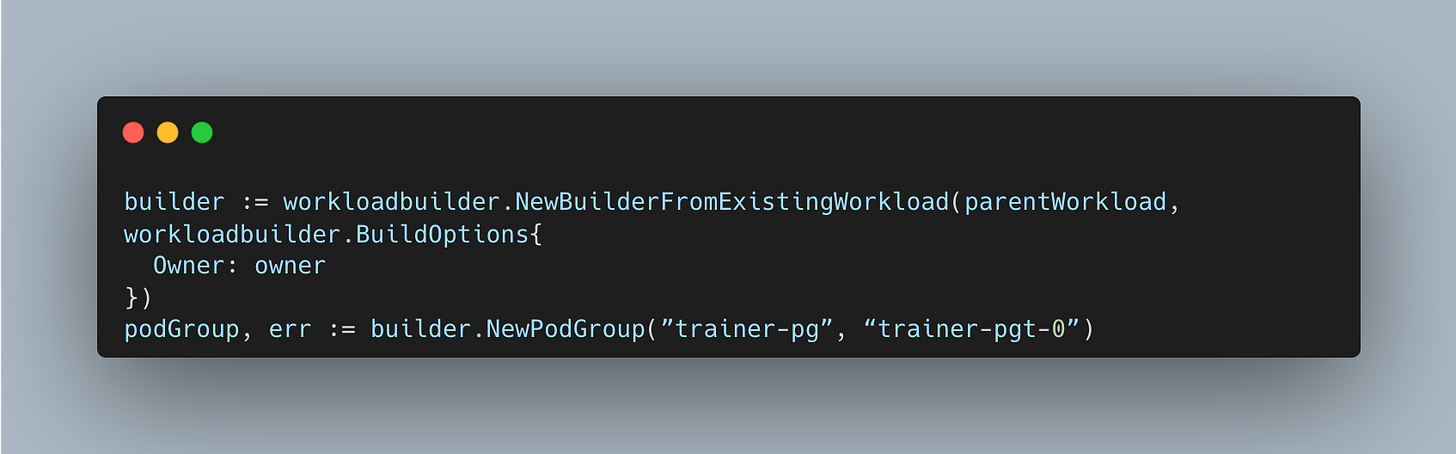
Когда Workload уже существует (скомпилирован родительским контроллером или создан вручную), дочерний контроллер, управляющий только runtime-объектом PodGroup, использует NewBuilderFromExistingWorkload. Он создаёт объекты PodGroup из переданного Workload под собственной ссылкой владельца и не валидирует и не перекомпилирует ничего — существующий Workload не затрагивается.
Именно это стыковочное место делает работоспособным разделение родитель/дочерний контроллер, описанное ниже.
Интеграция контроллера Job — теперь явная
Интеграция в 1.36 была неявной: при включённом WorkloadWithJob подходящий Job молча получал Workload и PodGroup из набора условий. В 1.37 намерение выражается явно, а реализация становится общей — контроллер Job компилирует свои объекты через workloadbuilder точно так же, как это делал бы внешний контроллер.
Явный блок .spec.scheduling
Пользователи задают намерение планирования прямо в Job. Если блок опущен, Job по умолчанию использует политику Basic — обычное поведение с планированием под за подом не изменяется.
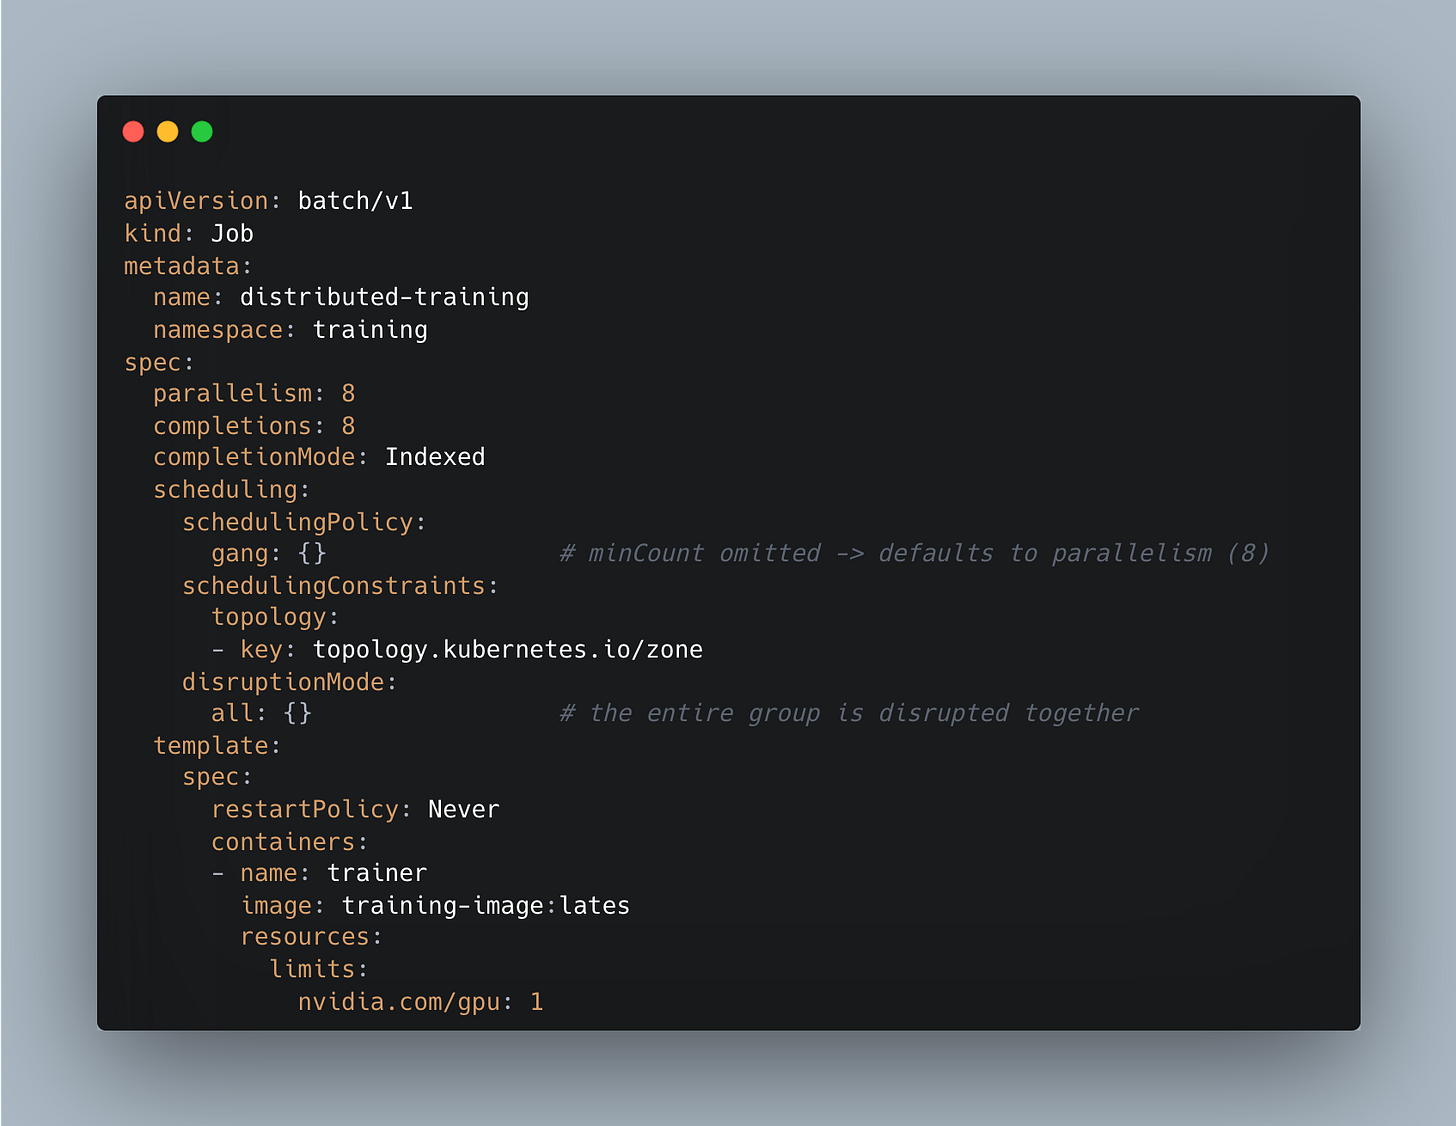
Четыре поля .spec.scheduling отображаются один к одному на листовые строительные блоки. Все они неизменяемы после создания, за исключением schedulingPolicy.gang.minCount, который остаётся изменяемым для эластичного масштабирования gang.
Что с этим делает контроллер
Обрабатывая такой Job, контроллер:
-
Создаёт
Workloadв том же пространстве имён сpodGroupTemplate, скомпилированным из.spec.scheduling(в данном случае — gang-политика сminCount: 8). -
Создаёт
PodGroupиз этого шаблона — runtime-единицу планирования, несущую встроенную копию политики. -
Создаёт поды с установленным
spec.schedulingGroup.podGroupName, связывая каждый под с его группой.
Обнаружение работает через ссылки в spec — Workload.spec.controllerRef и PodGroup.spec.workloadRef — а не по имени. Созданные контроллером объекты содержат запись ownerReferences обратно на Job, поэтому при удалении Job они собираются сборщиком мусора. Job с политикой Basic (без .spec.scheduling) также получает Workload и PodGroup, так что наблюдаемые объекты единообразны вне зависимости от политики.
Эластичные gang-группы
Поскольку gang.minCount изменяем, gang можно масштабировать на месте: задать .spec.scheduling.schedulingPolicy.gang.minCount напрямую или изменить .spec.parallelism, когда minCount не задан. Контроллер перекомпилирует Workload и пересинхронизирует размер PodGroup без пересоздания Job; изменения применяются к подам, оцениваемым в будущих циклах планирования. Значение minCount больше parallelism отклоняется — такой gang никогда не удастся удовлетворить.
Ограничения альфа-версии
-
Каждый Job отображается ровно на одну
PodGroup; все его поды разделяют единую политику планирования. -
Изменяемым является только
schedulingPolicy.gang.minCount; все остальные поля.spec.schedulingзамораживаются после создания. -
Приостановленные Job сохраняют свои
WorkloadиPodGroup— они не удаляются при приостановке и не пересоздаются при возобновлении.
Интеграция внешнего контроллера
Именно ради этого и сделан данный релиз. Ниже описан путь для контроллера, которым вы управляете сами: кастомного трейнера, оператора инференса или существующего проекта вроде JobSet, LeaderWorkerSet или Kueue, перенимающего нативный примитив.
-
Встройте блоки в ваш API: добавьте поддерживаемые блоки
v1alpha3как поля CRD, названные в соответствии с ментальной моделью ваших пользователей — группировкаJobSchedulingConfigurationхорошо подходит в качестве образца. -
Постройте дерево
WorkloadItemв reconciler: один узел для плоской рабочей нагрузки; вложенные узлы — для многоуровневой. Записывайте каждый блок с его путём поля, чтобы ошибки указывали на поле пользователя. -
Задайте позицию по валидации: для внешнего контроллера оставьте декларативную валидацию включённой. Объявите allow-lists (
AllowedPolicies,AllowedDisruptionModes), чтобы неподдерживаемые опции отклонялись сразу. -
Компилируйте и создавайте:
NewBuilder→Validate→BuildWorkload→NewPodGroup. Создайте или обновите объекты, затем проставьте подамspec.schedulingGroup.podGroupName. -
Дайте планировщику сделать остальное: поведение gang, топологии, вытеснения и preemption-а определяется прикреплёнными блоками — вы не реализуете ничего из этого самостоятельно.
Что вы явно не делаете: не пишете gang-контроллер, не изобретаете диалект PodGroup и не привязываете пользователей к конкретному бэкенд-планировщику.
Разделение родитель/дочерний контроллер и как контроллер Job уже это реализует
Наиболее полезный паттерн для многоуровневых контроллеров виден в поведении контроллера Job под управлением родителя вроде JobSet. Когда Job содержит ownerReference на родителя, компилирующего Workload, контроллер Job передаёт владение Workload этому родителю. То, что он делает с runtime-объектом PodGroup, зависит от того, что делегирует родитель:
-
Если родитель проставляет на Job аннотацию
scheduling.k8s.io/group-template-name, контроллер Job создаёт и владеетPodGroup, сопоставленной с именованнымPodGroupTemplateродителя. -
В противном случае оба объекта принадлежат родителю; контроллер Job не создаёт ни один из них и просто обнаруживает и использует существующие при создании подов.
А если шаблон подов Job уже содержит spec.template.spec.schedulingGroup, контроллер Job полностью устраняется — жизненным циклом Workload/PodGroup управляете вы сами.
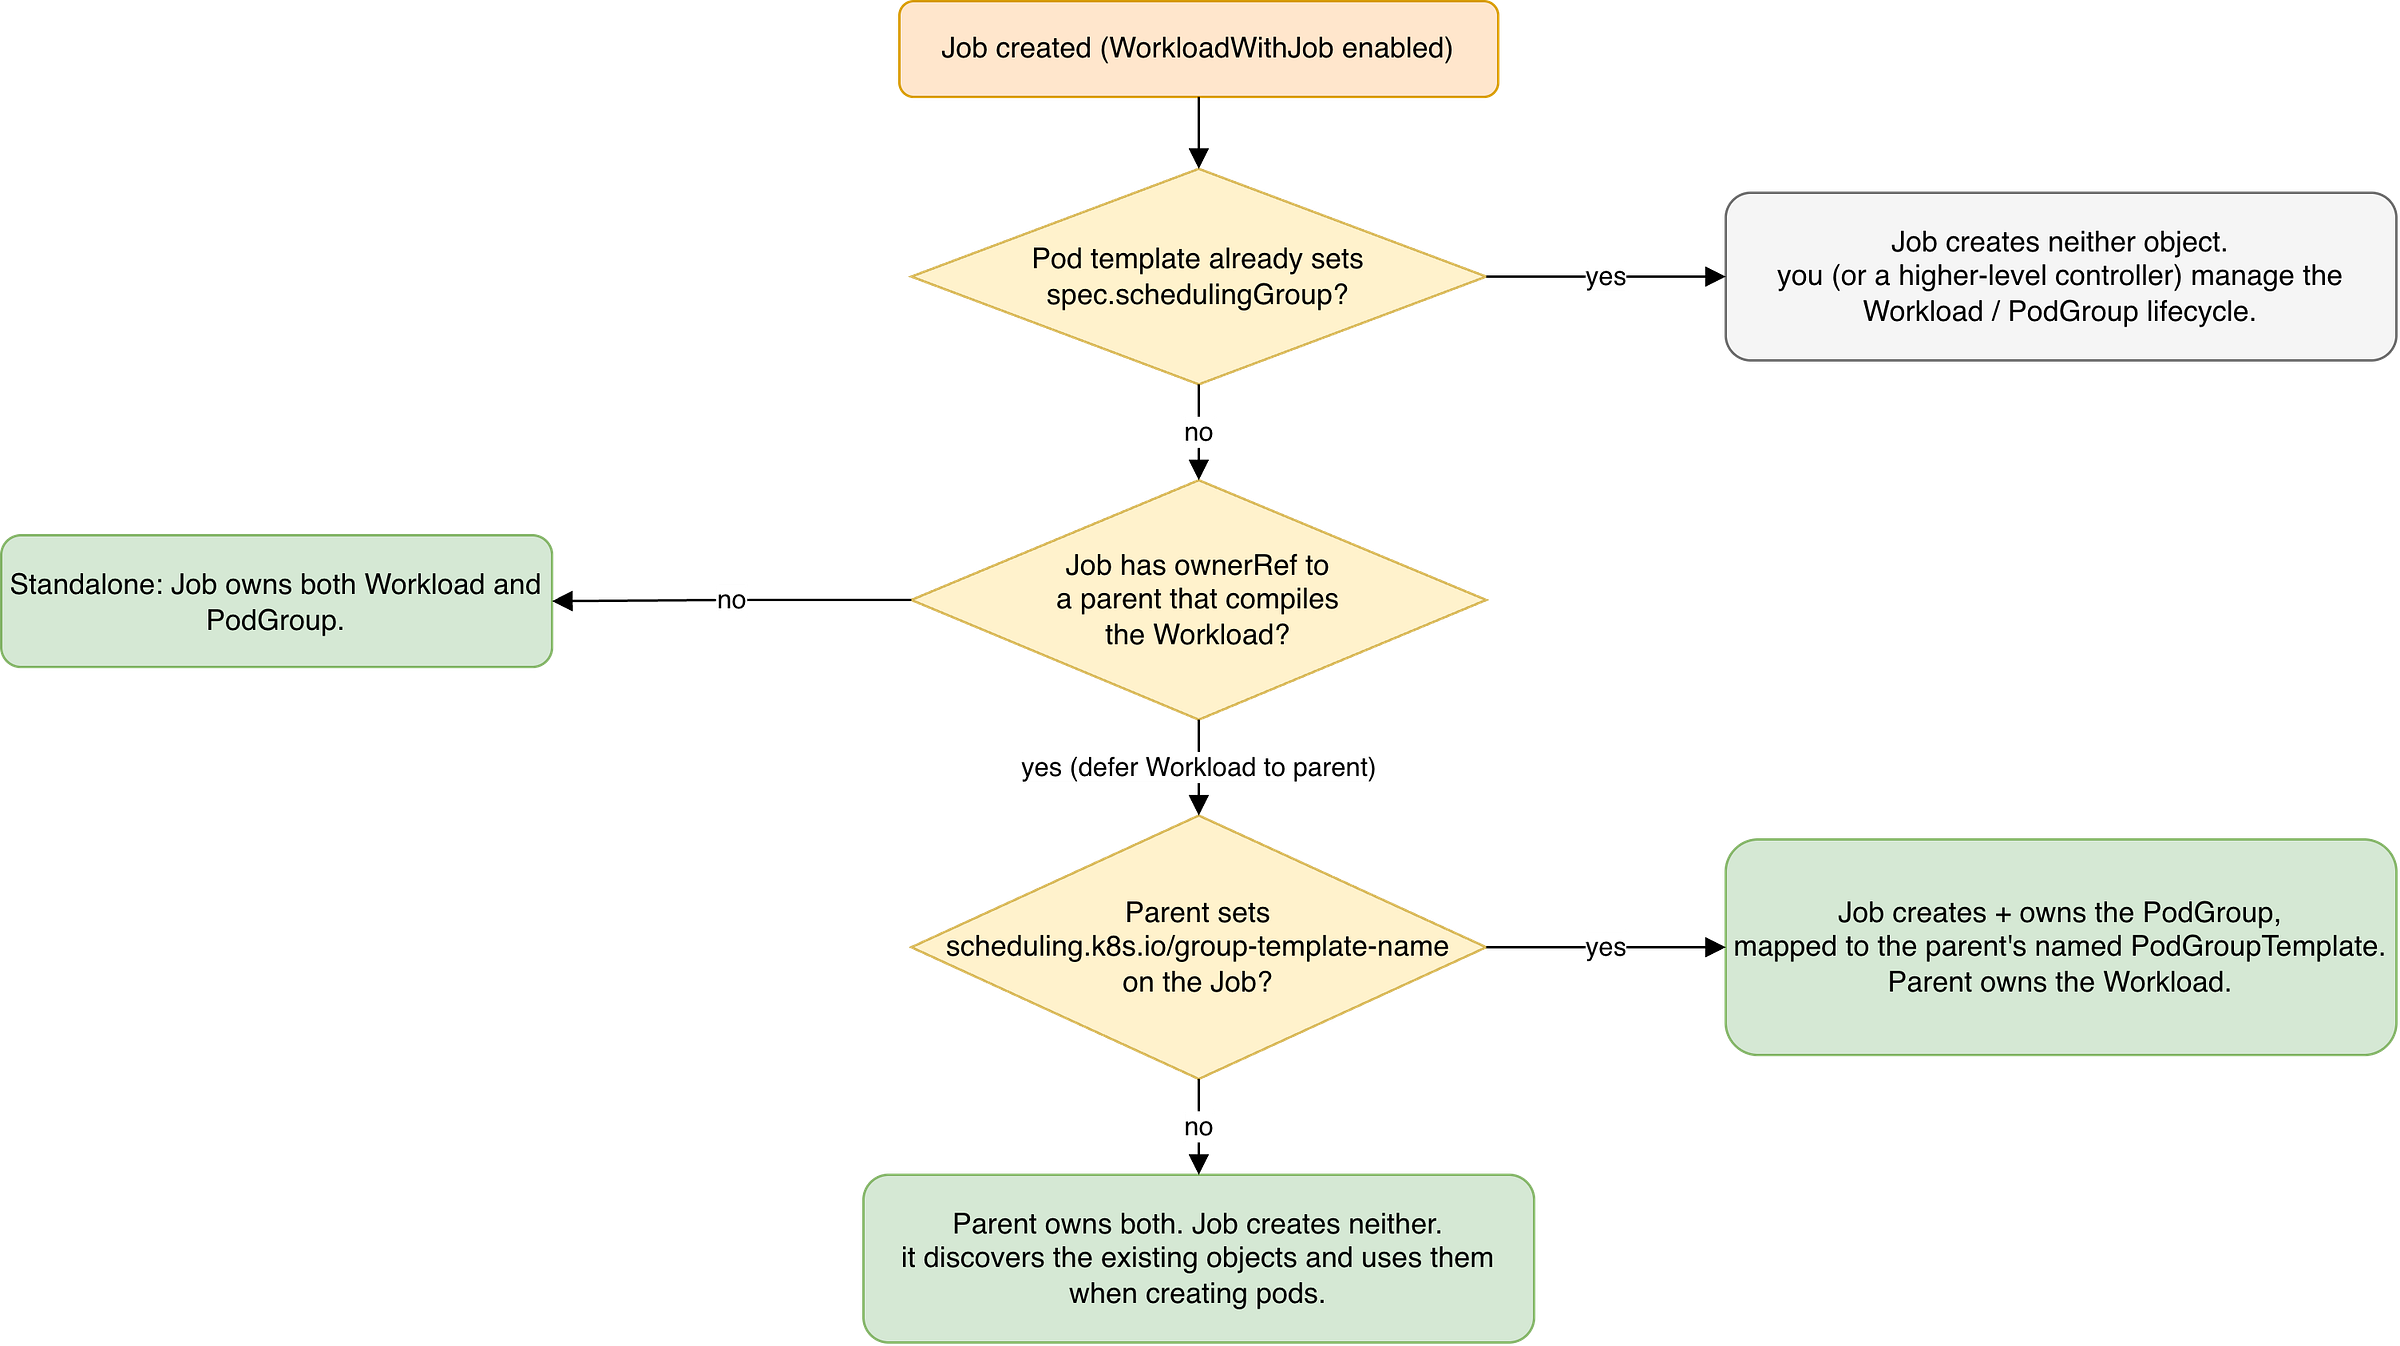
Вот весь контракт внешнего контроллера в миниатюре: родительский контроллер однократно вызывает BuildWorkload для компиляции дерева, именует свои PodGroupTemplate-ы и позволяет дочерним контроллерам прикреплять runtime-объекты PodGroup через NewBuilderFromExistingWorkload — ни один дочерний контроллер никогда не перекомпилирует Workload родителя.
CompositePodGroup для иерархических рабочих нагрузок
Плоских PodGroup достаточно для одного gang. Современные AI-нагрузки не плоские: JobSet — это набор дочерних Jobs; разгруженный инференс на LeaderWorkerSet — это лидер и воркеры с различными ролями.
CompositePodGroup позволяет контроллеру выразить эту иерархию напрямую, так что группировка, которую видит планировщик, отражает фактическую группировку рабочей нагрузки: родительский WorkloadItem компилируется в CompositePodGroupTemplate над дочерними, а параметр minGroupCount составной gang-политики задаёт, сколько дочерних групп должны быть размещены вместе.
Интеграция в экосистему
Встроенные примитивы имеют значение, только если контроллеры, которые люди реально запускают, их принимают. Интеграции с более широкой экосистемой уже в работе. Рабочая группа WAS сейчас взаимодействует с несколькими сообществами контроллеров; обратная связь положительная, блокеров для бета-статуса не выявлено. Трое заслуживают отдельного упоминания (наряду с KubeRay и TrainJob, которые находятся в той же когорте).
JobSet: направление — чтобы JobSet компилировал единый родительский Workload с именованными PodGroupTemplate-ами, а затем каждый дочерний Job прикреплял свою runtime-PodGroup через путь делегирования, описанный ранее, — аннотацию scheduling.k8s.io/group-template-name и NewBuilderFromExistingWorkload, с CompositePodGroup, выражающим группу групп. Стыковочный механизм для дочернего Job уже существует в контроллере Job версии 1.37, именно поэтому JobSet — самый прямой следующий потребитель.
LeaderWorkerSet (LWS) является основным драйвером для составных строительных блоков и CompositePodGroup, где один minGroupCount выражает «лидер и его воркеры принимаются как единица», не требуя от LWS самостоятельно реализовывать эту координацию.
Kueue (цель здесь — композиция, а не замена): WAS предоставляет нативный gang-примитив, а Kueue остаётся слоем очередей и квот поверх него. Задача — чистая совместная работа, чтобы рабочая нагрузка, допущенная через Kueue, могла выразить свой gang через встроенный контракт Workload/PodGroup, а не через специфичный для Kueue, — позволяя допуску, квотам и gang-механизму kube-scheduler складываться в стек, а не каждому переизобретать all-or-nothing размещение.
Если вы мейнтейните один из этих или другой контроллер рабочих нагрузок, сейчас самое время принести его форму в рабочую группу, пока поверхность v1alpha3 ещё податлива.
Попробуйте сами
Каждый из сценариев этой статьи — это запускаемый манифест в репозитории-компаньоне blog-demo → was-1.37. Поднимите локальный кластер kind с нужными feature gates, затем пройдитесь по сценариям с помощью скрипта с комментариями verify.sh.
Самое поучительное первое упражнение — Job с явным .spec.scheduling (02-gang-job.yaml). Примените его, а затем наблюдайте, как контроллер создаёт Workload и PodGroup и связывает поды с группой.