Вы масштабировали свой gRPC-сервис до пяти реплик. Одна из них перегружена до предела. Остальные четыре простаивают. Это не баг — это прямое следствие того, как Kubernetes передаёт трафик между подами. Стоит разобраться в механизме, и решение станет очевидным.
Чтобы понять, почему gRPC ведёт себя именно так, нужно проследить путь пакета от одного пода к другому и посмотреть, что с ним происходит на каждом шаге. Давайте построим картину с нуля — без магии, слой за слоем. К концу поведение gRPC не просто станет понятным — оно покажется неизбежным.
Каждый под получает настоящий, достижимый IP-адрес
Фундаментальное обещание сетевой модели Kubernetes простое: каждый под получает собственный IP-адрес, и любой под может напрямую обратиться к IP любого другого пода.
Это обещание выполняет плагин CNI (Container Network Interface) — например, AWS VPC CNI на EKS. Когда под назначается на узел, CNI выдаёт ему IP-адрес, подключает его сетевое пространство имён к узлу и делает этот адрес маршрутизируемым.
Теоретически, если под A знает IP пода B, он может просто подключиться — и всё. Но есть один принципиальный изъян: IP-адреса подов эфемерны. Под перезапустился, переехал на другой узел или сервис масштабировался — IP исчез. Жёстко задавать что-то, что пропадает при каждом деплое, невозможно. Да и если у сервиса пять реплик, какой из пяти адресов вообще использовать?
Нужно что-то стабильное, на что можно указать. Для этого и существует Service.
Service скрывает постоянную смену подов за единым виртуальным IP
Service предоставляет один стабильный идентификатор для постоянно меняющегося набора подов. Создайте ClusterIP Service — и Kubernetes назначит ему виртуальный IP (ClusterIP), который не изменится за всё время жизни этого Service.
Работу обеспечивают два компонента. CoreDNS — внутрикластерный DNS-сервер — разрешает имя вида my-svc.default.svc.cluster.local в адрес. А EndpointSlices ведут актуальный список подов, которые сейчас живы и готовы обслуживать запросы, — то есть хранят реальные IP-адреса за именем сервиса.
Однако то, что именно возвращает CoreDNS, зависит от типа Service. Обычный ClusterIP Service разрешается в единственный виртуальный IP. Headless Service (когда задано clusterIP: None) не имеет виртуального IP, поэтому CoreDNS возвращает сразу все IP-адреса подов напрямую:
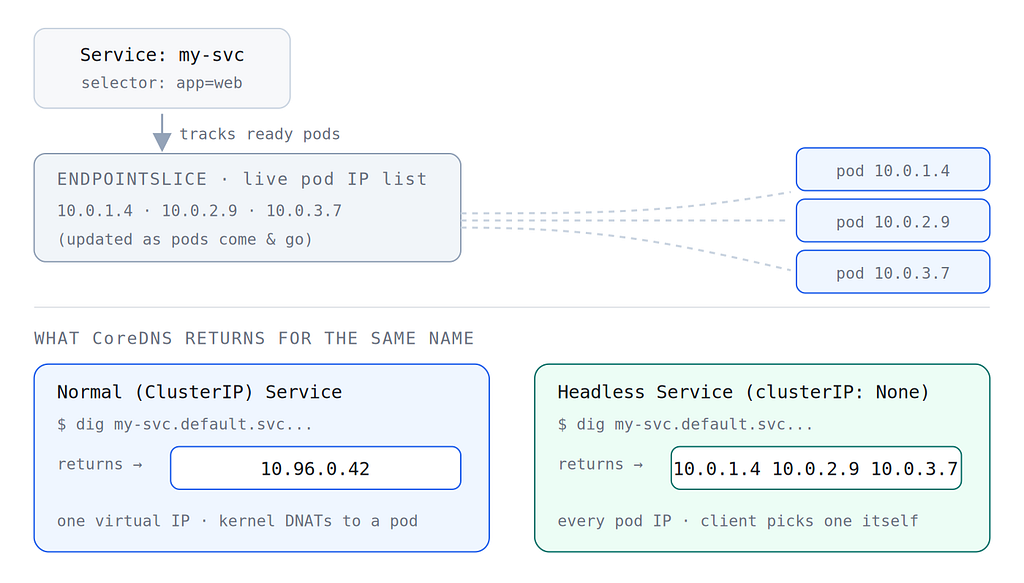
Один и тот же Service, один и тот же EndpointSlice — но ClusterIP возвращает один виртуальный IP, а headless — все IP подов.
Пока мы говорим об обычном ClusterIP Service с единственным виртуальным IP. Но обратите внимание: этот IP виртуальный — он не принадлежит ни одному реальному поду. Кто-то должен транслировать его в реальный IP пода при каждом новом соединении. Это задача последнего и самого непонятого компонента.
kube-proxy пишет правила; ядро выполняет работу
Здесь почти все немного ошибаются — давайте разберёмся точнее.
kube-proxy работает на каждом узле. Он следит за Services и EndpointSlices и записывает сетевые правила в ядро Linux (через iptables или IPVS). После этого он отходит в сторону.
Прочитайте ещё раз: kube-proxy записывает правила. Он не находится на пути вашего трафика. Фактическая трансляция — перезапись адреса назначения с ClusterIP на реальный IP пода — выполняется ядром по правилам, которые установил kube-proxy. Эта перезапись называется DNAT (Destination NAT).
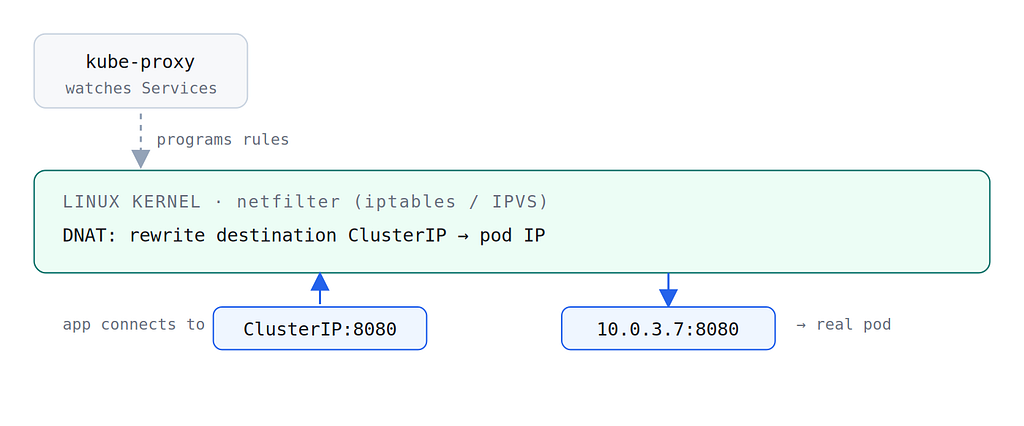
kube-proxy — это писатель правил, а не посредник. Перезапись каждого пакета делает ядро.
Система элегантна: она быстрая, работает на уровне ядра, и приложению ничего об этом знать не нужно. Но у неё есть одно свойство, которое скоро окажется критически важным.
Ядро не видит ничего выше четвёртого уровня
DNAT в ядре работает на уровне L4 — он видит IP-адреса и порты, и ничего больше. Ядро не знает, что внутри соединения: HTTP, gRPC или произвольные байты. Оно не может прочитать URL-путь, заголовок или имя метода. Для ядра соединение — это непрозрачный поток байтов между двумя парами IP:порт.
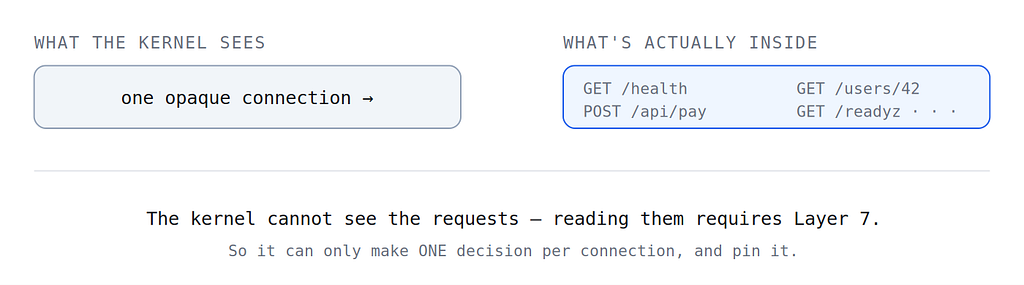
Из этого следует принципиальное последствие: kube-proxy балансирует по *соединениям, а не по запросам.* Когда приходит новое соединение, ядро один раз выбирает под-назначение и фиксирует всё соединение на нём. Все байты идут к этому единственному поду на всём протяжении жизни соединения — потому что разделить одно соединение между несколькими подами на уровне L4 невозможно. TCP-соединение имеет ровно одно назначение.
Для большинства HTTP/1.1-трафика это нормально. Понять почему — ключ к пониманию того, почему для gRPC это не так.
HTTP/1.1 выходит сухим из воды — но случайно
У HTTP/1.1 есть ограничение, которое, как ни странно, его и спасает: он не умеет мультиплексировать. Одно соединение несёт один запрос за раз. Поэтому когда клиенту нужна параллельность, он вынужден открывать много соединений — пул. Под нагрузкой клиент держит несколько открытых соединений одновременно.
И вот в чём спасение: много соединений — это много независимых решений DNAT, которые рассыпаются по всем подам. Нагрузка распределяется — не потому что ядро умное, а просто потому что соединений много.
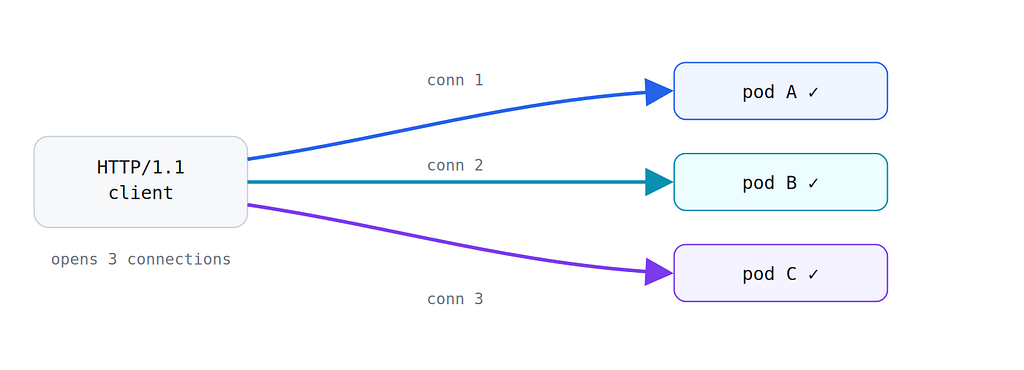
Слабость HTTP/1.1 (отсутствие мультиплексирования) случайно порождает его достоинство (приемлемое распределение нагрузки). Запомните эту мысль — gRPC делает ровно наоборот.
gRPC мультиплексирует всё в одно соединение
gRPC работает поверх HTTP/2, главной особенностью которого является полная противоположность HTTP/1.1: мультиплексирование. Он открывает одно долгоживущее TCP-соединение и передаёт по нему множество параллельных запросов — потоков (streams) — вперемешку в одном канале.
Это реальный выигрыш в производительности. Накладные расходы на TCP- и TLS-рукопожатие вы платите один раз, после чего переиспользуете соединение для тысяч запросов: никакой настройки на каждый запрос, никакой блокировки очереди. Именно в этом во многом и заключается быстрота gRPC.
Но теперь сопоставим это с тем, что мы знаем о kube-proxy:
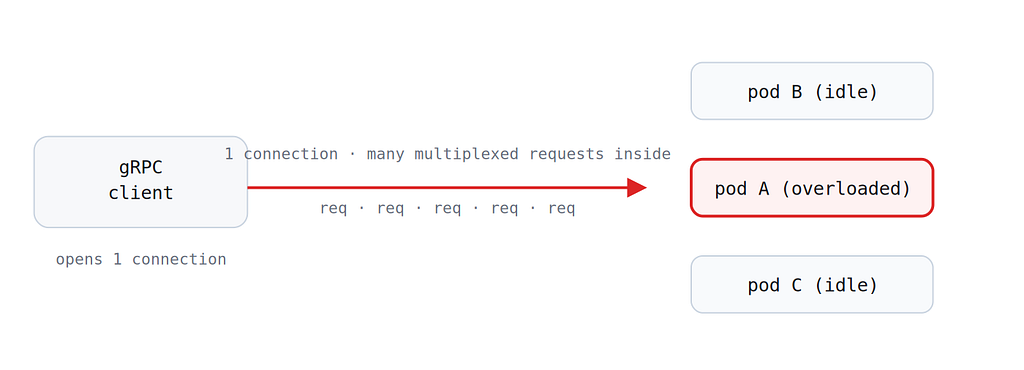
gRPC открывает одно соединение. Ядро балансирует по соединению и фиксирует его на одном поде. Следовательно, все gRPC-запросы — сколько бы их ни было — попадают на один и тот же под. Остальные реплики простаивают, и горизонтальное масштабирование не помогает: существующее соединение по-прежнему привязано к одному поду.
|
Примечание
|
Ядро не сломано и не относится к gRPC как-то иначе. Оно выполняет одну и ту же балансировку по соединениям для всего. HTTP/1.1 просто передаёт ему много соединений для распределения; gRPC передаёт одно. |
Вот и вся проблема в одном предложении. Множество запросов, скрытых внутри единственного соединения gRPC, невидимы для ядра — потому что их видно только на прикладном уровне, Layer 7.
Istio поднимает решение на уровень L7
Чтобы правильно балансировать gRPC, нужно что-то, способное заглянуть внутрь соединения, увидеть отдельные запросы и направить каждый потенциально к другому поду. Это требует работы на уровне L7, где видны HTTP/2-потоки. Ядро не может. Сервисная сетка (service mesh) вроде Istio — может.
Когда вы включаете Istio для своих подов, он встраивает sidecar-прокси — Envoy — в каждый под и незаметно перенаправляет трафик приложения через этот локальный прокси. В отличие от ядра, Envoy — полноценный L7-прокси: он терминирует соединение, разбирает HTTP/2 и видит каждый gRPC-запрос как отдельную единицу.
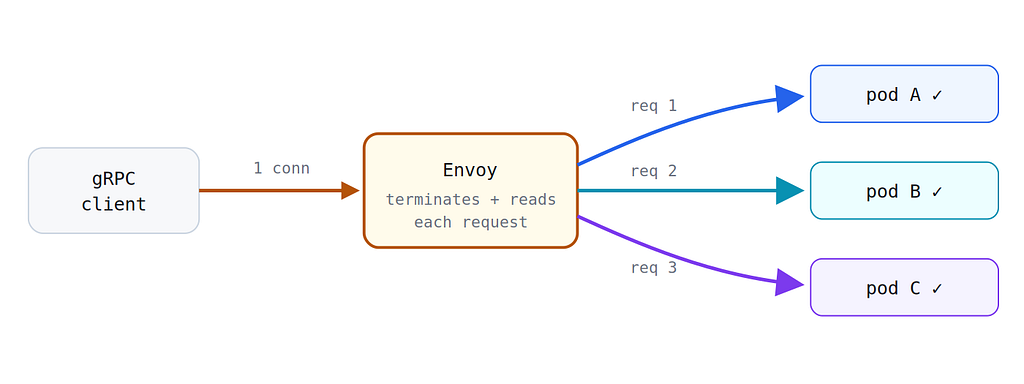
Вместо того чтобы привязывать соединение к одному поду, Envoy распределяет каждый запрос по всем здоровым репликам. Нагрузка выравнивается, и масштабирование начинает работать так, как вы и ожидали.
Компромисс вполне реальный: Envoy — это пользовательский прокси (userspace proxy), который терминирует и повторно разбирает каждый запрос, а значит стоит дороже, чем почти бесплатная L4-перезапись ядра — немного задержки на каждый хоп плюс CPU и память для прокси в каждом поде. Но взамен вы получаете то, что ядро структурно дать не может: понимание самого запроса. А раз вы уже на L7, повторные попытки (retries), таймауты, метрики на уровне запросов и автоматическое mTLS-шифрование достаются почти бесплатно — ведь всё это тоже требует видеть запрос.
Одна мысль, которую стоит запомнить
Если вы ничего не запомните из этой статьи, запомните одно: балансировка нагрузки в Kubernetes по умолчанию работает по соединениям, а не по запросам.
-
HTTP/1.1 открывает много соединений, поэтому балансировка по соединениям распределяет нагрузку достаточно равномерно.
-
gRPC мультиплексирует всё в одно соединение, поэтому балансировка по соединениям привязывает всё к одному поду.
Решение — подняться на уровень L7, используя сетку вроде Istio, где отдельные запросы становятся видимыми и могут балансироваться по одному.
Всё остальное — CNI, ClusterIP, kube-proxy, ядро, sidecar-прокси — лишь механизм, который делает эти три утверждения справедливыми. Стоит взглянуть на балансировку нагрузки как на вопрос о количестве соединений и о том, кто может заглянуть внутрь них — и вся система встаёт на своё место.
Спасибо за прочтение — это была моя первая статья. Если Kubernetes-networking стал чуть менее загадочным, буду рад вашим отзывам.