Как мы подключили on-prem-кластеры Kubernetes к GitOps-платформе на базе AKS, не пересобирая плоскость управления каждый раз при создании нового кластера.
Одна платформа, два вида железа
Наша платформа для разработчиков работает на управляемом Kubernetes в облаке — на AKS — и управляется через GitOps. Команда описывает сервис в записи реестра, Argo CD подхватывает её, и сервис появляется в нужном пространстве имён на нужном кластере. Никто не заводит тикет, никто не запускает kubectl вручную.
Однако не всё принадлежит облаку. Одни рабочие нагрузки должны находиться рядом с оборудованием в цеху, другие данные нельзя выносить за периметр здания, третье просто дешевле держать на железе, которое уже оплачено. Поэтому мы также запускаем кластеры Kubernetes в собственном дата-центре на vSphere. С самого начала мы решили, что эти кластеры не станут второй платформой со своими правилами — они присоединяются к уже существующей.
За словом «присоединяются» скрыта почти вся архитектура. Нам нужен роуминг: сервис должен уметь работать сегодня на облачном кластере, а завтра — на on-prem-кластере, выбранном исходя из стоимости, ёмкости, задержки или окна обслуживания, и команда, владеющая этим сервисом, не должна ничего в нём менять. Та же запись в реестре, тот же чарт, те же секреты, тот же доступ к тем же ресурсам. Размещение становится решением по планированию (scheduling decision), которое может принять и отменить инженер платформы — или в конечном счёте контроллер.
Роуминг работает только при единой идентичности на обеих сторонах. Если облачная копия сервиса аутентифицируется через федеративную идентичность (federated identity), а on-prem-копия — через клиентский секрет в Kubernetes Secret, то это не один и тот же сервис. Перед нами два варианта развёртывания, две истории ротации, две модели RBAC, и перемещение между кластерами превращается в небольшой миграционный проект. Как только идентичность расходится, роуминг перестаёт быть планированием и становится портированием.
Поэтому требование звучало так: единый источник идентичности для каждого кластера, на каком бы железе он ни находился. RBAC и доступ к секретам строятся на нём: та же идентичность Entra, те же назначения ролей, тот же путь к тому же хранилищу ключей. На практике это означает проецирование on-prem-кластеров в облачную плоскость идентичности — именно для этого и нужен агент подключённого кластера (connected-cluster agent). Мы используем Azure Arc. Он даёт on-prem-кластеру присутствие в облачной плоскости управления, чтобы тот мог нести те же конструкции идентичности и политик, что и управляемый кластер. Arc не запускает кластер — он нужен для того, чтобы сервис не знал, на какой кластер попал.
Кластеры создаёт пайплайн, а не люди
Вторая половина платформенного обещания — кластеры сами по себе дёшевы в создании и дёшевы в удалении. На on-prem это Cluster API: управляющий кластер (в нашем случае — виртуальный кластер поверх нашего общего инструментального кластера на AKS) хранит объекты Cluster, KubeadmControlPlane и MachineDeployment, а провайдер vSphere клонирует виртуальные машины из шаблона и запускает на них kubeadm. Создание кластера — это запуск workflow с именем кластера на входе.
Это важнее, чем кажется на первый взгляд. Если создание кластера требует присутствия инженера, кластер незаметно превращается в питомца (pet). Перестаёшь его пересобирать, перестаёшь тестировать пересборку, накапливается дрейф конфигурации, а план аварийного восстановления превращается в документ, а не в процедуру. Автономное создание — это то, что сохраняет кластеры одноразовыми, а одноразовые кластеры делают роуминг реальным.
Итак, два требования: каждый кластер подключается к единой плоскости идентичности, и каждый кластер можно создать с нуля за один автоматизированный прогон.
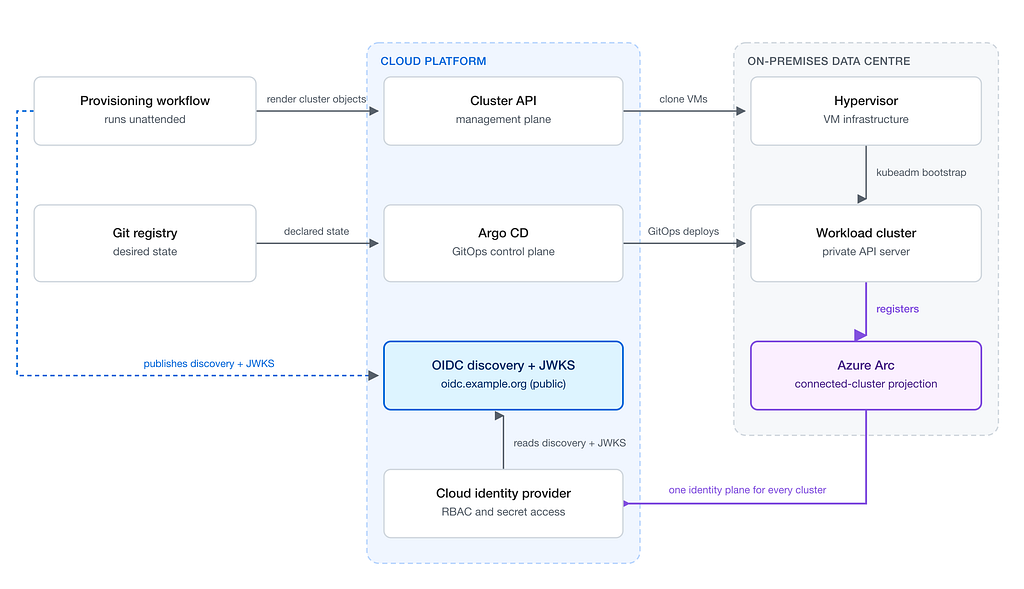
Эти два требования вступили в конфликт, и точкой столкновения оказался OIDC-эмитент (OIDC issuer).
Что на самом деле требует федерация
Механизм, который даёт поду облачную идентичность без хранимого секрета, — это workload identity. Под запрашивает у своего кластера краткосрочный токен, передаёт его провайдеру облачной идентичности и получает взамен настоящий токен доступа. Именно это мы хотели на обеих сторонах платформы, потому что только так сервис сохраняет одинаковую «проводку» идентичности, на каком бы кластере — AKS или on-prem — он ни оказался.
Если отбросить названия продуктов, нужны три вещи.
Кластер должен помечать свои токены идентификатором эмитента — просто URL. API-сервер вставляет его в claim iss каждого токена сервисного аккаунта, который подписывает.
По этому URL должны быть доступны два документа, и провайдер облачной идентичности должен уметь до них добраться:
https://<issuer>/.well-known/openid-configuration
https://<issuer>/openid/v1/jwks
Наконец, на облачной стороне регистрируется федеративный credential: «Я доверяю токенам от этого эмитента, для этого конкретного сервисного аккаунта, и обменяю их на доступ к этой идентичности».
Вот и весь контракт. Запомните его форму — именно она в конечном счёте решила нашу проблему.
Первый путь, который мы попробовали
У Arc есть функция именно для этого. Включаешь OIDC-эмитент на подключённом кластере, и облако само хостит документы обнаружения, опираясь на ключи подписи твоего кластера. Публично доступно, управляемо, ничего не нужно запускать или мониторить самому. Нам Arc уже был нужен для плоскости идентичности, поэтому использовать идущий с ним эмитент выглядело как бонус. Мы так и сделали.
Проблема — в порядке действий, и нам потребовалось время, чтобы её чётко сформулировать.
Чтобы подключить кластер, он должен существовать и быть здоровым. URL эмитента генерируется в процессе или после подключения и содержит генерируемый идентификатор, поэтому предсказать его заранее невозможно. URL эмитента становится известен только после того, как кластер уже работает.
Но --service-account-issuer — это флаг API-сервера. Он должен быть выставлен в этот URL, а на кластере Cluster API флаги API-сервера живут в спеке KubeadmControlPlane. Редактирование этой спеки не перезапускает процесс — оно запускает поочерёдную замену каждой машины плоскости управления.
Это не обходной путь, который мы придумали сами. Официальное руководство Microsoft по workload identity для Arc-enabled Kubernetes документирует именно такую последовательность для кластеров Cluster API: подключить кластер, получить сгенерированный URL эмитента, затем перейти в управляющий кластер и отредактировать аргументы API-сервера. Там же описывается, что эмитент — случайно сгенерированный GUID на каждый кластер, что и делает его принципиально непредсказуемым заранее.
Кое-что с тех пор изменилось, и это стоит знать, если вы сталкиваетесь с проблемой сегодня. Cluster API v1.12, вышедший в начале 2026 года, добавил обновления на месте (in-place updates): контроллер теперь может изменять работающую машину без её замены. Это не автоматически. Помимо короткого списка полей метаданных и таймаутов, которые всегда применялись на месте, обновление на месте требует расширения обновления (update extension) — runtime-хука, который вы устанавливаете и который сообщает Cluster API, как применить конкретное изменение к живой машине. Без него изменение флага API-сервера по-прежнему заменяет все машины плоскости управления — именно в такой ситуации были мы и в такой же ситуации остаётся кластер со стандартной установкой.
Хуже того, нельзя сменить эмитент за один шаг. Токены, уже находящиеся в полёте, подписаны старым эмитентом, и контроллеры, держащие их, сразу же начнут падать с ошибкой, как только API-сервер перестанет принимать старый эмитент. Безопасная последовательность состоит из двух фаз: сначала заставить API-сервер принимать оба эмитента со старым как основным, затем — со старым как вторичным. Два редактирования спеки плоскости управления. Два полных выкатывания.
На vSphere одно выкатывание плоскости управления означает: клонировать VM, загрузить её, добавить в кластер через kubeadm, дождаться, пока etcd примет нового члена, дождаться, пока старый член покинет кластер корректно, и повторить для каждого узла. При трёх узлах плоскости управления две фазы — это шесть замен машин. Когда всё шло хорошо, это занимало большую часть послеобеденного времени. Когда нет — а так бывало часто — мы отлаживали наполовину мигрированный кластер, в котором одни компоненты аутентифицировались нормально, другие получали отказ, а кворум etcd находился где-то посередине операции.
Именно здесь два требования столкнулись лоб в лоб. Наш workflow провизионирования должен быть единым прогоном: отрендерить объекты Cluster API, дождаться API-сервера, установить CNI, записать контракт доступа к кластеру, зарегистрировать кластер в Argo CD, завершить. Эмитент Arc вынуждал нас к второму акту, который не мог находиться внутри этого прогона, потому что зависел от значения, которое не существовало до завершения первого акта.
Мы всё равно автоматизировали второй акт. В результате получился workflow, который строил плоскость управления, а затем немедленно начинал её разрушать — с двухфазной миграцией посередине и без единой безопасной точки для возобновления, если машина зависала. На бумаге создание кластера было автоматизировано. На практике кто-нибудь следил за каждым прогоном, а при сбое восстанавливал кластер, которому было от силы несколько минут от роду.
Тем, что в конце концов заставило нас изменить курс, была не ненадёжность. Мы согласились с дизайном, в котором подключение к плоскости идентичности стоило нам автономного провизионирования. А это были именно те две вещи, на которых держалась платформа, и мы меняли одну на другую.
То, что мы должны были заметить раньше
Некоторое время мы пытались сделать выкатывание надёжнее. Лучшие ожидания, лучшая логика повторных попыток, лучшее обнаружение зависших машин. Потом кто-то задал более полезный вопрос: что именно провайдер идентичности запрашивает по URL эмитента?
Два JSON-документа. Вот и всё.
Документ обнаружения (discovery document) — несколько строк метаданных. JWKS — открытая половина ключевой пары, которой API-сервер подписывает токены сервисных аккаунтов. Ни тот ни другой не являются динамическими. Провайдер идентичности никогда не обращается к вашему API-серверу, никогда не открывает соединение в вашу сеть и понятия не имеет, работает ли ваш кластер вообще. Он читает два статических файла по HTTPS и использует открытый ключ для проверки подписи на токене, который под передал ему напрямую.
Увидев это, понимаешь: ограничение оборачивается. URL эмитента — не то, что платформа вам выдаёт. Это имя, которое вы выбираете сами, и единственные требования — уметь отдать два файла по этому имени и иметь API-сервер, подписывающий токены с этим именем в claim iss.
Мы воспринимали интерфейс как сервис.
Сначала выбираем URL
Мы перевернули порядок. URL эмитента теперь объявляется в нашем инвентаре кластеров до того, как кластер существует. Инвентарь — это HCL-файл, читаемый OpenTofu (открытым форком Terraform, который мы используем):
access = {
  server          = "https://10.10.0.1:6443"
  oidc_issuer_url = "https://oidc.example.org/clusters/cluster-a"
}
Провизионирование подставляет это значение напрямую в KubeadmControlPlane, из которого Cluster API строит кластер, — так что самый первый API-сервер, который когда-либо запускается, уже имеет свою постоянную идентичность:
apiServer:
  extraArgs:
    - name: service-account-issuer
      value: https://oidc.example.org/clusters/cluster-a
    - name: service-account-jwks-uri
      value: https://oidc.example.org/clusters/cluster-a/openid/v1/jwks
    - name: service-account-signing-key-file
      value: /etc/kubernetes/pki/sa.key
Флаг service-account-jwks-uri легко упустить, а значение его велико. Без него собственный документ обнаружения кластера публикует внутренний адрес API-сервера как место получения ключей, и документ, который вы публикуете, будет противоречить сам себе.
Никакой мутации постфактум, никакой поэтапной миграции, никакого выкатывания. Кластер рождается с той идентичностью, которую сохранит навсегда.
Публикуем два документа
API-сервер находится в приватной сети и не доступен из интернета — именно так, как нам и нужно. Провайдер идентичности находится в интернете. Поэтому последний шаг провизионирования копирует документы туда, где они будут публично доступны.
Читаем их из свежего кластера:
openid_configuration="$(kubectl get --raw /.well-known/openid-configuration)"
jwks="$(kubectl get --raw /openid/v1/jwks)"
Переписываем в документах ссылки на публичный URL:
openid_configuration="$(jq \
  --arg issuer   "https://oidc.example.org/clusters/cluster-a" \
  --arg jwks_uri "https://oidc.example.org/clusters/cluster-a/openid/v1/jwks" \
  '.issuer = $issuer | .jwks_uri = $jwks_uri' <<<"$openid_configuration")"
Эта перезапись не косметическая. Провайдер идентичности сравнивает поле issuer в документе с URL, по которому он его запросил, и с claim iss в токене. Если хотя бы одно из трёх не совпадает — обмен отклоняется.
Затем публикуем. Оба документа попадают в ConfigMap на кластере, у которого уже есть публичный ingress, и монтируются в простой nginx-под. Структура файлов отражает URL-путь, поэтому один статический корень обслуживает все наши кластеры:
/usr/share/nginx/html/clusters/cluster-a/.well-known/openid-configuration
/usr/share/nginx/html/clusters/cluster-a/openid/v1/jwks
Одно имя хоста — oidc.example.org — с маршрутом на кластер по префиксу пути /clusters/<name>. Подключение ещё одного кластера добавляет префикс пути. Инфраструктура не добавляется.
Этот момент удивляет людей, поэтому скажу прямо: всё это не является секретом. JWKS содержит открытые ключи. Документ обнаружения — метаданные. Отдавать и то и другое из неаутентифицированного nginx-пода — это правильный дизайн, а не срезание углов. Приватный ключ подписи никогда не покидает узлы плоскости управления.
Подключаем к облаку
После того как эмитент стабилен и доступен, федеративный credential — это обычный OpenTofu против Azure-провайдера:
resource "azurerm_federated_identity_credential" "external_dns" {
  name                = "fic-cluster-a-external-dns"
  resource_group_name = var.resource_group_name
  parent_id           = azurerm_user_assigned_identity.external_dns.id
  issuer              = "https://oidc.example.org/clusters/cluster-a"
  subject             = "system:serviceaccount:external-dns:external-dns"
  audience            = ["api://AzureADTokenExchange"]
}
Внутри кластера мы сами устанавливаем upstream-вебхук workload identity. Он инжектирует проецируемый токен и переменные окружения, которые ищут облачные SDK. Раньше мы использовали версию, которую устанавливает Arc; отключение её в пользу upstream-чарта стало частью того же изменения.
Arc сам остался ровно там, где был, и это намеренно. Он по-прежнему проецирует кластер в облачную плоскость управления, по-прежнему поддерживает представление инвентаря и политик, и по-прежнему является причиной того, что сервис получает одинаковые назначения ролей on-prem и на AKS. Всё, о чём говорилось в первой половине этой статьи, от Arc не изменилось. Единственное, чем Arc больше не владеет, — это идентичность подписи кластера. Мы забрали у него одну ответственность — ту единственную, которая лежала на критическом пути провизионирования — и оставили всё остальное нетронутым.
Путь времени выполнения (runtime path) короток. Под запрашивает токен у своего API-сервера. Предъявляет токен провайдеру идентичности. Провайдер запрашивает наши два файла, проверяет подпись по опубликованному ключу, убеждается, что эмитент и субъект сервисного аккаунта совпадают с зарегистрированным credential, и возвращает токен доступа. Единственное, что пересекает интернет в направлении внутрь, — это запрос двух статических документов.
Здесь платформенная цель и инженерная реализация наконец встречаются. Сервис описывается один раз и получает одинаковое обращение с идентичностью, куда бы его ни запланировали. Имя его сервисного аккаунта является субъектом федеративного credential и на AKS, и на on-prem; назначения его ролей — те же самые назначения; секреты он читает из того же места тем же механизмом. Единственное, чем отличаются два варианта, — это эмитент, подписавший токен, и в описании сервиса об этом нет ни слова. Перемещение рабочей нагрузки снова стало решением по планированию — именно этого мы и хотели с самого начала. При этом свежий on-prem-кластер — это один прогон workflow от начала до конца, без чьего-либо надзора.
Чего это стоило
Я предпочитаю честный отчёт торжественному, поэтому вот обратная сторона.
Теперь вы владеете эндпоинтом. Если oidc.example.org недоступен, ни одна on-prem-нагрузка не сможет получить новый облачный токен. Уже выданные токены доступа продолжат работать до истечения срока, так что мгновенного сбоя не будет, но это зависимость, которой раньше не существовало. Поставьте эндпоинт за тот же ingress и мониторинг, что и ваши другие публичные сервисы, и относитесь к нему как к продакшену — потому что это и есть продакшен.
Ротация ключей становится вашей задачей. То, что вы публикуете, — это снимок JWKS, сделанный во время провизионирования. Если ключи подписи сервисных аккаунтов плоскости управления когда-нибудь будут перегенерированы, опубликованные ключи устареют и вся федерация на этом кластере сломается. Ошибка проявится на облачной стороне как сбой проверки подписи — а это не то место, куда люди смотрят в первую очередь. Если вы строите это решение — сразу же добавьте задание по расписанию, которое перечитывает живой JWKS и перепубликует его при изменении. Делайте это одновременно с остальным. Мы отложили это на потом, и это единственное решение, которое я бы хотел принять иначе.
Кто-то должен это понимать. Управляемый эмитент — это галочка в портале. Здесь же — скрипт, ConfigMap и ingress-маршрут. Запишите, откуда берутся эти документы и что их перегенерирует, иначе следующий инженер найдёт nginx-под, раздающий JSON без очевидного владельца, и совершенно разумно решит, что его можно удалить.
Стоит ли повторять
Для задач такого рода — да, без колебаний.
Обновления на месте сужают аргумент, но не закрывают его. Даже там, где машины выживают, вы всё равно мутируете идентичность работающего кластера постфактум, всё равно выстраиваете последовательность двойной миграции эмитентов, чтобы токены, подписанные под старым именем, продолжали работать, и всё равно делаете это на критическом пути каждого нового кластера. «Дешевле» — не значит «не нужно».
Решающим фактором никогда не было противопоставление «самостоятельный хостинг vs. управляемый сервис». Вопрос был в том, когда URL эмитента становится известным. Любой эмитент, сообщающий свой URL только после того, как кластер запущен, вынуждает вас менять идентичность API-сервера постфактум, а на декларативно управляемой плоскости управления это означает замену машин. Если URL известен до запуска первой команды — этот целый класс работ исчезает. На управляемом облачном кластере провайдер сообщает эмитент во время создания, поэтому там никто с этим не сталкивается. На собственном железе с эмитентом, прикрученным после, вы наталкиваетесь на это немедленно.
Более широкий урок меньше и постыднее технического. Мы считали OIDC-эмитент сервисом — и отправились искать сервис, который его предоставит, а потом потратили недели на то, чтобы заставить работать неверный порядок. На самом деле это контракт: URL, два JSON-документа и ключ подписи, который у вас уже есть. Прочитай мы спецификацию вместо страницы продукта — сэкономили бы все эти недели.