tl;dr: Мы создали рабочий прототип Apache Kafka, распределённого между тремя независимыми кластерами Kubernetes с использованием Strimzi, Submariner и Cilium, и добились переключения без простоев при полном отказе одного кластера. В этой статье описаны архитектура, сложные проблемы, результаты тестов и паттерны, применимые далеко за пределами Kafka. Хочу искренне поблагодарить Rohananilkumar, который работал рядом со мной над этим проектом. Мы шли через это вместе, день за днём, почти два года, преодолевая все трудности на пути.
Почему эта задача важна
Apache Kafka стал основой инфраструктуры потоковой обработки данных в реальном времени, однако его модель развёртывания на Kubernetes содержит скрытое допущение: всё работает в одном кластере.
Когда этот кластер падает — а при достаточном масштабе это обязательно произойдёт — вместе с ним падает и весь Kafka. MirrorMaker 2 предоставляет асинхронную репликацию на второй кластер, но это не бесшовное решение. Вы получаете eventual consistency, а не строгую долговечность данных. Вы получаете переключение с простоем, а не прозрачную непрерывность.
Я хотел ответить на вопрос: может ли единый логический кластер Kafka охватывать несколько независимых кластеров Kubernetes, каждый со своей плоскостью управления, так чтобы потеря одного кластера целиком не приводила к остановке Kafka?
Это паттерн растянутого кластера (stretch cluster), позаимствованный из практики распределения баз данных наподобие Cassandra по дата-центрам, — но применённый к Kafka на Kubernetes. Никто ещё не реализовывал его с помощью Strimzi (CNCF Incubating). Мы решили выяснить, возможно ли это.
Я представил эту работу на StrimziCon 2025 и Confluent Current 2025. Видеообзор также доступен на YouTube.
Архитектура
Почему KRaft изменил всё
Этот проект стал реализуемым именно благодаря режиму KRaft в Apache Kafka. Операционная модель ZooKeeper делала межкластерные развёртывания практически невозможными: пришлось бы бороться с двумя системами распределённого консенсуса через высокозадержечный канал. Интегрированный протокол консенсуса на основе Raft в KRaft открыл нам понятный путь вперёд.
Дизайн из трёх кластеров
Central Cluster (Cluster A)
├── Strimzi Cluster Operator (управляет всеми тремя кластерами)
├── Kafka CR + KafkaNodePool CRs (источник истины)
├── Brokers: IDs 0, 1, 2
└── KRaft Controllers: IDs 3, 4, 5
Remote Cluster B
├── Local Strimzi Operator (сверяет только StrimziPodSets)
├── Brokers: IDs 6, 7, 8
└── KRaft Controllers: IDs 9, 10, 11Remote Cluster C
├── Local Strimzi Operator (сверяет только StrimziPodSets)
├── Brokers: IDs 12, 13, 14
└── KRaft Controllers: IDs 15, 16, 17Модель центральной плоскости управления: только один кластер запускает полноценный Strimzi Cluster Operator с CR-ресурсами Kafka и KafkaNodePool. Удалённые кластеры запускают ограниченный экземпляр Strimzi, который сверяет только StrimziPodSets и никогда не затрагивает конфигурацию уровня кластера. Это исключает split-brain на уровне оператора.
Архитектура плагинов
Разные среды имеют разные сетевые ограничения, поэтому мы построили систему плагинов для уровня межкластерного сетевого взаимодействия:
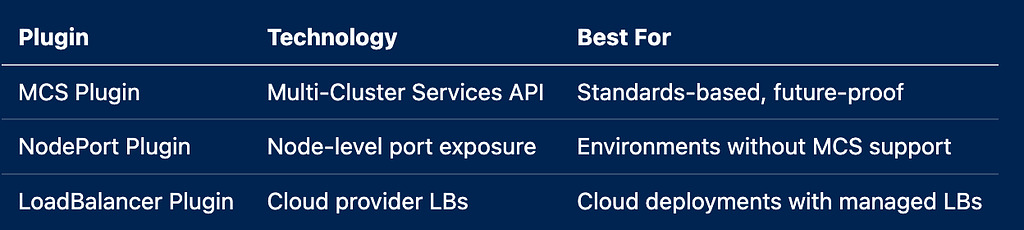
Интерфейс плагина намеренно минималистичен: каждый плагин реализует разрешение адресов и управление жизненным циклом сервисов. Добавить новый сетевой бэкенд несложно.
Сложные проблемы и способы их решения
Проблема 1: Межкластерный DNS
advertised.listeners в Kafka — это отправная точка всего. Каждый брокер объявляет адрес, по которому клиенты и другие брокеры обращаются к нему. В рамках одного кластера это DNS-имя сервиса Kubernetes. При развёртывании между кластерами нужен адрес, который резолвится везде.
API мультикластерных сервисов (Multi-Cluster Services API, KEP-1645) определяет .clusterset.local как DNS-пространство имён для межкластерных сервисов. Мы реализовали схему именования, генерирующую стабильные межкластерные DNS-имена:
<pod-name>.<cluster-id>.<service>.<namespace>.svc.clusterset.localОператор Strimzi был изменён так, чтобы генерировать эти имена при включённом режиме stretch cluster и заполнять advertised.listeners ими вместо стандартных внутрикластерных DNS-имён.
Хитрость: Strimzi генерирует адреса брокеров во время сверки (reconciliation), ещё до того, как поды существуют. DNS-имена должны быть детерминированными и согласованными между циклами сверки. Мы добавили аннотацию cluster-alias к ресурсам KafkaNodePool, которая предоставляет стабильный идентификатор кластера:
apiVersion: kafka.strimzi.io/v1
kind: KafkaNodePool
metadata:
  name: broker-pool-cluster-a
  labels:
    strimzi.io/cluster: my-stretch-cluster
  annotations:
    strimzi.io/stretch-cluster-alias: "cluster-a"
spec:
  replicas: 3
  roles:
    - broker
  storage:
    type: jbod
    volumes:
      - id: 0
        type: persistent-claim
        size: 100Gi
        deleteClaim: false
Проблема 2: SAN-расширения TLS-сертификатов
Внутренний центр сертификации Strimzi выдаёт TLS-сертификаты для всей коммуникации между брокерами и между контроллерами. Эти сертификаты должны содержать Subject Alternative Names (SAN), охватывающие каждый адрес, по которому может быть достигнут брокер, включая межкластерные DNS-имена.
Стандартная генерация сертификатов в Strimzi знала только о внутрикластерных адресах. Мы расширили её, добавив SAN с .clusterset.local для каждого брокера в каждом удалённом кластере.
Это также непосредственно связано с открытым issue #11291 об удалении OpenSSL из менеджера сертификатов: реализованная мной логика генерации пользовательских SAN даёт практическое понимание того, что именно должна обрабатывать замена на основе Java Security.
Проблема 3: Кворум KRaft-контроллеров через высокозадержечные каналы
Протокол консенсуса Raft в KRaft чувствителен к задержкам. В рамках одного дата-центра взаимодействие между контроллерами происходит за доли миллисекунды. Между кластерами задержка составляет 2–10 мс в зависимости от географии.
Конфигурация controller.quorum.voters требует статического указания адресов всех контроллеров при запуске. Мы настроили её, используя полные межкластерные DNS-имена для всех девяти контроллеров:
controller.quorum.voters=3@controller-3.cluster-a.controllers.kafka.svc.clusterset.local:9090,\
4@controller-4.cluster-a.controllers.kafka.svc.clusterset.local:9090,\
...
9@controller-9.cluster-b.controllers.kafka.svc.clusterset.local:9090,\
...
15@controller-15.cluster-c.controllers.kafka.svc.clusterset.local:9090,...
В протестированных конфигурациях кворум уверенно поддерживался при межкластерной задержке менее 10 мс. При задержке свыше ~50 мс время стабилизации выборов лидера заметно возрастает — стоит учитывать это при планировании географически распределённого развёртывания.
Проблема 4: Жизненный цикл ресурсов оператора между кластерами
Центральный оператор Strimzi должен создавать, обновлять и удалять ресурсы в удалённых кластерах, не имея административного доступа к Kafka-ресурсам этих кластеров. Мы реализовали это через секреты с ограниченными kubeconfig: центральный оператор имеет доступ только к конкретным пространствам имён в удалённых кластерах, где размещены Kafka-ресурсы.
Оператор отслеживает удалённые ресурсы с помощью lifecycle на основе финализаторов:
# Аннотация, добавляемая ко всем удалённым ресурсам
annotations:
  strimzi.io/stretch-cluster-alias: "cluster-b"
  strimzi.io/managed-by-central: "my-cluster"
При удалении центрального CR Kafka финализатор гарантирует, что удалённые StrimziPodSets будут очищены прежде, чем будут удалены центральные ресурсы.
Что показали тесты
Мы провели три категории тестов на отказ. Это реальные результаты из тестовой среды — никаких симуляций.
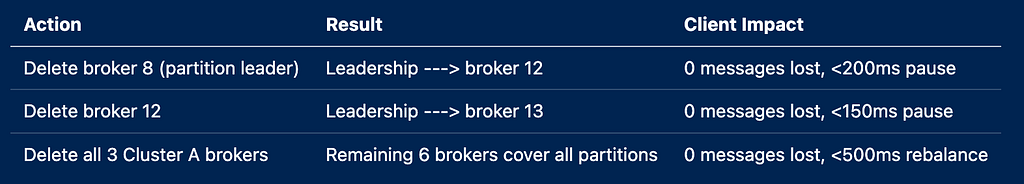
Переключение лидера брокера
Настройка: топик с 18 партициями, коэффициент репликации 9 (каждая партиция реплицируется на все 9 брокеров), продюсеры работают непрерывно со скоростью 1000 сообщений/сек.
Переключение кворума контроллеров
Начальное состояние: 9 контроллеров в 3 кластерах, лидер — Controller 5 (Cluster A).
Удалить Controller 5 ---> Лидер: Controller 4 (Cluster A) — выборы: ~800 мс
Удалить Controller 4 ---> Лидер: Controller 3 (Cluster A) — выборы: ~900 мс
Удалить Controller 3 ---> Лидер: Controller 9 (Cluster B) — выборы: ~1.2 с
Межкластерные выборы лидера работают. Время выборов ~1.2 с при смещении большинства кворума в удалённый кластер укладывается в ожидаемый рабочий диапазон KRaft.
Полный отказ кластера
Самый важный сценарий: все поды в Cluster A завершаются одновременно.
Результат: Kafka продолжил работу. Продюсеры и консьюмеры, подключённые к bootstrap-адресам кластеров B и C, продолжали работать без прерываний. Оставшиеся 6 брокеров покрывали все партиции. Оставшиеся 6 контроллеров сохранили кворум и выбрали нового лидера за 1.5 секунды.
Этот результат доказывает основной тезис: кластер Kafka может пережить полную потерю одного кластера Kubernetes — прозрачно, без какой-либо реконфигурации клиентов.
Сетевая производительность: Submariner против Cilium
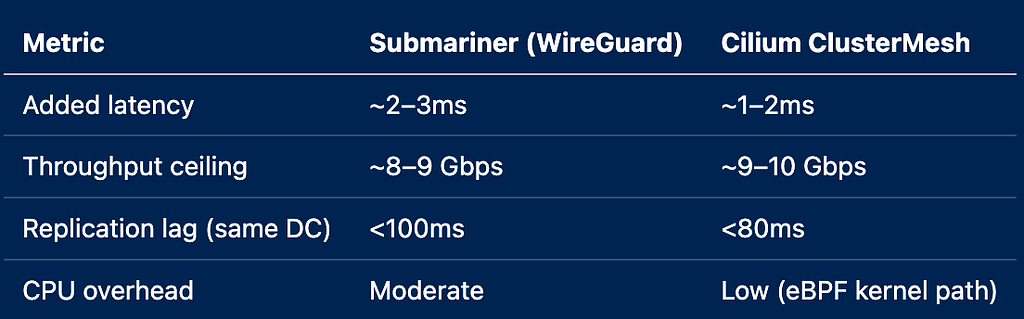
Для развёртываний, чувствительных к задержкам, подход Cilium на основе eBPF измеримо превосходит маршрут через userspace WireGuard в Submariner. Для большинства рабочих нагрузок Kafka эта разница несущественна, но знать о ней стоит.
Взаимодействие с сообществами
Этот проект потребовал одновременной работы с четырьмя CNCF-сообществами — такой подход я рекомендую начинать рано и открыто всем, кто строит решения на стыке нескольких проектов.
Strimzi (CNCF Incubating): Я представил два официальных предложения в репозиторий strimzi/proposals. Обратная связь от мейнтейнеров — особенно касательно сложности оператора и поверхности тестирования — существенно повлияла на архитектуру плагинов. Даже если предложение не принимают, процесс ревью заставляет проработать сценарии отказов, которые иначе легко упустить.
Submariner (CNCF Sandbox): Руководство команды Submariner по паттернам ServiceExport/ServiceImport и DNS для ClusterSet было неоценимым. Работа с разрывом между спецификацией MCS API и реальной реализацией в Submariner дала мне больше понимания о состоянии мультикластерных сетей, чем любая документация.
Cilium (CNCF Graduated): ClusterMesh от Cilium предоставляет аналогичный MCS-совместимый сетевой уровень с путём данных на eBPF. Тестирование обоих решений дало сравнение бок о бок, которое иначе было бы невозможно получить. Документация сообщества Cilium по межкластерной маршрутизации с ускорением eBPF превосходна.
Fabric8 Kubernetes Client: Построение мультикластерных клиентских паттернов на Java — управление несколькими kontexts kubeconfig, обработка ротации учётных данных, ограничение доступа к API по кластеру — было плохо задокументировано. Разработанные мной паттерны применимы для любого Java-оператора, которому нужно управлять ресурсами через границы кластеров.
Паттерны, применимые за пределами Kafka
Архитектурные паттерны из этого проекта не специфичны для Kafka. Если вы строите или эксплуатируете другие stateful-распределённые системы на Kubernetes, они напрямую применимы.
1. Центральная плоскость управления, распределённая плоскость данных. Один оператор владеет желаемым состоянием. Удалённые кластеры только сверяют ресурсы, которые центральный оператор передаёт им. Это предотвращает split-brain на уровне оператора без сложных выборов лидера между экземплярами операторов.
2. Детерминированные межкластерные имена во время сверки. Любой оператор, которому нужно ссылаться на ресурсы между кластерами, требует стабильных, заранее вычисляемых имён. Не генерируйте имена динамически во время выполнения — паттерн с аннотацией кластера даёт имена, которые можно вычислить ещё до того, как ресурс существует.
3. MCS API для обнаружения сервисов. DNS-пространство имён .clusterset.local становится стандартом для межкластерного обнаружения сервисов. Если вы сегодня строите что-то, что должно работать между кластерами, проектируйте обнаружение сервисов вокруг него — даже если реализуете его через NodePort или LoadBalancer в качестве запасного варианта.
4. Ограниченные межкластерные учётные данные. Не давайте центральному оператору права cluster-admin на удалённых кластерах. Генерируйте ограниченные kubeconfig, предоставляющие доступ только к конкретному пространству имён и ресурсам, которыми оператору нужно управлять. Используйте финализаторы, чтобы обеспечить правильный порядок очистки.
5. Подключаемые сетевые бэкенды. Технологии межкластерного сетевого взаимодействия меняются быстрее, чем логика приложения. Абстрагирование за интерфейсом плагина позволяет заменить Submariner на Cilium (или на будущую реализацию MCS) без изменения кода основного оператора.
Что доступно публично
Весь код и документация по этому проекту находятся в открытом доступе:
-
Документация: aswinayyolath.github.io/stretch-kafka-docs
-
Форк оператора (ветка 48-migration): github.com/aswinayyolath/strimzi-kafka-operator
-
MCS-плагин: github.com/aswinayyolath/strimzi-stretch-mcs-plugin
-
NodePort-плагин: github.com/aswinayyolath/strimzi-stretch-nodeport-plugin
-
LoadBalancer-плагин: github.com/aswinayyolath/strimzi-stretch-loadbalancer-plugin
-
Видеообзор на YouTube: Strimzi Kafka Stretch Cluster Prototype
Текущее состояние мультикластерного Kafka
Решение сообщества Strimzi не включать этот паттерн в основной оператор на данный момент — разумное: операционная поверхность реальна, и сценарий использования нуждается в большей производственной проверке, прежде чем войти в ядро. Но это не меняет того, что продемонстрировал прототип.
Мультикластерный Kafka на Kubernetes технически реализуем уже сегодня. Сетевые примитивы — MCS API, Submariner, Cilium ClusterMesh — достаточно зрелые. KRaft устранил ограничение ZooKeeper. Паттерны оператора проработаны.
Теперь нужны производственные развёртывания, которые подтвердят операционную модель и сформируют базу знаний сообщества. Если вы запускаете Kafka на Kubernetes в масштабе и думаете об устойчивости на уровне кластера, код выше — рабочая отправная точка.
Если вы работаете над мультикластерными архитектурами — будь то Kafka или что-то иное — мне было бы искренне интересно пообщаться. Найдите меня в CNCF Slack в канале #strimzi или откройте issue в любом из репозиториев выше.
Благодарности
Мейнтейнерам Strimzi, которые рецензировали предложения с настоящей технической глубиной, — особенно за обратную связь, которая привела к появлению архитектуры плагинов. Сообществам Submariner и Cilium — за терпеливые ответы на вопросы, которые порой были очень специфичными. И всем на StrimziCon 2025, кто обсуждал эту работу и критически оценивал недостаточно проработанные её части.