Конец прошлого года выдался для нас весьма нестабильным. Это хорошо видно на странице статусов, и нестабильность перекочевала в новый год. Многие аварии были вызваны единственной ошибкой, глубоко спрятанной в SQLite. На её поиск ушли месяцы кропотливой работы.
Теперь, когда наступило лето, мы уверены: ошибка найдена, понята — и, что важнее, исправлена.
Мы знаем, что наши клиенты рассчитывают на надёжность Tailscale, и несколько месяцев мы не соответствовали этим ожиданиям. Это доставило неудобства, и мы приносим извинения. Этот пост написан для того, чтобы объяснить, что пошло не так, как мы реагировали и как в итоге помогли обнаружить давнюю ошибку в самом сердце базы данных SQLite.
Архитектура базы данных Tailscale
Хотя с точки зрения клиентов наш управляющий уровень (control plane) выглядит как единая публичная точка входа (controlplane.tailscale.com), внутри он разделён на набор серверов координации — «шардов» (shards). Каждая сеть (tailnet) в каждый момент времени живёт на одном внутреннем шарде, но может прозрачно переехать на другой. Шарды — деталь внутренней реализации: вы не знаете, на каком шарде находится ваша сеть, и вам не нужно это знать.
На каждом шарде есть база данных SQLite, хранящая всю информацию о сетях на этом шарде. Единственный Go-процесс имеет к ней эксклюзивный доступ и обслуживает управляющий уровень для соответствующих сетей. Такая схема «один писатель» — именно то, для чего SQLite предназначена.
SQLite используется в качестве основной базы данных с 2022 года; мы выбрали её за известность, надёжность и широкую распространённость. SQLite — это «скучная технология», и в хорошем смысле. Многие компании используют SQLite в масштабах значительно крупнее нашего без каких-либо проблем, и мы рассчитывали на такой же беспроблемный опыт.
В нашем конвейере резервного копирования мы каждые несколько минут снимаем полный снимок базы данных и загружаем весь файл SQLite в бакет S3. Эта схема работала без сбоев с начала 2023 года.
Однако прошлым летом, в августе, конвейер обработки данных, читающий резервные копии из S3, сообщил об ошибке в одной из баз. Мы запустили команду PRAGMA integrity_check против этой резервной копии и убедились, что она действительно повреждена. Повреждение SQLite теоретически возможно, но крайне редко и в нормальных условиях встречаться не должно. Мы восстановили повреждённую базу и попытались разобраться в причинах — безуспешно.
В достаточно больших масштабах даже редкие события случаются с некоторой периодичностью, поэтому, когда ситуация повторилась — ещё раз, ещё раз, и снова, и снова — нам не следовало удивляться. В общей сложности за шесть месяцев до устранения первопричины мы столкнулись с 19 отдельными случаями повреждения базы данных.
Когда слышишь слова «повреждение базы данных», первая мысль — о потере данных. Поскольку наш управляющий уровень хранит только конфигурационные данные, в этих базах находятся метаданные о вашей сети и устройствах, но никогда — ваши приватные ключи шифрования или сетевой трафик. В ранних инцидентах восстановление означало, что несколько только что добавленных устройств или изменений конфигурации не сохранились, и небольшой объём метаданных пришлось ввести заново.
Каждый раз при повреждении нам приходилось останавливать процесс управляющего уровня на шарде, пока мы восстанавливали или чинили базу. Для сетей на этом шарде это было болезненно: весь их управляющий уровень исчезал на время восстановления. В первых инцидентах простой превышал час, но постепенно, от инцидента к инциденту, мы ускоряли процесс.
Каждая сеть Tailscale — это mesh-сеть (ячеистая сеть), в которой устройства устанавливают прямые соединения WireGuard® друг с другом. Когда устройство подключается к сети, ему нужно получить список других устройств от управляющего уровня, прежде чем оно сможет установить новые соединения. Если устройство выходило в онлайн во время простоя SQLite, оно не могло подключиться. Пока база восстанавливалась, устройства, уже находившиеся в сети, сохраняли соединения между собой, но не могли узнавать об изменениях в сети. Эти сети также временно теряли доступ к веб-консоли администратора и API Tailscale.
Есть и более широкое последствие — подрыв доверия. Мы публикуем глобальный инцидент на странице статусов, даже когда затронуто лишь небольшое число сетей. Многие видели запись о происшествии, которое их вовсе не касалось. На самом деле большинство шардов и сетей никогда не участвовали в инцидентах с повреждением баз! Тем не менее повторяющиеся сбои подрывают доверие — независимо от того, были вы затронуты напрямую или нет.
С самого первого инцидента мы понимали, что это серьёзная угроза нашей надёжности, и вложили в решение проблемы огромное количество инженерного времени — однако исправление не давалось.
Поиск причины
Ошибка отвергала все наши первоначальные попытки её обнаружить.
Мы проверили недавние изменения, но ни одно не казалось относящимся к делу. Никто не работал над низкоуровневым кодом взаимодействия с SQLite: он был написан несколько лет назад и до этого момента не вызывал проблем. Мы перечитали весь этот код под мелкоячеистой гребёнкой в поисках ранее упущенных ошибок, но ничего, способного вызвать наблюдаемые повреждения, не нашли.
Мы искали общие факторы между инцидентами, но и здесь безрезультатно. Повреждения не были привязаны к конкретному шарду, клиенту, функциональности сети, времени суток или уровню нагрузки. Что могло провоцировать поведение, оставалось загадкой.
Отсутствие надёжных условий воспроизведения означало, что синтетически воспроизвести ошибку мы не можем. Вместо этого пришлось разворачивать пассивную криминалистическую (forensic) телеметрию в живой среде, чтобы поймать повреждение с поличным. Собирать диагностику баз данных в боевой среде — последнее, чего бы нам хотелось, но выбора не было.
Дополнительную сложность создавало то, что повреждения не происходили с какой-либо регулярностью. Иногда инциденты случались с разницей в часы, иногда — в недели. Это мешало оценивать прогресс или планировать дальнейшую работу: мы никогда не знали, когда получим следующий диагностический дамп. С октября по декабрь у нас был шестинедельный период без инцидентов — а потом они вернулись в виде неприятного новогоднего подарка.
Понимая, что быстрого решения не будет, мы обратились к разработчикам SQLite за контрактом профессиональной поддержки. Это оказалось правильным решением: мы получили прямой доступ к их глубокой экспертизе и провели множество детальных технических бесед об архитектуре нашей системы и наших инцидентах.
Совместно с командой SQLite мы разработали несколько гипотез о причинах повреждений — в том числе некорректная работа блокировок POSIX при вызове close(), некорректное управление памятью, принадлежащей SQLite, или случайное использование SQLite из нескольких потоков при отключённой потокобезопасности. После каждого инцидента мы собирали больше данных, добавляли диагностику и методично исключали гипотезы. Мы постепенно приближались к истинной причине.
Транзакции, которые не сработали
Пока мы искали первопричину, нам предстояло поддерживать работу живой платформы. Мы предприняли активные меры по автоматизации восстановления и минимизации простоев:
-
Настроили шарды управляющего уровня на немедленную аварийную остановку при обнаружении повреждения.
-
Развернули автоматизированный монитор резервных копий, непрерывно выполняющий
PRAGMA integrity_checkнад нашими бэкапами. -
Улучшили дежурные инструкции (runbooks) и обучение дежурных.
Эти меры сократили время реагирования до менее чем часа — и тут мы обнаружили неожиданную улику.
Нам нужен был способ восстановить сервис, не откатываясь к последнему заведомо исправному бэкапу (что означало бы потерю большого объёма данных) и не восстанавливая заведомо повреждённую базу (что было потенциально рискованно).
Для этого мы построили конвейер журналирования транзакций. Мы транслировали каждый SQL-оператор, изменяющий базу данных, в отдельный лог-файл. Поскольку SQLite — это база с единственным писателем с сериализуемыми транзакциями (serialisable transactions), история транзакций была полностью линейной и детерминированной. (В базах с несколькими писателями, таких как Postgres или MySQL, это было бы невозможно.) Воспроизведение этих транзакций поверх последнего заведомо исправного бэкапа должно было восстановить базу в актуальное состояние, безопасно обойдя повреждение.
Конвейер работал, но затем сделал нечто ещё более ценное — подбросил нам улику.
В двух инцидентах наши журналы транзакций не воспроизвелись чисто. При ближайшем рассмотрении выяснилось, что данные, записанные и зафиксированные одной транзакцией, необъяснимо не были видны последующим транзакциям. Запись исчезла в никуда, не вызвав никакой ошибки. Это должно быть невозможно!
Запись в WAL
Пока инциденты продолжались, разработчики SQLite работали над новым инструментом отладки. Некоторое время мы подозревали, что ошибка связана с процессом контрольных точек (checkpoint). Они создавали инструмент, дающий лучшую видимость происходящего во время контрольных точек.
Чтобы понять, что этот инструмент обнаружил, нужно вкратце объяснить принцип работы контрольных точек в SQLite.
База данных SQLite состоит из «страниц» (pages) — небольших блоков данных. При обновлении базы некоторые страницы необходимо заменить новыми с обновлённой информацией.
Для повышения производительности и улучшения параллелизма мы используем SQLite с журналом упреждающей записи (Write-Ahead Logging, WAL). Это означает, что новые страницы не записываются напрямую в файл базы данных, а попадают в «журнал упреждающей записи» — WAL-файл.
Записывать новые страницы в WAL-файл бесконечно нельзя: в какой-то момент их нужно скопировать обратно в основной файл базы данных. Этот процесс называется «созданием контрольной точки» (checkpointing).
В большинстве случаев SQLite сам решает, когда делать контрольную точку, и этот процесс невидим для конечного пользователя и разработчика. В нашем управляющем уровне мы берём ручное управление процессом контрольных точек, чтобы обеспечивать быстрое и согласованное резервное копирование. Этот нестандартный подход казался нам подозрительным по мере того, как мы исключали другие возможные причины.
Одной из улик было то, что во время инцидентов с повреждением наши метрики показывали: SQLite сообщает о копировании из WAL-файла большего количества страниц, чем там реально находилось. Если в WAL-файле 10 страниц, а скопировано 20 — что-то явно не так.
Чтобы понять, что происходило во время этих сбойных контрольных точек, разработчики SQLite создали новый инструмент отладки для слоя виртуальной файловой системы (virtual filesystem).
SQLite разделён на несколько слоёв. Верхний слой — парсер и генератор кода, преобразующий SQL-операторы во внутренние структуры данных SQLite. Они передаются в менеджер страниц (pager), который разбивает их на отдельные страницы для записи на диск. Непосредственно записью на диск занимается интерфейс операционной системы — «виртуальная файловая система» (virtual filesystem). На данный момент в SQLite есть две основных реализации виртуальной файловой системы — для Unix и для Windows.
Если вас интересует более глубокое погружение во внутреннее устройство SQLite, рекомендую эту лекцию Ричарда Хиппа, основного автора SQLite.
Такая архитектура позволяет заменять отдельные слои другими реализациями или оборачивать существующий слой для получения дополнительной информации. Чтобы помочь нам с диагностикой, разработчики SQLite создали обёртку вокруг виртуальной файловой системы, записывающую дополнительную трассировочную информацию и логи изменений базы данных. Эта обёртка называется шимом (shim) tmstmpvfs, и её исходный код доступен в публичном репозитории SQLite.
Мы развернули шим в боевой среде и стали ждать следующего повреждения. К счастью, ждать пришлось недолго.
Ошибка WAL-Reset
После очередного инцидента с повреждением дополнительные логи нового шима tmstmpvfs позволили разработчикам SQLite найти и исправить ошибку: редкое состояние гонки (data race) в исходном коде SQLite между контрольной точкой и транзакцией записи.
Суть в следующем: если запись происходит в определённый момент во время создания контрольной точки, процесс создания контрольной точки путается — он считает, что часть страниц уже скопирована из WAL в основной файл базы данных, хотя на самом деле этого не произошло. Эти страницы так и не попадают в файл базы данных, и данные теряются безвозвратно. Файл базы данных оказывается повреждённым, потому что другие страницы, ссылающиеся на утерянные — например, индексы — всё же были в него записаны.
Разработчики SQLite назвали это «ошибкой WAL-Reset» и оценили, что она присутствовала в SQLite не менее 16 лет. Такой долгий срок жизни объясняется редкостью ошибки — настолько редкой, что разработчикам SQLite пришлось добавить специальный код, намеренно провоцирующий её в тестовых средах. Исправление добавляет дополнительную проверку в функцию создания контрольной точки, которая определяет, был ли WAL сброшен другим потоком.
Разработчики подтвердили, что именно эта ошибка вызывала всё загадочное поведение, которое мы наблюдали. Она объясняла и повреждения, и журналы транзакций, которые не применялись чисто, и непоследовательную статистику контрольных точек. Они также объяснили, почему мы сталкивались с ошибкой чаще других пользователей SQLite: мы берём ручное управление процессом контрольных точек и создаём их очень агрессивно. Даже редкое событие при таком подходе рано или поздно должно было нас настигнуть.
Момент был захватывающим. После месяцев замешательства и неопределённости у нас наконец появилась правдоподобная теория причин повреждений и исправление, которое можно было развернуть.
Разработчики SQLite выпустили исправление в составе SQLite 3.52.0, и мы были готовы развернуть его, как только оно стало доступно.
Исправление и ложная тревога
Мы осторожно внедряли SQLite 3.52.0 — сначала на нескольких шардах-«канарейках» (canary shards), и лишь убедившись в стабильной работе, развернули на остальной части управляющего уровня.
Монитор резервных копий немедленно выдал ошибки и сообщил о повреждении в 13 разных базах данных. Это было крайне тревожно, но мы следовали процедурам восстановления, исправили все предполагаемые повреждения, и всё пришло в норму. Как выяснилось, эти базы не получили реального повреждения — они столкнулись с другой проблемой в этой версии SQLite.
Мы поделились данными об ошибках с разработчиками SQLite, что привело к обнаружению ошибки в SQLite, связанной с устаревшими индексами по выражениям (stale expression indexes). Если создать индекс по вычисляемому значению, а потом вычисление изменится, индекс будет содержать несоответствующие значения — и PRAGMA integrity_check будет сообщать об этом как о повреждении.
В нашем случае мы хранили некоторые высокоточные временны́е метки в виде текста, конвертируя их в число с плавающей точкой через VIRTUAL-генерируемый столбец. Релиз SQLite 3.52.0, исправивший состояние гонки, одновременно внёс оптимизацию, тонко изменившую поведение округления при конвертации текста в числа с плавающей точкой. Наши шарды-«канарейки» не содержали временны́х меток, на которых проявлялось изменённое поведение округления, — поэтому при поэтапном развёртывании мы это пропустили.
Поскольку изменение вызывало ложные предупреждения о повреждении, разработчики SQLite отозвали релиз 3.52.0 и вместо него опубликовали 3.51.3, содержащий только исправление ошибки WAL-Reset.
Мы устранили проблему на своей стороне, снизив точность временны́х меток до целых секунд: конвертация текста в целые числа однозначна. Тем временем разработчики SQLite создали автоматический механизм самовосстановления индексов (self-healing index feature) в версии 3.53.0, предотвращающий проблему устаревших индексов по выражениям.
Праздник!
Развернув исправление на весь управляющий уровень, мы были готовы праздновать победу — но сохраняли осторожность. Отсутствие инцидентов с повреждением само по себе не означает, что всё исправлено: у нас уже был один шестинедельный период обманчивого спокойствия.
Нам нужно было положительное доказательство того, что состояние гонки действительно возникало в нашей производственной среде. Понимая теперь причину ошибки — столкновение транзакции записи и сброса WAL, — мы изменили наш драйвер SQLite так, чтобы записывалось предупреждение, когда эти две операции пересекаются. Если предупреждение сработало бы, но база осталась нетронутой, мы бы знали: исправление спасло нас от потенциального повреждения.
Мы развернули предупреждение и стали ждать. Ждали. И ждали. И ждали. Проходили недели, и мы начали задаваться вопросом: может, предупреждение сломано? Может, наша теория неверна? Может, настоящая ошибка всё ещё притаилась в темноте?
Два месяца спустя долгожданное оповещение наконец сработало:
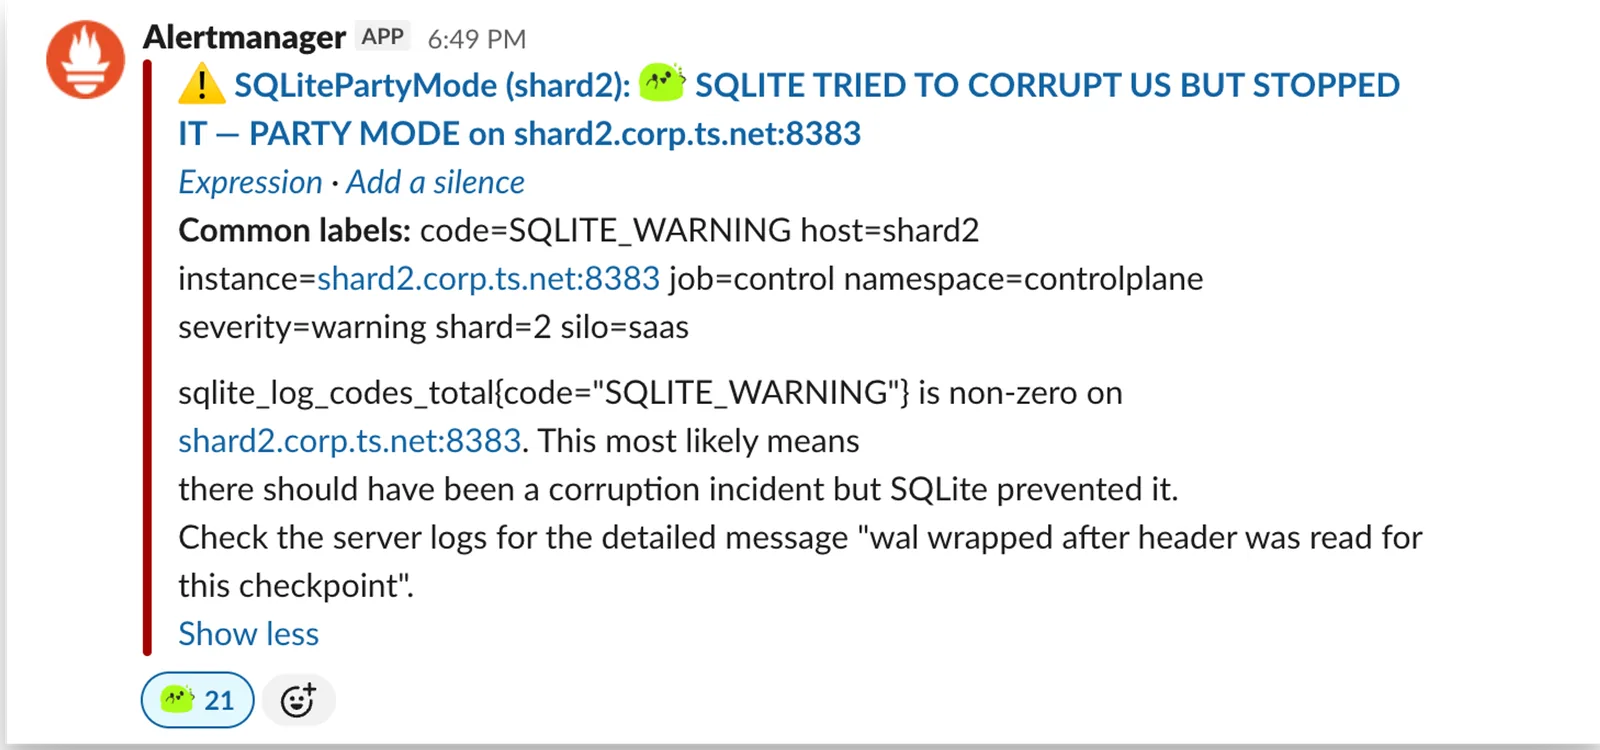
Это оповещение доказало, что точные условия для ошибки WAL-Reset действительно возникают в нашей производственной среде — а значит, именно она была вероятной причиной шести месяцев нестабильной работы.
С момента, когда сработало это странно радостное оповещение, прошло ещё четыре месяца без каких-либо инцидентов с базой данных — на момент написания этого поста. Наконец-то можно выдохнуть.
За пределами проторённой дороги
Никто не хотел, чтобы мы тратили шесть месяцев на поиск ошибок в SQLite. Это был крайне изматывающий опыт как для наших клиентов, так и для нашей команды, и мы рады оставить эту нестабильность позади.
Это расследование — полезное напоминание: использование «скучных» технологий нестандартным образом сопряжено с риском. Общепринятые пути и стандартные конфигурации невероятно хорошо протестированы и надёжны. Большинство людей использует SQLite в стандартной конфигурации и никогда не сталкивается с подобными проблемами. Всё, что мы делали, было публично задокументированной и поддерживаемой конфигурацией — но, взяв ручное управление процессом контрольных точек и установив собственный агрессивный темп, мы свернули с проторённого операционного пути.
Устранение этих инцидентов потребовало огромных усилий многих команд — десятков людей, включая инженерный отдел и службу поддержки Tailscale, а также основных разработчиков SQLite. Именно их заслуга в том, что последствия инцидентов не оказались значительно хуже.
Мы знаем, что повторяющиеся сбои подрывают доверие — сколько бы пользователей они ни затронули. Мы благодарны нашим клиентам за терпение и поддержку, пока мы разбирались в происходящем.
Каким бы изматывающим ни был этот период, мы вышли из него в более сильной позиции, чем прежде. Давняя ошибка в SQLite исправлена, а попутно мы устранили десятки других случайно обнаруженных проблем. Мы профинансировали создание open-source шима SQLite VFS, который помог быстро локализовать состояние гонки и поможет отслеживать похожие ошибки в будущем. Наконец, мы усовершенствовали процессы резервного копирования и восстановления базы данных и испытали их в боевых условиях более десяти раз.
Хочется верить, что подобного инцидента с базой данных больше не случится — но если всё же случится, мы будем готовы.