Создан командой Last9 — отправляйте телеметрию GPU в Last9 или в любой OTLP-бэкенд. Документация: Last9 docs.
DCGM exporter сообщит, что GPU перегревается. Но не скажет, чья задача его жарит.
Большинство инструментов наблюдаемости GPU останавливаются на уровне железа — утилизация, температура, ECC — и выдают gpu.uuid без ответа на единственный вопрос, который реально важен: кто платит за этот простаивающий H100?
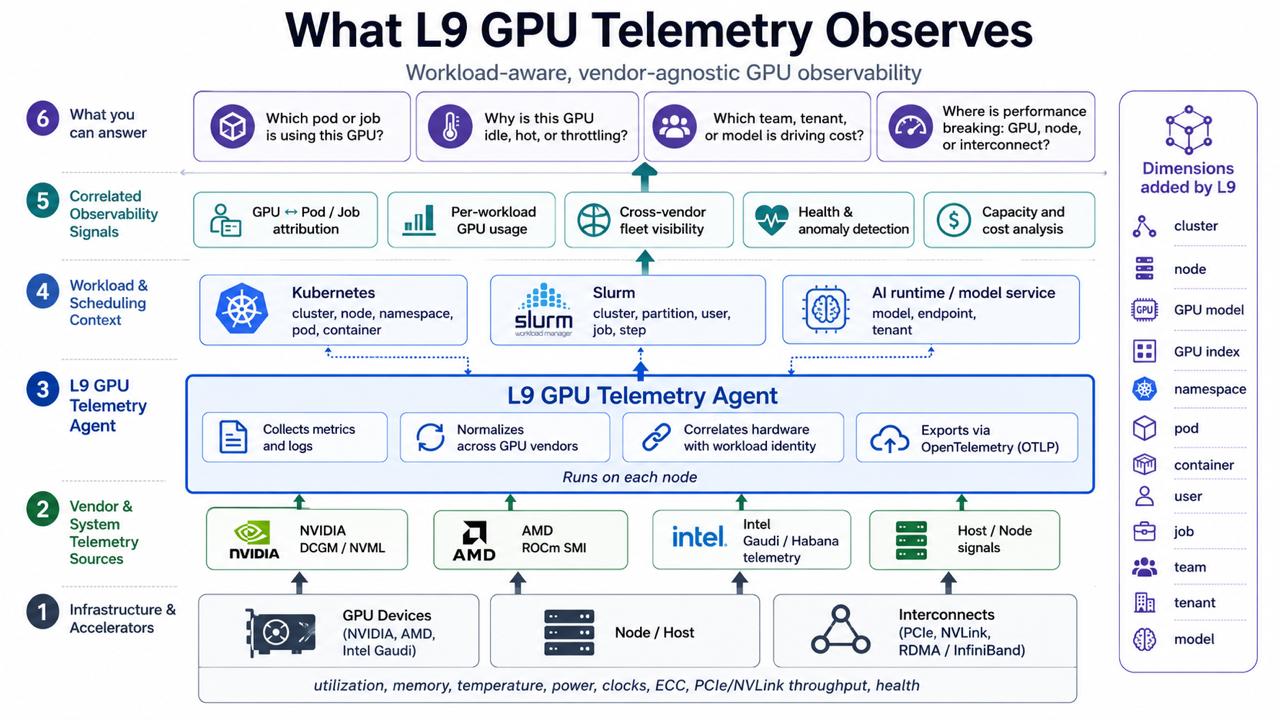
l9gpu закрывает этот пробел. Один агент на узел отправляет вендорно-нейтральный OTLP с привязкой к рабочей нагрузке (workload attribution) прямо из коробки — Kubernetes pod, namespace, deployment; Slurm job, user, partition. Настройте его на любой OTLP-бэкенд и получайте детализацию расходов по командам, заданиям и моделям — без построения дополнительного пайплайна.
Сегодня поддерживаются NVIDIA, AMD и Intel Gaudi. Завтра инструмент продолжит работать на любом новом железе, потому что он выдаёт OpenTelemetry, а не собственный формат. Никакого вендорного бэкенда в самом агенте нет — и это сделано намеренно.
Быстрый старт — Kubernetes
# Классический Helm-репозиторий
helm repo add l9gpu https://last9.github.io/gpu-telemetry
helm install l9gpu l9gpu/l9gpu -n monitoring --create-namespace \
  --set monitoring.sink=otel \
  --set monitoring.cluster=my-cluster \
  --set otlpSecretName=l9gpu-otlp

# или через OCI
helm install l9gpu oci://ghcr.io/last9/gpu-telemetry/l9gpu --version 0.2.1 -n monitoring
Сначала создайте секрет OTLP:
kubectl create secret generic l9gpu-otlp -n monitoring \
  --from-literal=OTEL_EXPORTER_OTLP_ENDPOINT=<your-otlp-endpoint> \
  --from-literal=OTEL_EXPORTER_OTLP_HEADERS="Authorization=Bearer <your-token>"
Для узлов AMD / Gaudi: --set collectors.nvidia=false --set collectors.amd=true
(или collectors.gaudi=true).
Полное руководство по Helm: docs/HELM.md. Примеры топологий (EKS + DCGM, multi-GPU, sidecar collector): deploy/helm/l9gpu/examples/.
Быстрый старт — Bare Metal / systemd
pip install l9gpu
export OTEL_EXPORTER_OTLP_ENDPOINT=<your-otlp-endpoint>
export OTEL_EXPORTER_OTLP_HEADERS="Authorization=Bearer <your-token>"

l9gpu nvml_monitor  --sink otel --cluster my-cluster  # NVIDIA
l9gpu amd_monitor   --sink otel --cluster my-cluster  # AMD
l9gpu gaudi_monitor --sink otel --cluster my-cluster  # Intel Gaudi
Быстрая проверка без OTLP: l9gpu nvml_monitor --sink stdout --once.
Юнит-файлы systemd: systemd/.
Чем l9gpu не является
-
Не Prometheus-экспортер. Он выдаёт OTLP. Prometheus scraping при необходимости берёт на себя ваш Collector.
-
Не бэкенд.
l9gpuэкспортирует стандартный OTLP в любую систему, которая его понимает. Никакой привязки к Last9 в самом агенте нет. -
Не замена DCGM. DCGM profiling (SM occupancy, tensor pipe, NVLink) дополняет
l9gpu— оба можно объединить в одном Collector-пайплайне. -
Не только NVIDIA. AMD MI300X / MI325X и Intel Gaudi 2/3 поддерживаются в полной мере.
Архитектура
Коллекторы на каждом узле нормализуют данные NVML / DCGM / amdsmi / hl-smi в пространство имён OTel gpu.* и отправляют OTLP в Collector. Тот обогащает метрики с помощью k8sprocessor или slurmprocessor и рассылает данные дальше.
Каждый цикл (по умолчанию 60 секунд) порождает метрики (один OTLP gauge на GPU на метрику) и логи (один OTLP log на GPU на цикл с полным снимком состояния — удобно для бэкендов, предпочитающих события в виде логов, или для воспроизведения истории).
Подробное описание: docs/ARCHITECTURE.md.
Привязка к рабочей нагрузке
Kubernetes — k8sprocessor обогащает каждую точку данных GPU атрибутами k8s.pod.name, k8s.namespace.name, k8s.deployment.name, k8s.job.name, cloud.availability_zone, cloud.region. Настройка, RBAC, разрешённые списки меток: docs/K8S_WORKLOAD_ATTRIBUTION.md.
Slurm — slurmprocessor прикрепляет slurm.job.id, slurm.user, slurm.account, partition, QoS:
processors:
  slurm:
    cache_duration: 60
    cache_filepath: /tmp/slurmprocessor_cache.json
    query_slurmctld: false
Полная конфигурация: slurmprocessor/README.md.
Дашборды и алерты
Готовые дашборды Grafana в dashboards/grafana/ — мультикластерный флит, нагрузка по pod’ам, работоспособность и надёжность (ECC, throttling, XID), DCGM profiling, движки инференса (vLLM, SGLang, TGI, Triton, NIM), эффективность флита и обнаружение простоев.
Правила алертов в alerts/prometheus/ — 17 готовых правил, сгруппированных в 3 PrometheusRule CRD (флит, GPU-инфраструктура, LLM-инференс) — и alerts/grafana/. Включаются через Helm: helm upgrade --set alerts.enabled=true ….
Готовый collector
Пропустите сборку через ocb и запустите готовый Collector с уже встроенными k8sprocessor и slurmprocessor:
docker run --rm -v $PWD/config.yaml:/etc/l9gpu/config.yaml:ro \
  ghcr.io/last9/l9gpu-collector:latest --config=/etc/l9gpu/config.yaml
Подробности и установка через бинарник / tarball: docs/COLLECTOR.md.
Компоненты
| Директория | Язык | Роль |
|---|---|---|
Python |
Коллектор на уровне узла (DaemonSet / systemd). Отправляет метрики и логи через OTLP. |
|
Go |
OTel Collector processor. Обогащает данные метаданными K8s pod / workload / cloud. |
|
Go |
OTel Collector processor. Обогащает данные метаданными Slurm job. |
|
Go |
Общая вспомогательная библиотека K8s API. |
|
Go |
Общая вспомогательная библиотека Slurm. |
Поддерживаемое железо
NVIDIA A100, H100 / H200, B200 / GB200, T4, A10, L4 (NVML + DCGM) · AMD MI300X, MI325X (amdsmi) · Intel Gaudi 2, Gaudi 3 (hl-smi).
Полный каталог метрик с единицами измерения и атрибутами: docs/METRICS.md.
Демо
Полный EKS-стек одной командой — vLLM + SGLang + TGI + Triton вместе с мониторами l9gpu NVML, DCGM, стоимости, работоспособности флита и отдельных движков инференса:
./deploy/demo/launch.shДокументация
-
Архитектура — дизайн системы, топологии, потоки данных
-
Справочник метрик — все метрики, единицы измерения, атрибуты
-
Руководство по интеграции — рецепты PromQL, OTel Collector, особенности облаков
-
Привязка рабочей нагрузки K8s — RBAC, обогащение, разрешённые списки меток
-
Масштабирование — управление кардинальностью для больших флитов
-
Наблюдаемость GPU и LLM — особенности vLLM / NIM / Triton
-
Кулинарная книга по тестированию на AWS — пошаговый разбор EC2 и EKS
Участие в разработке
Pull request’ы приветствуются. Инструкции по настройке окружения, тестированию и процессу PR — в CONTRIBUTING.md. Отправляя вклад, вы соглашаетесь с тем, что он лицензируется на тех же условиях, что и остальной проект. Сообщения о безопасности: SECURITY.md.
Благодарности и указание авторства
l9gpu (Python-пакет), shelper и slurmprocessor созданы на основе проекта Meta facebookresearch/gcm (MIT и Apache-2.0). Мы расширили их: добавили привязку к рабочей нагрузке Kubernetes, коллекторы AMD / Intel Gaudi, мониторы vLLM / SGLang / TGI / Triton / NIM, сигналы стоимости и работоспособности флита, а также нативный экспорт OTLP. k8shelper/ и k8sprocessor/ — оригинальная разработка Last9. Полная информация об авторстве: NOTICE.
Лицензия
MIT — для l9gpu, k8shelper, k8sprocessor. Apache-2.0 — для slurmprocessor, shelper. В каждой поддиректории есть собственный файл LICENSE, если он отличается от корневого.