Gameday-учения — один из самых эффективных способов заблаговременно выявлять слабые места в системах и процессах. В Datadog мы регулярно проводим самые разные gameday-сессии, намеренно нагружая платформы и наблюдая, как на них реагируют системы и команды в условиях, приближённых к боевым. Такие упражнения помогают обнаруживать скрытые уязвимости, повышать операционную готовность и неуклонно поднимать планку требований к инфраструктуре.
На одном из подобных учений симуляция зонального сбоя вызвала целенаправленные нарушения в зоне доступности (availability zone) промежуточной среды, введя сетевые задержки, — и это обнажило слабость нашей архитектуры PostgreSQL. В нескольких кластерах PostgreSQL на базе Kubernetes основные узлы (primary/writer) находились именно в пострадавшей зоне. Когда сетевая задержка резко выросла, эти мастера перестали надёжно общаться с репликами. Отставание репликации (replication lag) стремительно нарастало, записи зависали, а приложения начали отдавать устаревшие данные. Поскольку ни одна реплика не была достаточно актуальной, переключение при отказе (failover) было небезопасным — кластеры оказались в тупике.
Мы используем PostgreSQL как основную СУБД для многих продуктов Datadog, и эта архитектура хорошо служила нам в нормальных условиях. Но gameday выявил неприятную истину: при определённых сетевых сбоях наша схема отдавала предпочтение доступности в ущерб надёжности хранения данных (durability), оставляя нас без безопасного пути к восстановлению.
На практике это означало, что мастер продолжал принимать записи, даже когда репликация на реплики задерживалась из-за повышенной сетевой задержки. Система оставалась доступной для записи, но отставание репликации продолжало расти, и реплики всё дальше уходили от мастера. В итоге кандидаты на повышение (failover candidates) больше не могли быть безопасно продвинуты без риска потери данных. У нас оставался лишь один разумный выход: ждать, пока задержка спадёт и реплики наверстают упущенное.
Мы решили устранить этот сценарий отказа. Цель состояла в том, чтобы сделать failover одновременно автоматическим и безопасным, не жертвуя производительностью PostgreSQL сверх необходимого. Для этого мы переработали схему развёртывания PostgreSQL, перейдя на синхронную репликацию для кандидатов на failover под управлением Patroni — менеджера высокой доступности с открытым исходным кодом.
В этой статье мы расскажем, как переработали кластеры PostgreSQL на Kubernetes для безопасного failover, как искали баланс между надёжностью хранения и задержкой и что узнали в ходе проверки этого подхода через нагрузочное тестирование и испытание отказами.
PostgreSQL на Kubernetes: исходная архитектура
Наши кластеры PostgreSQL на Kubernetes организованы в два основных пула: пул лидера (leader pool) и пул read-реплик (read replica pool). В нашей архитектуре PostgreSQL работает в режиме единственного источника записи (single-writer), и такое разделение позволяет масштабировать операции чтения независимо, не перегружая лидера смешанным потоком чтения и записи. Благодаря этому мы можем наращивать ёмкость чтения по мере роста нагрузки, сохраняя задержку записи предсказуемой и стабильной.
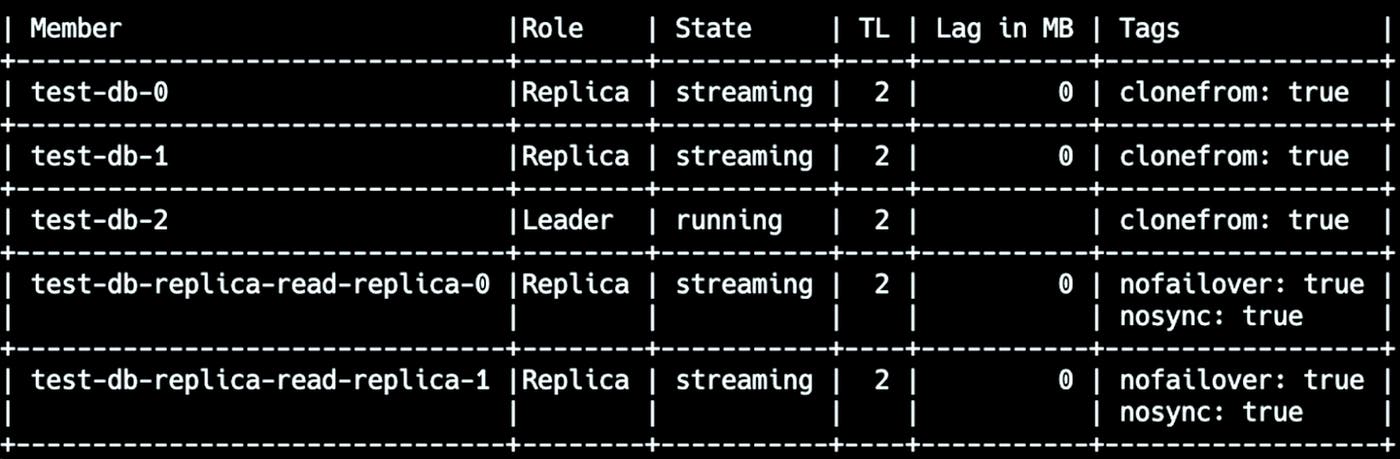
Пул лидера состоит из одного активного узла записи, который обрабатывает все операции записи, и двух резервных узлов (standby). Резервные узлы не обслуживают прикладной трафик, но могут быть продвинуты в лидеры при его недоступности.
Пул read-реплик включает несколько узлов, обрабатывающих трафик только на чтение. Эти реплики оптимизированы для масштабирования чтения и изоляции запросов, поэтому намеренно исключены из процесса failover.
Такая схема хорошо работала в штатных условиях, однако, как мы выяснили во время симуляции зонального сбоя, она жёстко ограничивала круг узлов, способных безопасно принять на себя роль лидера при его отказе.
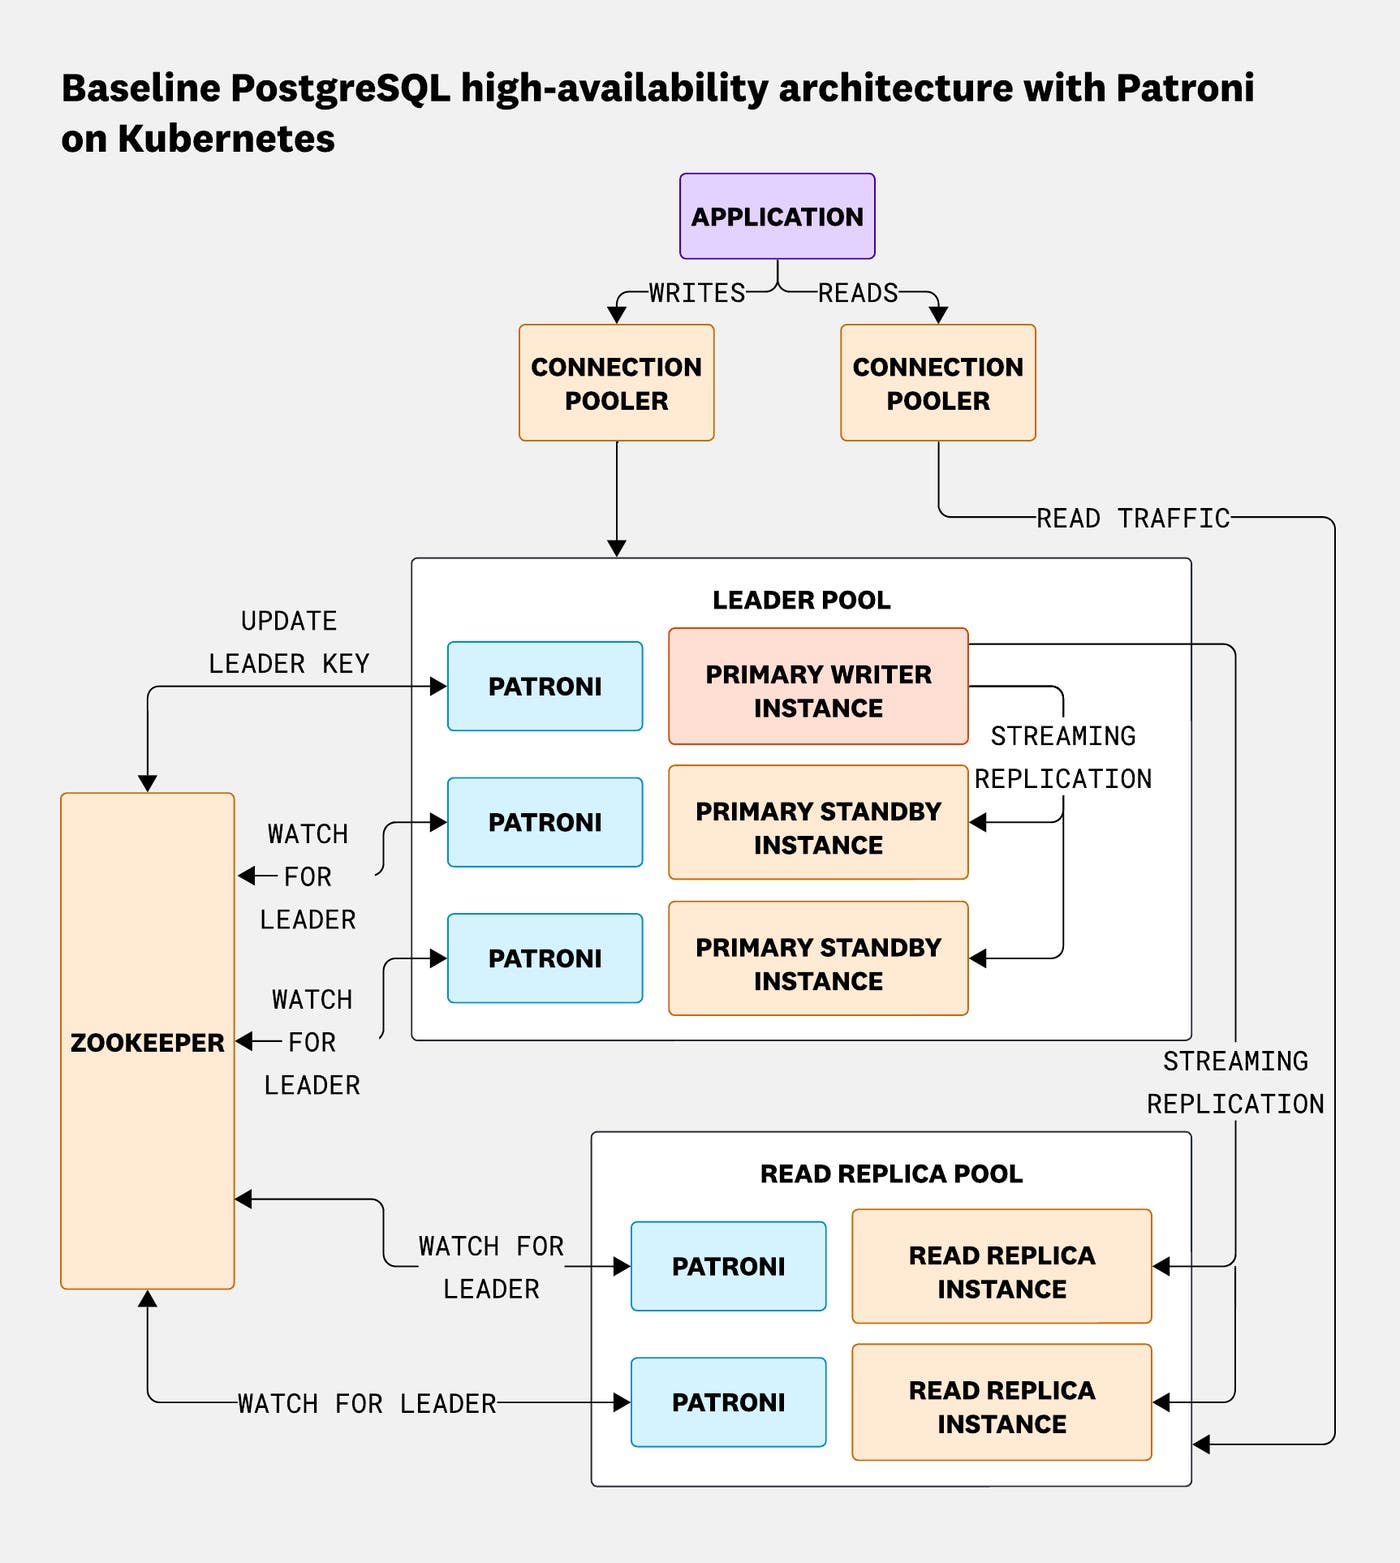
Для управления репликацией, failover и выборами лидера во всех кластерах PostgreSQL мы используем Patroni. Patroni опирается на распределённое хранилище конфигурации (distributed configuration store, DCS) — в нашем случае ZooKeeper — для координации выборов лидера, поддержания общей картины состояния кластера и гарантии наличия единственного активного лидера в любой момент времени.
ZooKeeper хранит метаданные: текущий ключ/замок лидера, конфигурацию кластера и состояние репликации каждого участника — в частности, последний номер журнальной последовательности (log sequence number, LSN). Patroni использует эти данные для осторожных решений о продвижении и понижении узлов, отдавая приоритет согласованности данных перед агрессивным failover.
Когда новый узел присоединяется к кластеру, он сначала проверяет ZooKeeper, чтобы определить, существует ли уже лидер. Если лидера нет, узел пытается получить ключ лидера, создав эфемерный znode. ZooKeeper гарантирует, что этот ключ может захватить только один узел, что исключает появление нескольких мастеров одновременно. Если лидер уже существует, присоединяющийся узел настраивается как реплика и запускает потоковую репликацию (streaming replication).
При сетевом разделении (network partition) эта осторожность особенно важна. Реплика, потерявшая связь с лидером или ZooKeeper, не может достоверно определить текущее состояние кластера. Вместо того чтобы рисковать небезопасным продвижением, Patroni приостанавливает или понижает затронутый узел до тех пор, пока лидерство не будет подтверждено.
Аналогично, если лидер теряет связность, Patroni координируется с ZooKeeper, чтобы гарантировать: замок лидера сможет захватить только один подходящий резервный узел. Этот процесс обеспечивает контролируемый failover даже при частичном сетевом сбое. На следующей диаграмме показано, как Patroni безопасно продвигает нового мастера во время сетевого разделения и как исходный лидер понижает себя, не сумев повторно захватить замок лидера после восстановления связи.
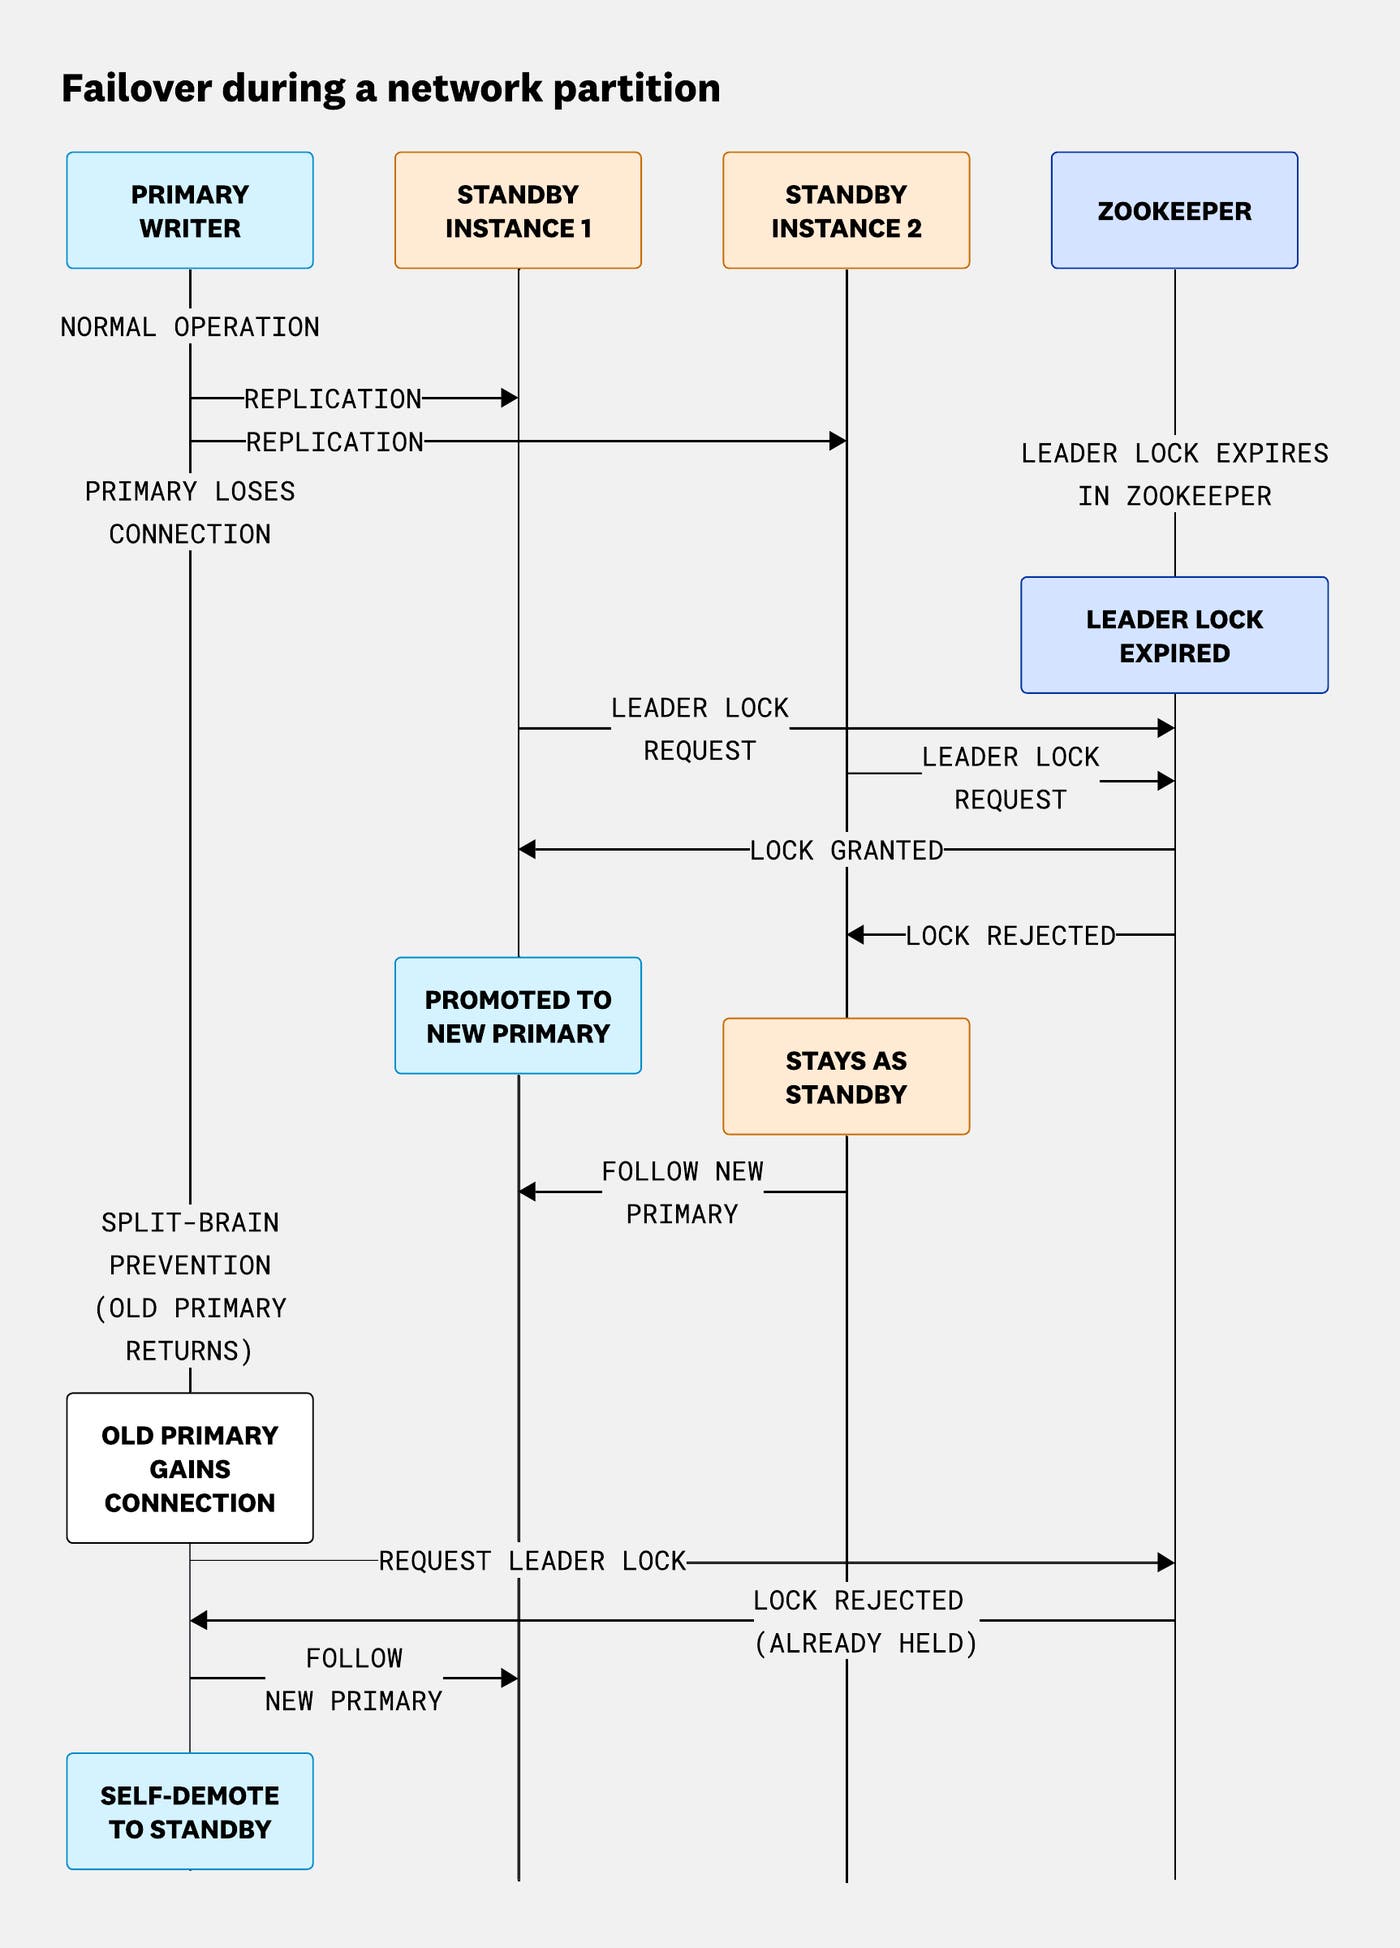
Почему наша архитектура не могла безопасно выполнить failover
Наша архитектура PostgreSQL использует модель единственного источника записи: только один узел-лидер принимает запросы на запись. При отказе Patroni отвечает за выбор нового лидера из числа здоровых резервных узлов.
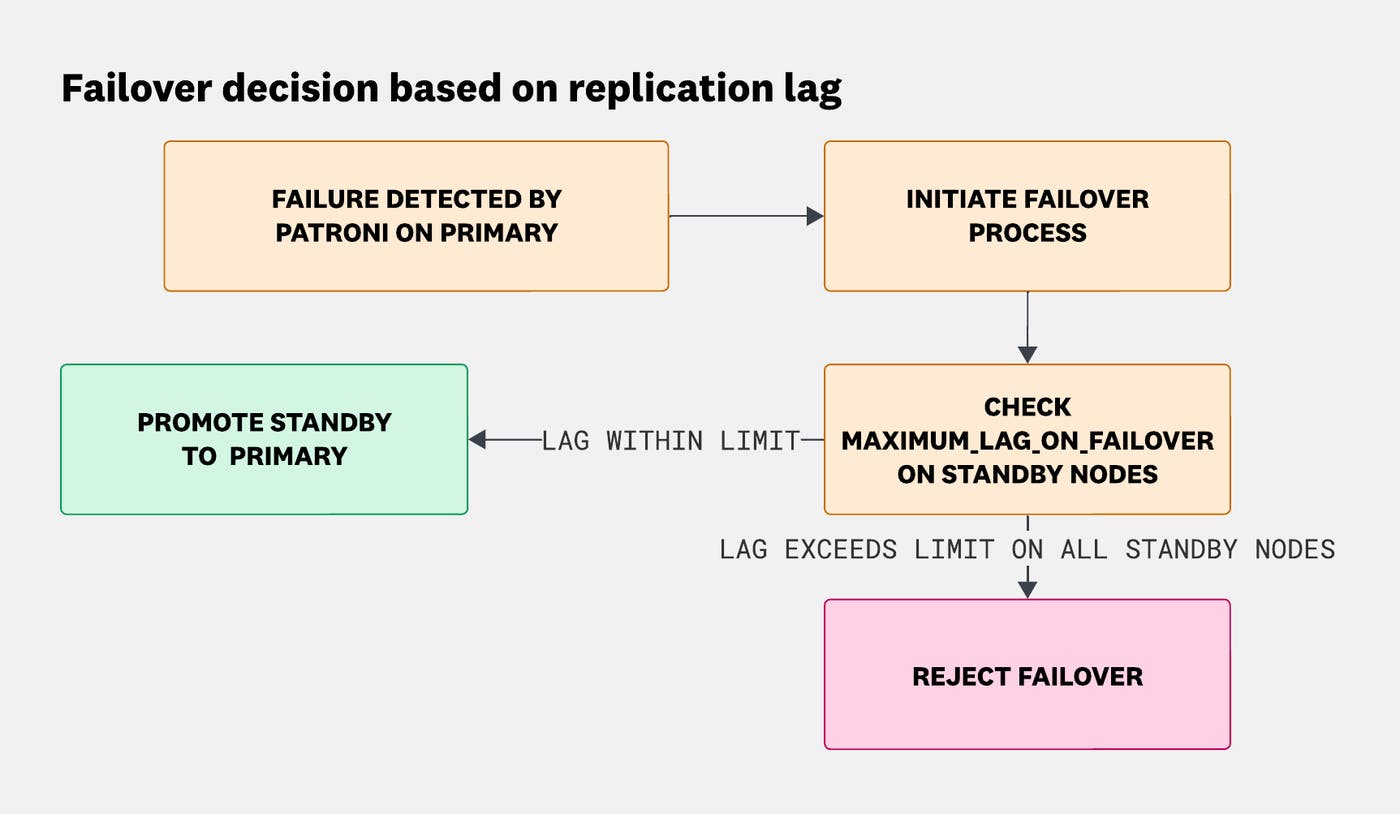
Чтобы защититься от потери данных, Patroni выполняет ряд проверок безопасности перед продвижением резервного узла. Одна из важнейших — проверка того, что отставание репликации (replication lag) не превышает допустимый порог, задаваемый параметром maximum_lag_on_failover. Если резервный узел отстал от лидера, его продвижение может привести к потере или несогласованности данных.
Именно этот защитный механизм стал ограничивающим фактором во время gameday. Когда мастер потерял связность, все доступные резервные узлы накопили отставание репликации сверх настроенного порога. Поскольку ни один резервный узел не был достаточно актуальным, Patroni правомерно отклонил попытку failover. Кластер остался без безопасного доступного мастера — не по вине Patroni, а потому что не было ни одного безопасного кандидата на продвижение.
На следующей диаграмме показано, как Patroni оценивает отставание репликации при failover и почему отклоняет продвижение, когда все резервные узлы превышают лимит maximum_lag_on_failover.
Чтобы повысить доступность наших кластеров PostgreSQL, мы пересмотрели стратегию репликации — в частности, два режима, поддерживаемых потоковой репликацией PostgreSQL.
При потоковой репликации лидер непрерывно передаёт репликам журналы предзаписи (write-ahead logs, WAL). Эти журналы фиксируют все изменения в базе данных. Реплики поддерживают синхронность, применяя WAL локально.
PostgreSQL поддерживает два режима потоковой репликации: асинхронная репликация (asynchronous replication) — режим по умолчанию — и синхронная репликация (synchronous replication).
Асинхронная репликация (режим по умолчанию)
В исходной конфигурации PostgreSQL использовал асинхронную репликацию. В этом режиме лидер не ждёт подтверждения от реплик перед фиксацией транзакции (commit).
Такая конфигурация минимизирует задержку записи и поддерживает высокопроизводительные рабочие нагрузки. Однако при отказе лидера транзакции, зафиксированные на мастере, но ещё не реплицированные на резервный узел, могут быть утеряны в ходе продвижения нового лидера.
Синхронная репликация
PostgreSQL также поддерживает синхронную репликацию. В этом режиме лидер ожидает подтверждения как минимум от одной реплики, прежде чем отправить клиенту ответ об успешной фиксации транзакции. Это существенно снижает риск того, что хотя бы одна реплика сильно отстанет от мастера, и обеспечивает более строгие гарантии надёжности хранения по сравнению с асинхронной репликацией: зафиксированные транзакции подтверждены на другом узле ещё до того, как клиент получит ответ об успехе.
При синхронной репликации кандидаты на failover с большей вероятностью окажутся актуальными, и резервный узел можно продвинуть без риска расхождения данных.
Гибридная схема репликации
Чтобы сбалансировать надёжность хранения, задержку и пропускную способность, мы внедрили гибридную модель репликации:
Резервные узлы в пуле лидера участвуют в синхронной репликации. Это позволяет лидеру ждать подтверждения от назначенных синхронных резервных узлов перед фиксацией записей. Read-реплики по-прежнему используют асинхронную репликацию. Они обслуживают трафик только на чтение и не рассматриваются как кандидаты на failover, что помогает ограничить накладные расходы на репликацию в пуле лидера.
Такой подход позволяет применять более строгие гарантии надёжности хранения к кандидатам на failover, не распространяя соответствующие издержки по задержке на read-реплики.
Настройка PostgreSQL и Patroni для безопасного failover
Включение синхронной репликации потребовало изменений как в PostgreSQL, так и в Patroni, который управляет выборами лидера и failover в наших кластерах.
В следующей таблице приведены параметры, которые мы настроили, указаны системы, управляющие ими, и заданные нами значения.
| Параметр | Описание | По умолчанию | Управляется | Обязателен/опционален | Установленное значение |
|---|---|---|---|---|---|
|
Включает синхронную репликацию в Patroni. При значении |
|
Patroni |
Обязателен |
|
|
Количество синхронных резервных узлов. Patroni использует это значение для формирования списка. |
|
Patroni |
Опционален |
|
|
Включает строгий синхронный режим. При значении |
|
Patroni |
Опционален |
|
|
Параметр PostgreSQL, определяющий надёжность фиксации. |
|
PostgreSQL |
Опционален |
|
После применения этих изменений узел-лидер отправляет клиенту ответ о фиксации транзакции только после того, как синхронный резервный узел подтвердил получение и применение данных.
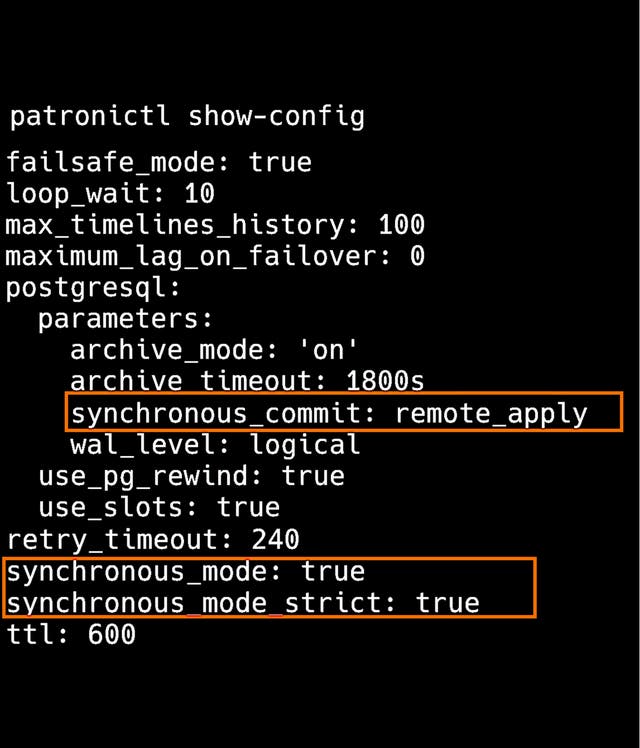
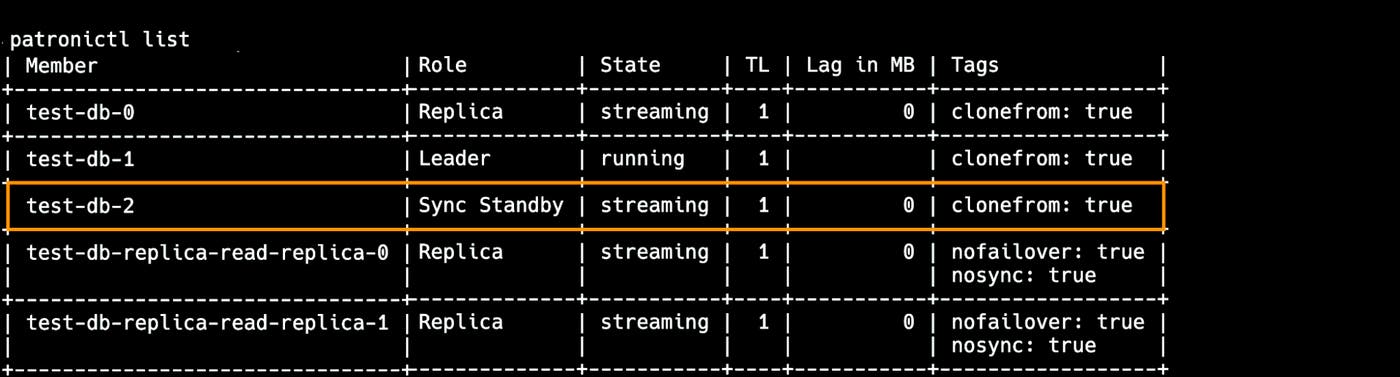
Баланс между надёжностью хранения и задержкой
Синхронная репликация улучшает надёжность хранения данных, но даётся ценой. Поскольку лидер ждёт подтверждения от синхронного резервного узла, прежде чем отправить ответ клиенту, задержка записи возрастает, а при устойчивой нагрузке может снизиться и пропускная способность записи.
Влияние на производительность определяется двумя основными факторами:
-
количеством синхронных резервных узлов —
synchronous_node_count; -
уровнем надёжности записи, настраиваемым через
synchronous_commit.
PostgreSQL предоставляет несколько уровней надёжности через параметр synchronous_commit, каждый из которых предполагает свои компромиссы между задержкой и риском.
| Значение | Что делает | Компромисс |
|---|---|---|
|
Лидер ждёт, пока реплика запишет, сбросит на диск и применит изменения WAL. |
Наибольшая согласованность, наибольшая задержка. |
|
Лидер ждёт, пока реплика сбросит WAL на диск. |
Высокая надёжность, но данные ещё не доступны для чтения на резервном узле. |
|
Лидер ждёт, пока WAL достигнет кэша ОС реплики (не диска). |
Меньшая задержка, но уязвимость при сбоях ОС. |
|
Лидер фиксирует после локального сброса на диск, не ожидая резервного узла. |
Нет гарантии надёжности хранения на другом узле. |
|
Лидер фиксирует до локального сброса WAL. |
Минимальная задержка, наибольший риск потери данных. |
Выбор подходящего варианта зависит от допустимого риска и требований к производительности. Чтобы принять обоснованное решение, мы провели нагрузочное тестирование каждого режима в нашей среде, измерив реальное влияние на задержку. Полученные результаты помогли нам сбалансировать гарантии надёжности хранения с эксплуатационными издержками и выбрать наиболее безопасную конфигурацию, удовлетворяющую нашим целевым показателям производительности.
Нагрузочное тестирование производительности синхронной репликации
Включение синхронной репликации добавляет задержку, поскольку каждая фиксация должна ждать подтверждения от одного или нескольких резервных узлов. Чтобы оценить это влияние в различных режимах synchronous_commit, мы провели нагрузочное тестирование с помощью pgbench — стандартного инструмента нагрузочного тестирования PostgreSQL. Версия Patroni, использованная в тестировании, — 3.2.1.
Мы применяли набор транзакций TPC-B, имитирующий смешанный поток простых транзакций чтения и записи. Для каждого теста измерялись два ключевых показателя:
-
Средняя задержка: среднее время обработки одной транзакции (в миллисекундах).
-
Транзакций в секунду (tps): количество завершённых транзакций в секунду без учёта времени на установку соединений.
Параметры тестирования
Для имитации условий, близких к боевым, мы варьировали:
-
Масштабный коэффициент (scale factor): увеличивался для оценки производительности при разных размерах базы данных.
-
Количество клиентов: варьировалось для имитации разного уровня параллельного трафика пользователей.
-
Количество потоков: подбиралось с учётом доступных CPU и степени параллелизма тестирования.
-
Количество транзакций: менялось для наблюдения за поведением при разной интенсивности нагрузки.
Примечание: В рамках данного тестирования синхронная репликация в режиме кворумной фиксации (quorum commit mode) не проверялась.
Что показало тестирование
По обоим показателям более строгие гарантии надёжности обходились снижением производительности.
Влияние на задержку записи
Процентный прирост средней задержки для разных режимов synchronous_commit:
-
53% для
remote_apply -
46% для
on -
38% для
remote_write -
32% для
local
Влияние на пропускную способность транзакций
Процентное снижение пропускной способности транзакций (tps):
-
34% для
remote_apply -
31% для
on -
27% для
remote_write -
23% для
local
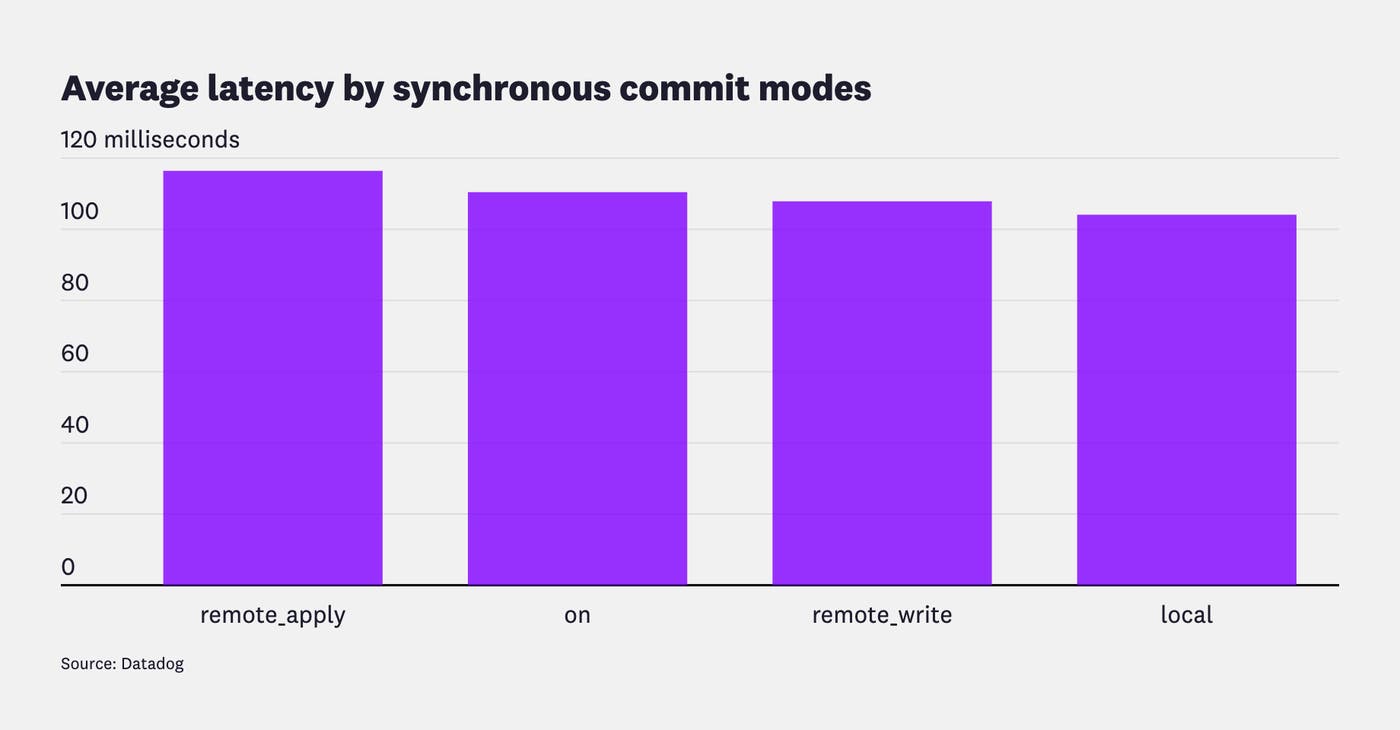
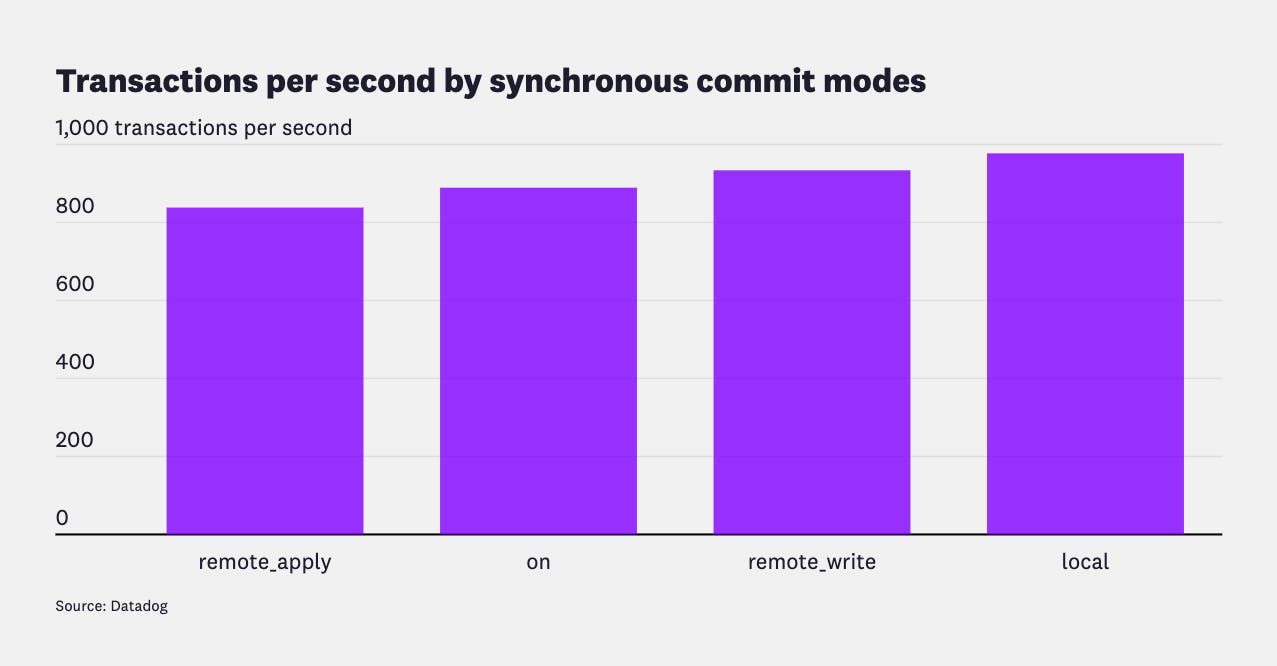
Результаты оправдали наши ожидания: более строгие гарантии надёжности сопровождаются ощутимым снижением производительности. Режим remote_apply, ожидающий воспроизведения и применения WAL репликами, неизменно демонстрировал наибольшую задержку и наименьшую пропускную способность. Вместе с тем именно этот режим обеспечивает наиболее строгие гарантии согласованности, что делает его подходящим для безопасного failover в нашей схеме.
После тестирования мы развернули remote_apply на нескольких кластерах с высокой интенсивностью записи. Несмотря на дополнительную координацию репликации, заметного влияния на задержку записи или пропускную способность на уровне приложений — даже при устойчивой боевой нагрузке — мы не обнаружили.
Чтобы снизить производственные риски, связанные с синхронной репликацией, мы внедряли её постепенно по дата-центрам и уровням нагрузки, с периодами «приработки» и непрерывным мониторингом между этапами. Например, высокопроизводительная рабочая нагрузка обработки ресурсов продолжила работу без наблюдаемых задержек обработки или накопления очередей после включения синхронной репликации, невзирая на рост задержки записи в базу данных. Кроме того, параметр synchronous_commit можно мгновенно скорректировать с помощью patronictl edit-config без простоя — это даёт нам возможность быстро снизить уровень надёжности фиксации для экстремально высокопроизводительных рабочих нагрузок при необходимости.
Проверка failover через сценарии отказов
Для проверки нашей конфигурации высокой доступности мы испытали поведение Patroni в различных сценариях отказов. Тесты были направлены на подтверждение того, что наша конфигурация с синхронной репликацией и строгими ограничениями failover способна защитить целостность данных, предотвратить «расщепление мозга» (split-brain) и автоматически восстанавливаться после непредвиденных сбоев.
Сценарий 1: Потеря синхронного резервного узла
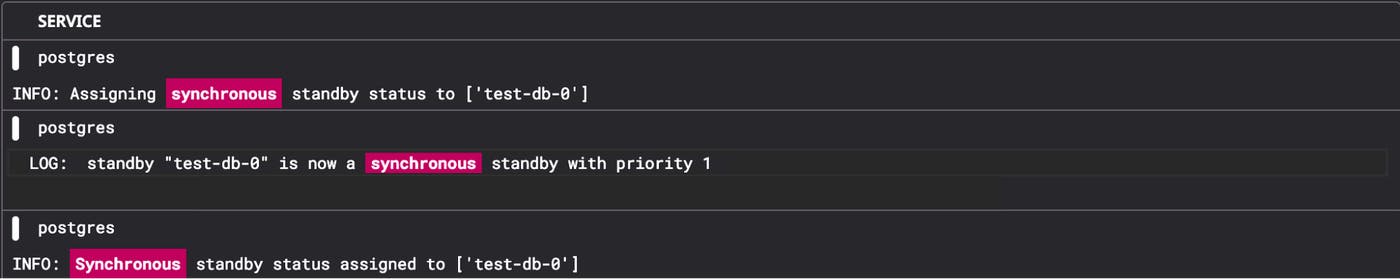
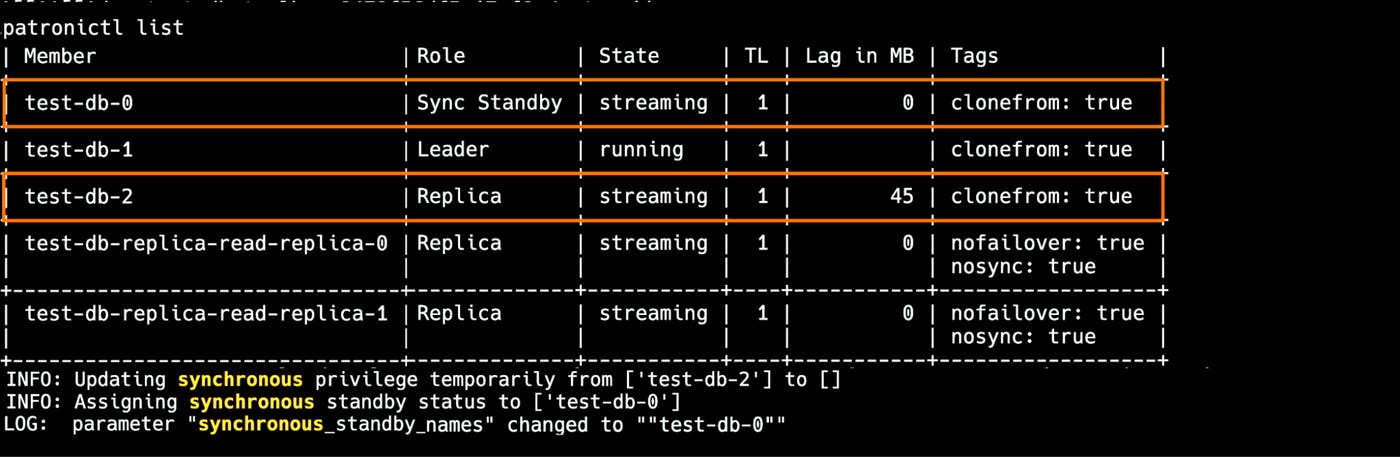
При отказе синхронного резервного узла Patroni пытается сохранить синхронную репликацию, назначив другой подходящий резервный узел.
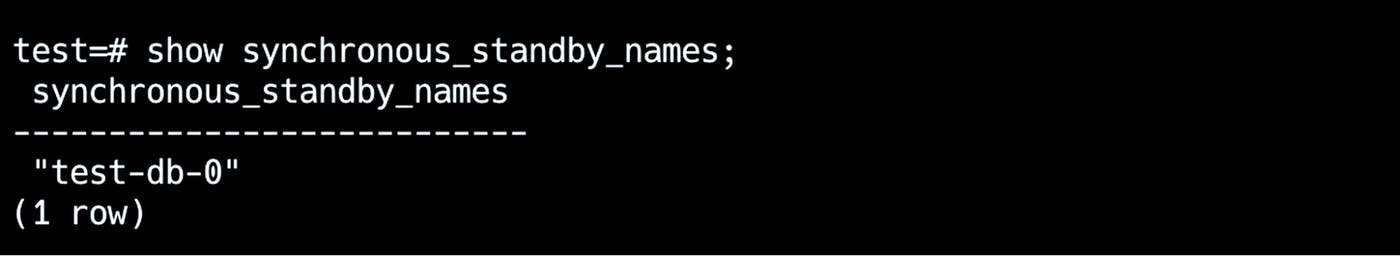
Процесс Patroni на узле-лидере отслеживает pg_stat_replication для обнаружения разорванных, зависших и отстающих потоковых соединений и опирается на ZooKeeper для отслеживания статуса участия реплик. При потере синхронного резервного узла Patroni пересчитывает список здоровых и подходящих потоковых реплик и обновляет synchronous_standby_names в PostgreSQL на основе synchronous_node_count. Это позволяет кластеру продолжать работу с включённой синхронной репликацией.
Сценарий 2: Потеря всех синхронных резервных узлов
Когда все узлы, участвующие в синхронной репликации, становятся недоступны, поведение Patroni определяется значением synchronous_mode_strict.
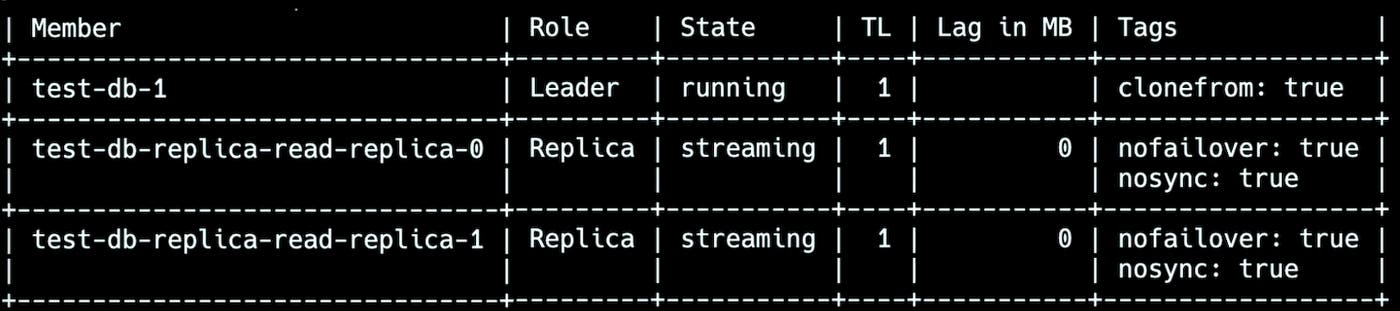
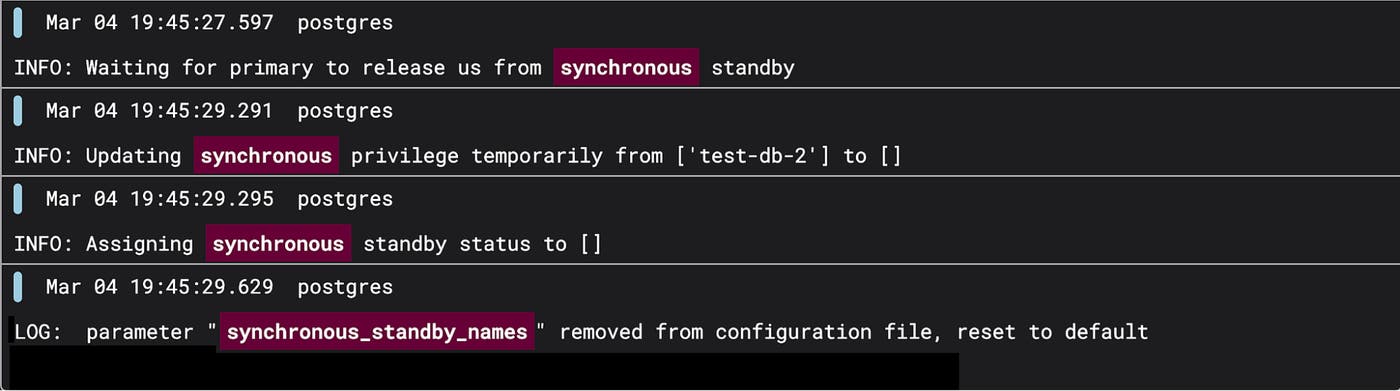
Нестрогий режим: приоритет доступности записи
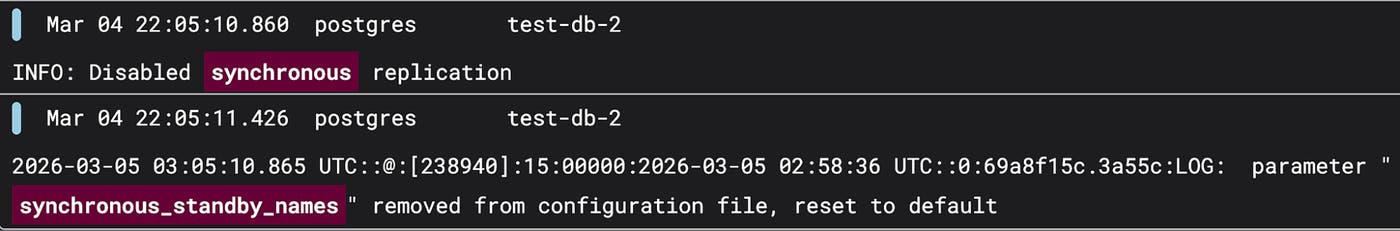
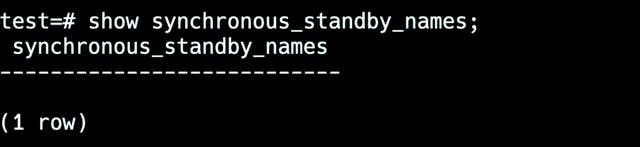
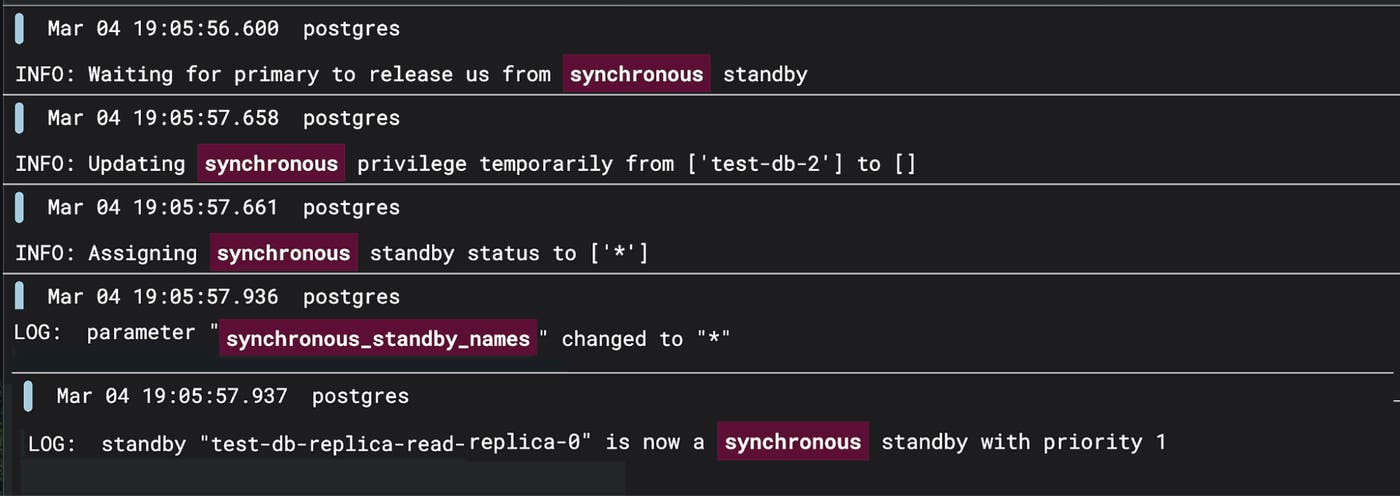
В нестрогом режиме Patroni временно отключает синхронную репликацию, очищая параметр synchronous_standby_names. Лидер переходит в асинхронный режим, позволяя записи продолжаться без гарантий синхронной репликации до тех пор, пока здоровая реплика не вернётся в строй.
Строгий режим: блокировка записи для сохранения безопасности
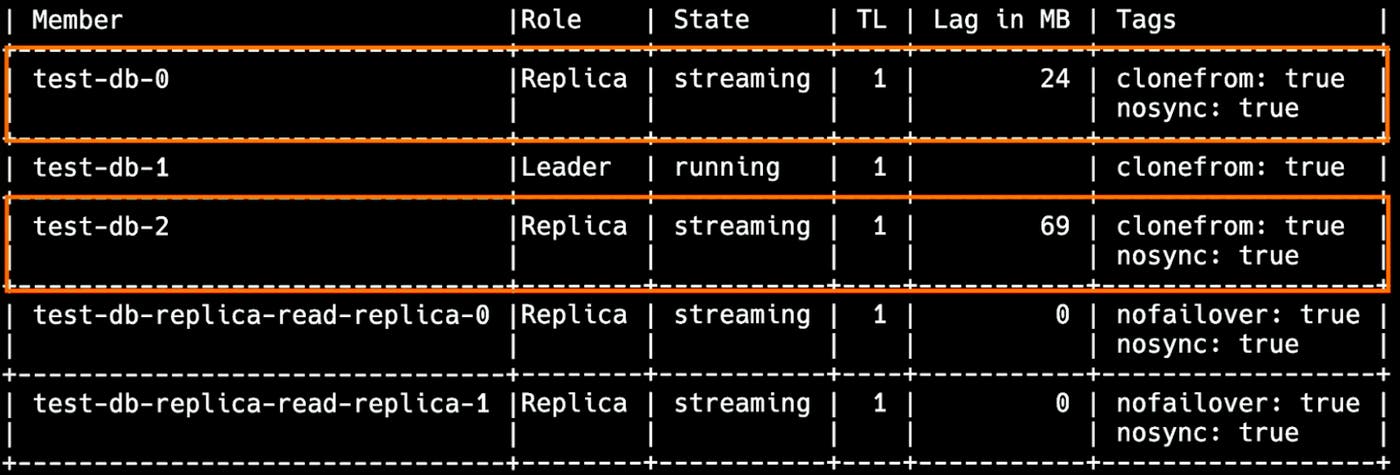
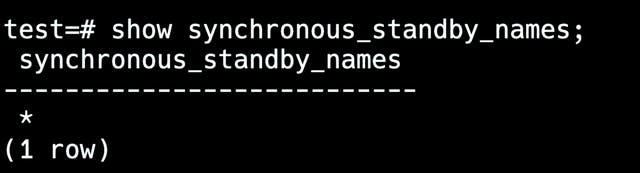
В строгом режиме Patroni устанавливает synchronous_standby_names в значение *. Это позволяет PostgreSQL продолжать принимать и локально фиксировать транзакции записи даже при отсутствии явно настроенных синхронных резервных узлов, однако ответы клиентам остаются заблокированы до тех пор, пока реплика не подтвердит получение WAL. Когда подходящая реплика, способная участвовать в синхронной репликации, возвращается в сеть, Patroni присваивает ей роль синхронного резервного узла.
Сценарий 3: Недоступность всех резервных и replica-узлов
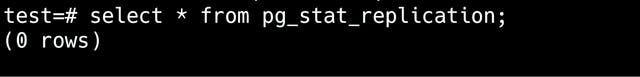
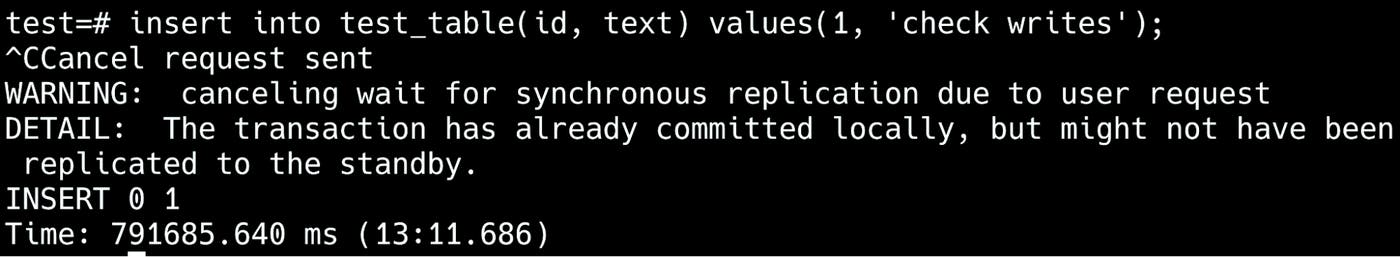
Если все узлы-реплики недоступны и задан synchronous_mode_strict = true, PostgreSQL приостанавливает подтверждения транзакций до тех пор, пока хотя бы одна подходящая реплика не вернётся в сеть. Такое поведение сохраняет согласованность данных, но приводит к временной недоступности записи на уровне приложений.
Сценарий 4: Отказ лидера в процессе синхронной фиксации
Этот граничный случай возникает, когда лидер ожидает подтверждения от синхронного резервного узла и прерывается до получения этого подтверждения.
Типичные причины:
-
Клиент отменяет транзакцию в процессе фиксации.
-
Аварийное завершение или принудительная остановка процесса PostgreSQL на лидере.
-
Сетевое разделение на фазе фиксации.
В таких случаях PostgreSQL может сбросить WAL локально, но не успеть реплицировать его на резервный узел. Поскольку подтверждение не было получено, транзакция остаётся невидимой для реплик. Если лидер падает до того, как WAL реплицирован на синхронный резервный узел, и failover продвигает этот резервный узел, транзакция может быть потеряна. В этот момент бывший лидер и только что продвинутый мастер могут иметь расходящиеся истории. Чтобы вернуться в кластер как резервный узел, бывший лидер использует pg_rewind: инструмент находит точку расхождения временны́х линий (timeline) и откатывает директорию данных бывшего лидера до состояния, соответствующего временно́й линии нового мастера, отбрасывая локальные изменения, которые так и не были реплицированы.
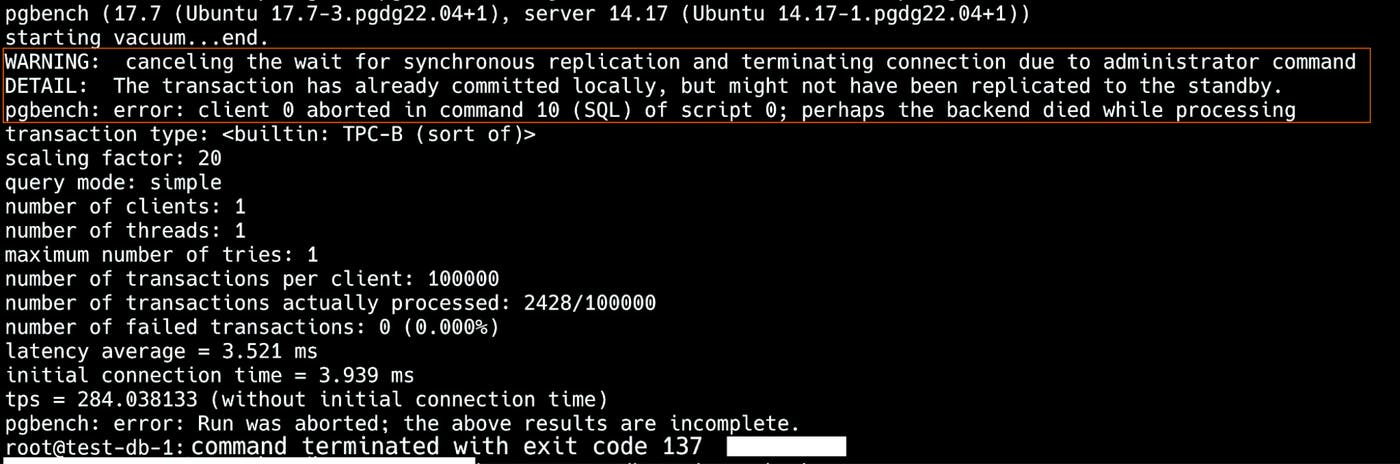
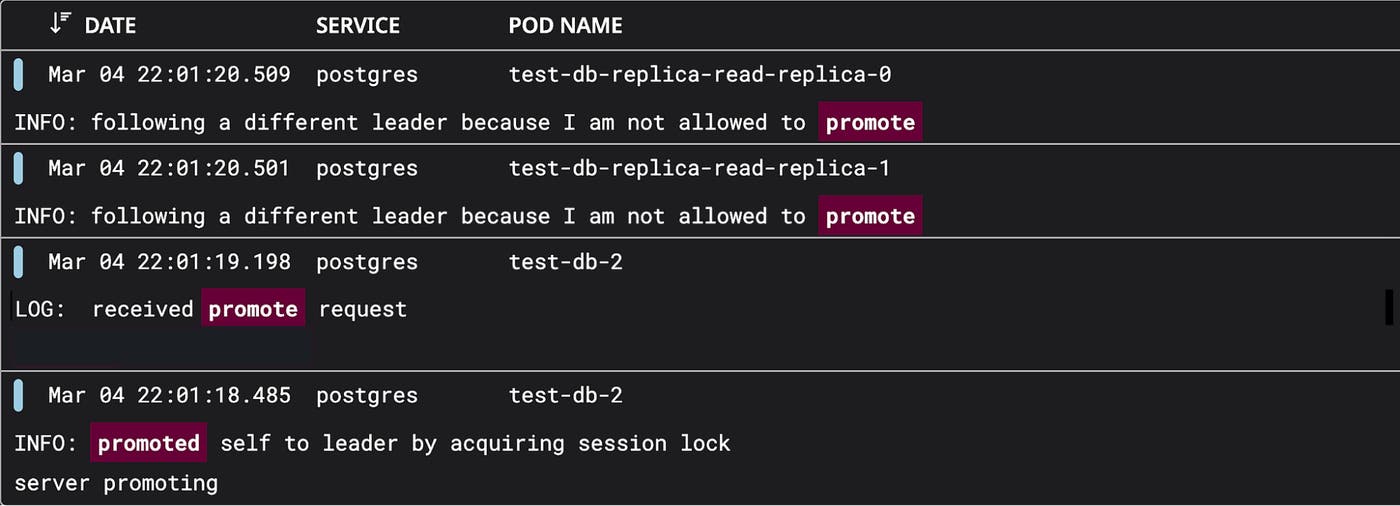
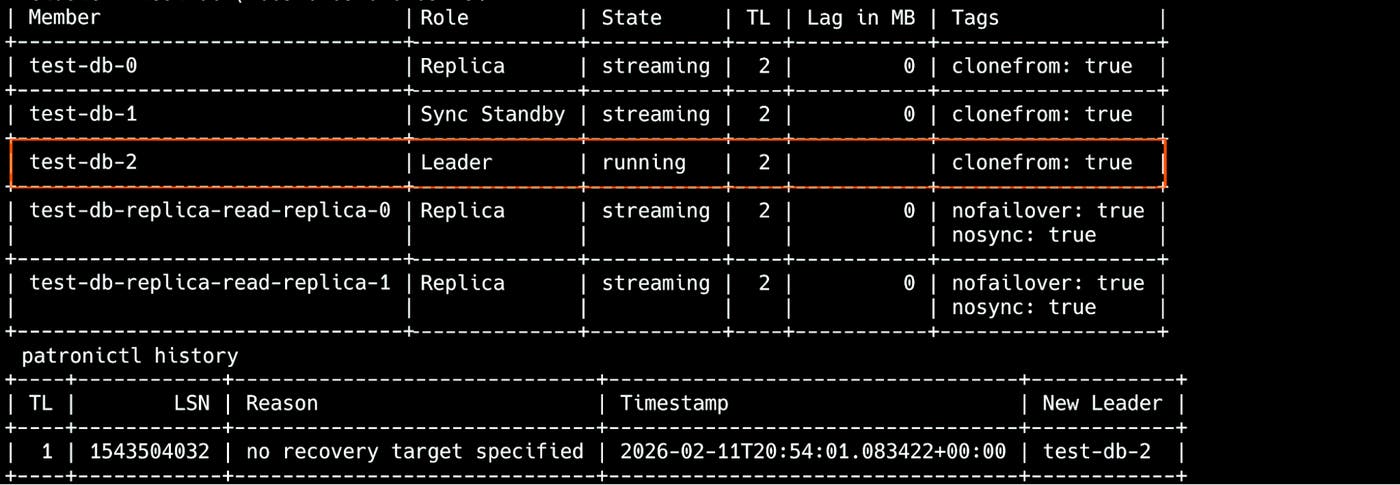
Patroni не управляет этим поведением на уровне транзакций — оно является следствием внутренней обработки синхронных фиксаций в PostgreSQL. Данный сценарий подчёркивает, почему настройки кворума и механизмы подтверждений требуют тщательной настройки и постоянного мониторинга.
Сценарий 5: Недоступность ZooKeeper
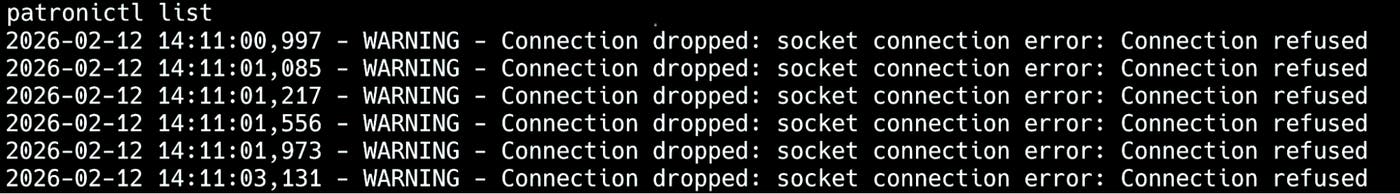
Patroni опирается на ZooKeeper для координации выборов лидера и поддержания состояния кластера. Когда ZooKeeper становится недоступным, Patroni больше не может верифицировать лидерство или инициировать новые выборы. Чтобы предотвратить несогласованность данных, он переходит к консервативному поведению.
Что происходит
Когда текущий лидер теряет связь с ZooKeeper, поведение Patroni зависит от того, включён или отключён режим аварийной защиты (failsafe mode). В обоих случаях кластер может перейти в режим только для чтения, однако триггер различается. При включённом failsafe-режиме лидер активно проверяет доступность всех участников кластера и понижает себя, если хотя бы один из них недоступен. При отключённом failsafe-режиме лидер продолжает принимать записи до тех пор, пока удерживает замок лидера. Как только замок перестаёт обновляться, Patroni понижает лидера и переводит кластер в режим только для чтения.
Когда failsafe-режим отключён
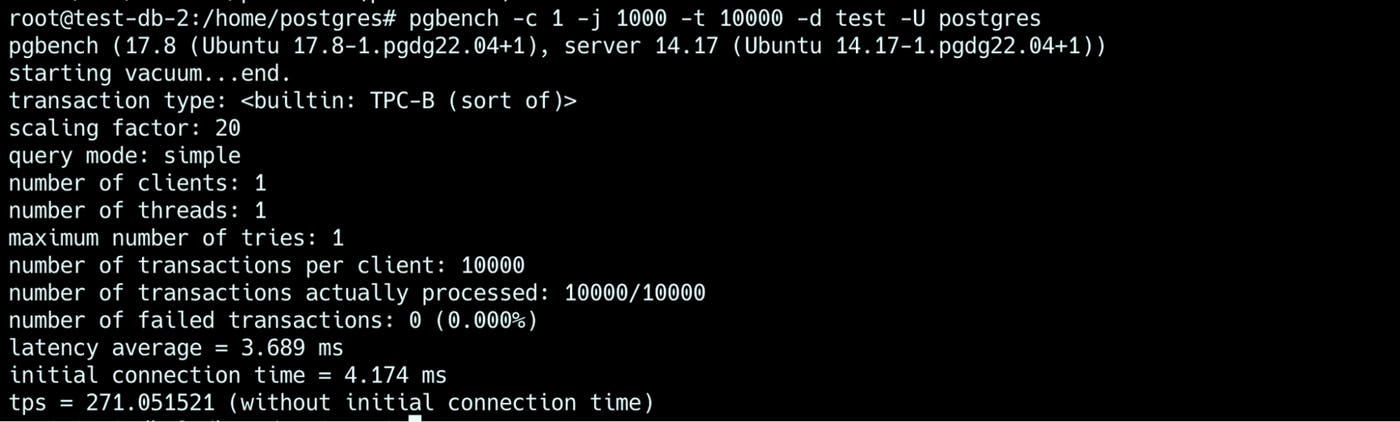
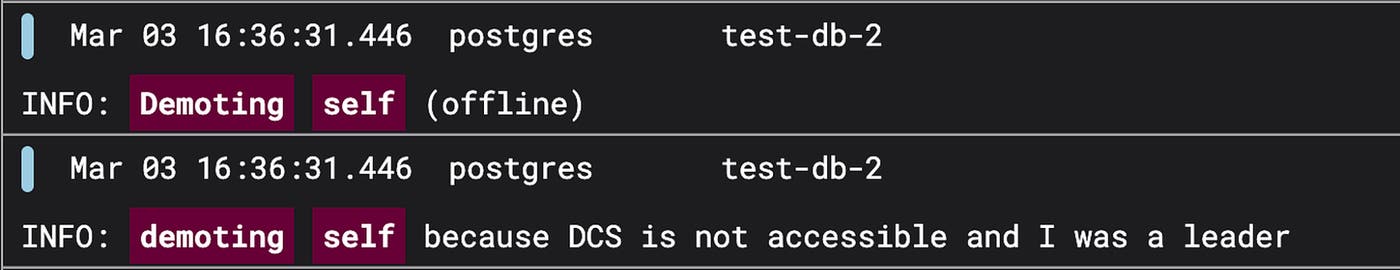
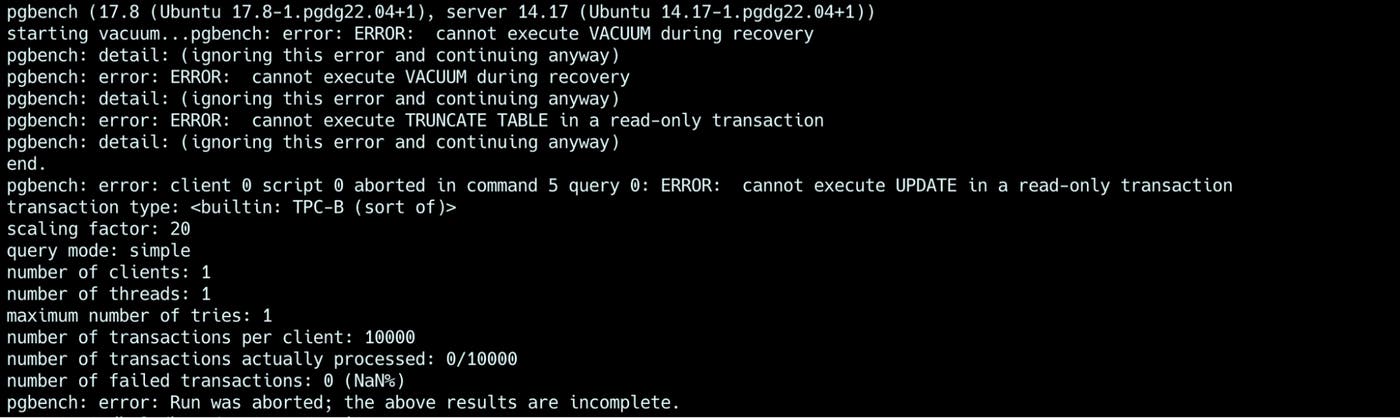
При отключённом failsafe-режиме и недоступном ZooKeeper запись может продолжаться, пока лидер доступен и все узлы здоровы. Это продолжается лишь до истечения TTL замка лидера. Как только цикл обновления ключа лидера завершается и замок не удаётся обновить, Patroni понижает лидера и переводит кластер в режим только для чтения.
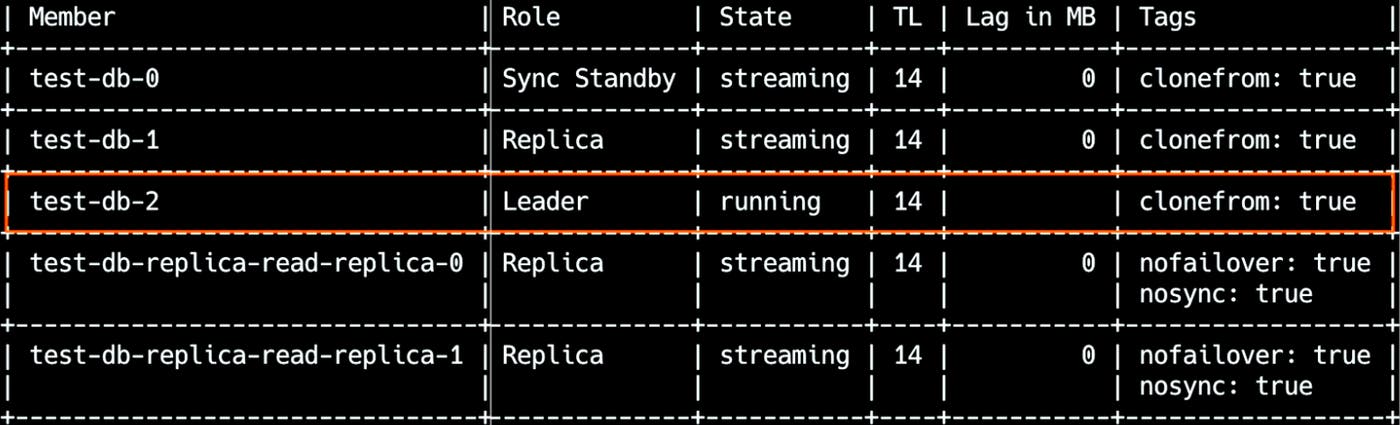
Когда failsafe-режим включён
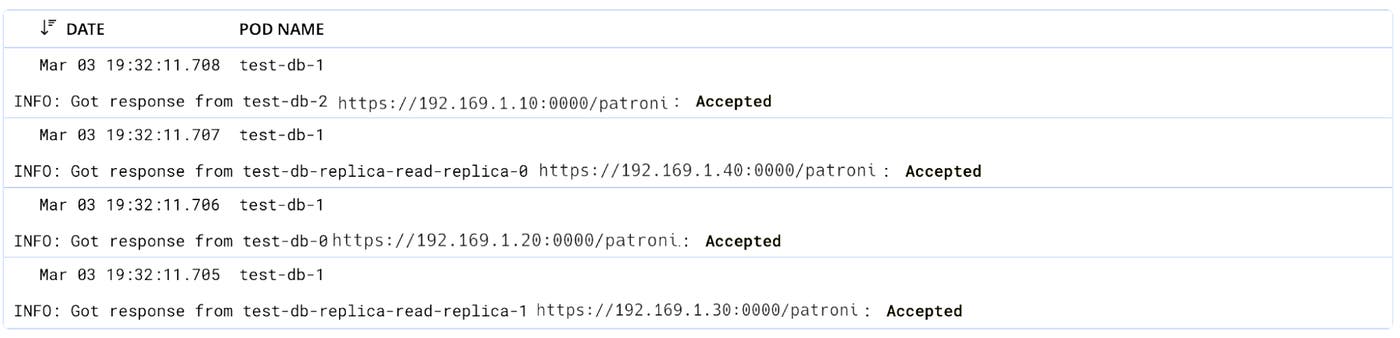
При включённом failsafe-режиме и потере лидером связи с ZooKeeper Patroni на узле-лидере непрерывно проверяет доступность всех участников кластера через REST API. Лидер продолжает принимать записи только в том случае, если каждый участник остаётся доступен; в противном случае Patroni переводит кластер в режим только для чтения.
Ручные failover и switchover при синхронной репликации
Помимо автоматических failover и switchover на основе проверок здоровья и координации через ZooKeeper, Patroni поддерживает ручные операции failover и switchover с помощью команд patronictl. При включённой синхронной репликации не все резервные узлы являются допустимыми кандидатами, и Patroni применяет защитные ограничения для сохранения целостности данных.
Переключение на асинхронный резервный узел
При включённой синхронной репликации асинхронные узлы не считаются безопасными кандидатами на failover, если переключение не форсируется принудительно.
| Команда | Поведение |
|---|---|
|
Завершается ошибкой, если выбранный узел асинхронный. |
|
Завершается ошибкой, если выбранный узел асинхронный. |
Примечание: Принудительный failover на асинхронный узел при включённой синхронной репликации обходит гарантии надёжности хранения и может привести к потере данных.
Переключение на синхронный резервный узел
Если целевой узел является здоровой синхронной репликой, Patroni разрешает операцию в штатном режиме.
| Команда | Поведение |
|---|---|
|
Выполняется успешно. Роль лидера передаётся синхронному резервному узлу. |
|
Выполняется успешно. Выполняется плановая передача управления между лидером и синхронным резервным. |
После проверки поведения различных режимов synchronous_commit и того, как защитные механизмы Patroni справляются с failover, мы включили синхронную репликацию на боевых кластерах с высокой интенсивностью записи, высокой интенсивностью чтения и смешанными нагрузками.
На этих кластерах мы не зафиксировали измеримого влияния на задержку или пропускную способность транзакций, что придало нам уверенности для распространения синхронной репликации на все наши кластеры.
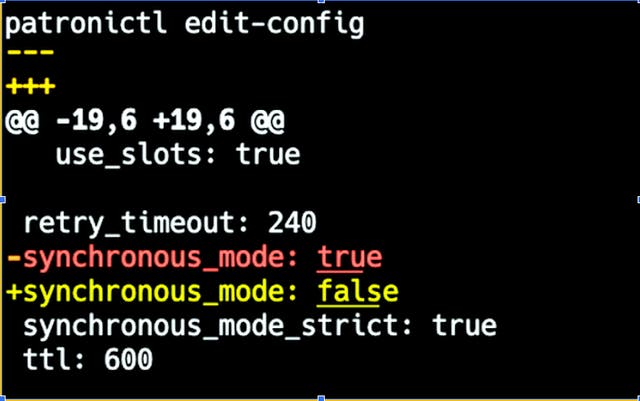
Patroni также позволяет легко отключить синхронную репликацию без простоя. Если отставание репликации или задержка при записи на диск становятся проблематичными, мы можем безопасно вернуться к асинхронной репликации, обновив конфигурацию и установив synchronous_mode: false.