Традиционная архитектура баз данных предполагает наличие одного-двух крупных кластеров на приложение — как правило, в сочетании с решением для пула соединений (connection pooling). Разработка с помощью ИИ и платформы «вайб-кодинга» (vibe coding) переворачивают эту модель с ног на голову: они подталкивают приложения к использованию множества небольших баз данных — по одной на пользователя, приложение, среду предпросмотра или арендатора.
Такая модель отлично вписывается в концепцию D1. D1 — это управляемая бессерверная (serverless) база данных Cloudflare на основе SQLite. Она позволяет создавать миллионы баз данных и платить только за реально потреблённые ресурсы.
Возникает закономерный вопрос: как масштабировать плоскость управления (control plane) для миллионов баз данных, не замедляя каждый запрос прогоном через централизованные узкие места?
Нам пришлось внести немало архитектурных изменений, чтобы D1 мог поддерживать платформы с миллионами созданных баз данных, из которых сотни тысяч активны в любой момент времени.
Эта статья — подробный взгляд изнутри на то, как устроена плоскость управления D1. Многие описанные здесь архитектурные паттерны доступны любому, кто строит решения на базе Developer Platform от Cloudflare. Кроме того, статья даёт представление о том, как мы сами проектируем собственные плоскости управления.
Рост в цифрах
Когда мы только начинали планировать эти изменения, использование D1 уже стабильно росло — но мы понимали, что нам понадобится поддержка значительно большего масштаба, как только крупные платформы начнут строить на D1.
Вот как это выглядит на сегодняшний день.
За последний год число активных (не удалённых) баз данных в D1 выросло в 15 раз, а за два года — в 65 раз (по состоянию на 8 октября 2026 года).
Также зафиксирован 18-кратный рост числа ежедневно активных баз данных за последний год (по состоянию на 8 октября 2026 года). База данных считается активной, если за день через неё был выполнен хотя бы один запрос.
Уже сформировавшиеся и успешные платформы активно используют D1, применяя те же инструменты, что доступны всем пользователям Cloudflare.
«ChatGPT Sites позволяет каждому превратить идею в готовый к публикации опыт. D1 даёт нашим пользователям простой и масштабируемый способ добавить в свои дашборды, игры и инструменты такие функции, как пользовательские метрики, таблицы лидеров и комментарии».
— Джон Абрамс (Jon Abrams), ChatGPT Sites @ OpenAI
Пока мы вносили изменения, описанные в этой статье, мы периодически проводили нагрузочное тестирование с целевыми показателями, заметно превышающими ожидаемый рост. Это помогало нам понять, куда направить усилия по оптимизации.
Руководящие инженерные принципы
Приложения, построенные на Developer Platform Cloudflare, охватывают самый широкий спектр: от полностековых (full-stack) приложений до сервисных API, от внутренних порталов для одного пользователя до массивных мультиарендных платформ вайб-кодинга.
При построении плоскости управления D1 для поддержки миллионов баз данных мы руководствовались следующими принципами — они будут полезны любому, кто строит свои плоскости управления и данных на нашей платформе.
-
Проектировать все процессы с учётом сбоев и идемпотентности. Сбои неизбежны, поэтому система должна по возможности самовосстанавливаться и продолжать работу.
-
Не допускать централизованных однорегиональных компонентов в горячем пути (hot path) операций плоскости данных (в нашем случае — всех запросов к базам данных).
-
Использовать Workers KV, глобально распределённое KV-хранилище, для хранения критически важных метаданных маршрутизации, чтобы промахи кэша лишь в редких случаях требовали обращения к центральным базам данных.
-
Использовать Hyperdrive для доступа к центральным базам данных Postgres с оптимизированным пулингом соединений и кэшированием, а там, где возможно, — реплики для чтения.
-
Периодически предварительно вычислять агрегаты в базе данных, чтобы избежать сканирующих запросов при обработке пользовательских запросов.
-
Применять согласованность в конечном счёте (eventual consistency) и очереди между компонентами, которым не нужна строгая согласованность, — это повышает надёжность и доступность.
-
Нагрузочно тестировать приложение с реалистичными рабочими нагрузками, выявлять узкие места и неэффективные участки и оптимизировать их в первую очередь.
Внутри мы следуем и другим инженерным принципам, но перечисленные достаточно универсальны и применимы к любому, кто строит решения на Cloudflare.
Следующие разделы подробно рассматривают основные компоненты системы и процессы плоскости управления D1, связанные с жизненным циклом базы данных D1, и показывают, как применять эти принципы на практике в реальной системе.
Высокоуровневая архитектура
Начнём с введения основных компонентов D1.
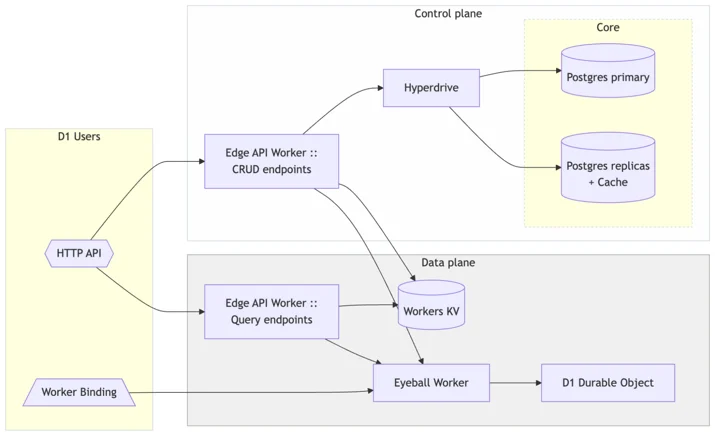
На диаграмме отсутствуют некоторые стрелки и блоки для второстепенных процессов, поддерживающих D1, но показаны именно те компоненты, которые обеспечивают публичный набор возможностей D1. Остальное мы рассмотрим в отдельных разделах далее.
Прежде всего, каждая база данных D1 поддерживается одним SQLite Durable Object, что делает создание миллионов таких объектов весьма простым делом.
Блок «HTTP API» представляет все наши API-поверхности: дашборд Cloudflare, Wrangler и Cloudflare CLI. Все API-запросы проходят через граничный шлюз (edge gateway) Cloudflare и обрабатываются воркером D1 Edge API Worker.
На диаграмме HTTP-эндпоинты, через которые пользователи выполняют SQL-запросы к своим базам данных, обозначены как «Query endpoints». Остальные эндпоинты включают стандартные операции с базами данных: создание, удаление и перечисление баз данных, а также функции импорта/экспорта и перемотки времени (time travel). Они показаны как «CRUD endpoints».
CRUD-эндпоинты используют Hyperdrive для запросов к кластеру Postgres в наших центральных дата-центрах (обозначаемых «Core»). Существуют две конфигурации. Одна с включённым кэшированием, ориентированная на реплики Postgres для чтения. Другая — с отключённым кэшированием, направляющая запросы к первичному (primary) узлу Postgres.
Edge API Worker может вызывать D1 Eyeball Worker в зависимости от типа запроса. Eyeball Worker — это наш прокси для всех запросов, которые должны обрабатываться лежащими в основе Durable Objects (DO). Это позволяет нам реализовать всю логику обработки запросов внутри Eyeball Worker: наблюдаемость (observability), автоматические повторные попытки, обработку ошибок и другие специфичные для запросов поведения.
Workers KV выступает нашим слоем кэширования на грани сети (edge) для активно читаемых метаданных и доступен всем воркерам D1.
Блок «Worker Binding» представляет все пользовательские воркеры с D1 Worker binding. Запросы от D1 Binding поступают напрямую в D1 Eyeball Worker, который в свою очередь перенаправляет запрос в Durable Object, поддерживающий базу данных, и проксирует ответ обратно в пользовательский воркер.
У пользователей есть два способа выполнять запросы к своим базам данных. Первый — через эндпоинты HTTP API, второй — через развёрнутый в их аккаунте воркер с привязкой D1 Binding.
С точки зрения операций мы делим каждую из них на одну из следующих категорий:
Плоскость данных (Data plane): любые запросы, связанные с обращением к базе данных; должны выполняться как можно быстрее и всегда на грани сети. Плоскость управления (Control plane): любые HTTP API-операции или внутренние потоки, запускаемые в ответ на не-запросный пользовательский запрос; могут зависеть от центральных однорегиональных компонентов. Фоновая асинхронная плоскость (Background asynchronous plane): любые аналитические и биллинговые рабочие процессы; могут быть согласованными в конечном счёте и выполняться где угодно.
Под капотом скрывается ещё немало всего — давайте погрузимся в ключевые потоки.
Быстрое создание баз данных по требованию рядом с пользователем
Мультиарендные платформы и разработка с участием ИИ-агентов требуют создания большого числа экземпляров баз данных — быстро, экономично и надёжно.
Вот пример команды Wrangler для создания базы данных D1:
% time wrangler d1 create "demo-01"
✅ Successfully created DB 'demo-01' in region WEUR
...
0.56s user 0.13s system 42% cpu 1.614 total
Когда пользователь создаёт базу данных D1, прежде чем она будет готова принимать запросы, происходит несколько вещей.
-
Проверяется, может ли аккаунт создать ещё одну базу данных с учётом лимита бесплатного тарифа или персональных ограничений аккаунта.
-
Генерируется уникальный UUID базы данных D1, уникальный идентификатор Durable Object (
newUniqueId()), и выполняется инициализация лежащего в основе Durable Object с информацией об аккаунте и базе данных. -
Информация о вновь созданной базе данных сохраняется в Postgres (одна строка на базу данных, включая метаданные и сопоставление с инициализированным идентификатором Durable Object).
-
В Workers KV записывается сопоставление идентификатора базы данных с идентификатором Durable Object (в дальнейшем используется плоскостью данных и эндпоинтами запросов).
Рассмотрим реальный поток и то, как мы восстанавливаемся после сбоев на каждом шаге.
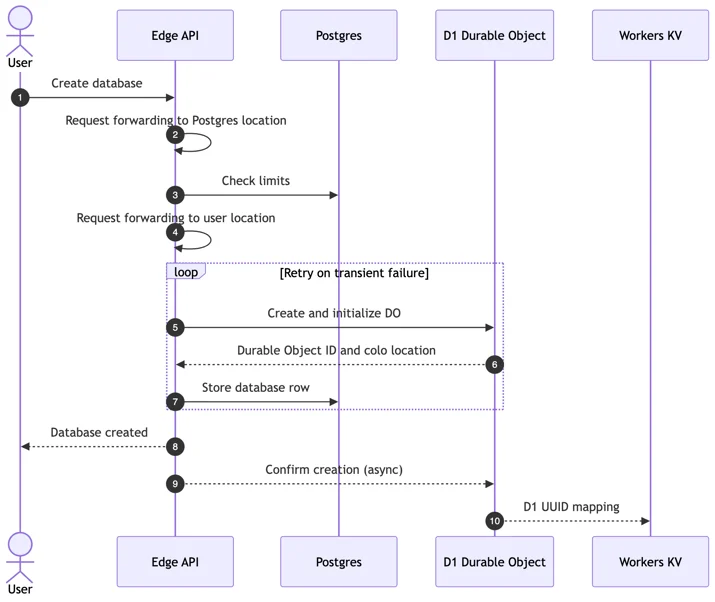
Как только поступает запрос на создание базы данных, наш обработчик Edge API Worker запускается в ближайшей к пользователю точке присутствия Cloudflare на грани сети. Edge API опрашивает реплики Postgres через Hyperdrive с включённым кэшированием (TTL кэша — несколько секунд), чтобы получить количество не удалённых баз данных для данного аккаунта.
Edge API Worker перенаправляет запросы плоскости управления в дата-центры, расположенные вблизи нашего кластера Postgres, для эндпоинтов, совершающих несколько обращений к Postgres (шаг 2), и эндпоинт создания базы данных — один из них. Причина проста: один обход сети издалека может занять сотни миллисекунд, тогда как при близком расположении к Postgres это займёт несколько миллисекунд. Для эндпоинтов, делающих не более одного запроса к Postgres, эта оптимизация не нужна, поскольку Hyperdrive уже обеспечивает эффективную маршрутизацию через сеть Cloudflare.
Создание базы данных D1 без дополнительных параметров по умолчанию размещает её вблизи географического положения запроса. Вы можете повлиять на расположение базы данных, указав явную подсказку о расположении или юрисдикцию. Параметры подсказок о расположении и юрисдикции идентичны тем, что поддерживают Durable Objects, поэтому при их указании они просто передаются напрямую при инициализации лежащего в основе Durable Object.
При создании по умолчанию мы хотим, чтобы базы данных D1 размещались вблизи исходного местоположения запроса, рядом с пользователем. Для этого на шаге 4 диаграммы мы внутренне перенаправляем выполнение запроса в дата-центр, близкий к исходному местоположению запроса, и оттуда вызываем лежащий в основе Durable Object. Это гарантирует, что Durable Object будет размещён рядом с пользователем.
Аналогичные техники маршрутизации можно реализовать, используя явные подсказки о размещении воркеров и во время выполнения вызывая нужный воркер через Service Bindings.
Эндпоинт создания — несколько нетипичный случай с точки зрения размещения: хотя мы обращаемся к Postgres как минимум дважды, мы также делаем дальний вызов к лежащим в основе Durable Objects, которые различаются для каждого запроса. Поэтому выполнение запроса в любой точке мира могло бы оказаться неэффективным. Именно поэтому мы склонились к тому, чтобы перенаправлять первоначальный запрос ближе к Postgres.
Следующий шаг — сгенерировать UUID базы данных вместе с новым уникальным идентификатором Durable Object, используя API newUniqueId(), и вызвать RPC-функцию init(options) на новом стабе (stub) Durable Object. Durable Object сохраняет информацию в своём долговременном хранилище, чтобы каждый последующий входящий запрос с этого момента имел все метаданные для связанной базы данных.
Получив ответ об инициализации, Edge API Worker сохраняет метаданные базы данных в наш центральный первичный узел Postgres через Hyperdrive — по одной строке метаданных на базу данных.
Описанные шаги заключены в цикл с повторными попытками (шаги 5–7 на диаграмме). При сбое инициализации DO или записи в Postgres мы повторяем попытку с другими идентификаторами (это важно, как мы увидим в следующем разделе).
Запись в Postgres является «контрольной точкой создания»: с этого момента база данных считается созданной, даже если финальный ответ не дойдёт до пользователя. С этой точки база данных включается во все операции плоскости управления и может быть привязана к воркеру для обслуживания запросов.
На этом база данных D1 готова принимать запросы.
Финальный RPC-вызов подтверждения создания к Durable Object происходит в waitUntil() и может завершиться неудачей без последствий. Этот вызов сигнализирует DO о том, что база данных теперь активна, и DO обновляет Workers KV метаданными базы данных, чтобы любой последующий запрос мог немедленно прочитать информацию из кэша Workers KV без необходимости обращаться к Postgres.
Часто спрашивают: почему нельзя выполнить весь поток создания внутри транзакции Postgres, чтобы упростить процесс? Ответ прост: это не масштабируется, поскольку соединения будут удерживаться на время инициализации Durable Object, который может находиться на другом конце света.
Пульс как механизм самовосстановления баз данных
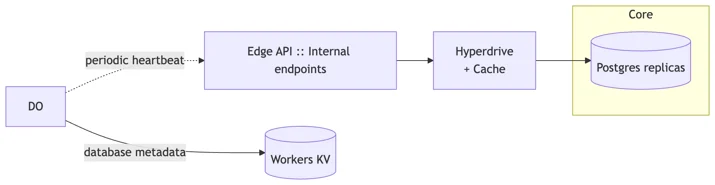
Каждый Durable Object D1 периодически отправляет пульс (heartbeat) плоскости управления, чтобы получить актуальное состояние базы данных (активна или удалена) и лимиты аккаунта (подробнее об этом в разделах о применении ограничений). Интервал составляет 30 секунд с дополнительным джиттером для каждой базы данных. Мы также имеем возможность изменять интервал по базе данных или аккаунту, а также полностью отключать пульс.
Пульс допускает незначительно устаревшие данные, то есть может обслуживаться несколькими слоями кэширования Hyperdrive или репликой Postgres для чтения. Этот механизм позволяет Durable Object самостоятельно корректировать своё состояние в соответствии с источником истины (Postgres) относительно создания и удаления баз данных.
Небольшое уточнение перед тем, как двигаться дальше. Причина, по которой мы используем разные UUID базы данных и идентификаторы Durable Object при каждой повторной попытке в потоке создания (шаг 5), заключается в следующем: если бы мы повторно использовали UUID базы данных с новыми идентификаторами Durable Object, несколько Durable Objects считали бы себя владельцами одной и той же базы данных, что привело бы к трудноотлаживаемым ситуациям. Периодический пульс также выполняет роль механизма очистки осиротевших объектов.
Важно также, что мы сначала инициализируем Durable Object, а уже затем сохраняем сопоставление базы данных в Postgres, — иначе запросы могли бы начать поступать к Durable Object и отклоняться из-за неинициализированного состояния.
Рассмотрим пример сценария сбоя и то, почему система самовосстанавливается:
-
Мы выполнили всё из предыдущего раздела вплоть до инициализации Durable Object A, а затем запись в Postgres завершилась неудачей.
-
Воркер повторяет цикл и инициализирует новый DO с другим идентификатором B, на этот раз успешно сохраняя запись в Postgres.
-
Теперь у нас два инициализированных и работающих Durable Object в рамках этого запроса, но только один из них валиден.
-
Пользователь может обращаться только к Durable Object B, поскольку только его идентификатор есть в Postgres — нашем источнике истины.
-
В течение 30 секунд DO A отправляет свой следующий пульс плоскости управления и получает ответ, что его база данных не существует. Это запустит процесс самоудаления DO A.
Аналогичный поток происходит для эндпоинта удаления.
Ещё одно самовосстанавливающееся поведение пульса — обеспечение того, чтобы данные в Workers KV в конечном счёте отражали реальность: активна база данных или удалена.
Финальный шаг потока создания по обновлению Workers KV выполняется по принципу «по возможности» и может завершиться неудачей без последствий. Это согласованность в конечном счёте: в следующий раз, когда Durable Object отправит пульс, он убедится, что элемент в Workers KV записан с правильным значением. Поскольку Workers KV является согласованным в конечном счёте без возможности выполнить согласованное чтение, Durable Object выступает точкой сериализации для записей в элементы Workers KV.
Удаление работает зеркально: Durable Object владеет записью своего состояния «удалён» в Workers KV — по принципу «по возможности» в ходе самой операции удаления, а если это не удалось, пульс исправит ситуацию в конечном счёте. Durable Object также хранит активное или удалённое состояние в своём хранилище, поэтому может немедленно отклонять или принимать запросы, даже если Workers KV устарел и пропускает запросы.
В целом пульсация баз данных — это резервный механизм приведения системы в согласованное состояние, когда операции должны записывать данные во внешнее хранилище и одновременно обновлять сам Durable Object.
Вывод горячего пути за скобки: запросы без обращений к центральной базе данных
Ключевой принцип для эндпоинтов запросов — избегать обращений к Postgres или любому другому централизованному однорегиональному компоненту. Каждый запрос через HTTP запускает наш Edge API Worker вблизи исходного местоположения пользователя, а затем напрямую обращается к Durable Object D1 через Eyeball Worker.
Edge API Worker отвечает за стандартную аутентификацию HTTP API, авторизацию на основе ресурсов, ограничение запросов (rate limiting) на уровне аккаунта и базы данных, валидацию запросов, проверку прав доступа (entitlements) аккаунта и другие API-специфичные функции перед выполнением основной бизнес-логики.
Eyeball Worker, в свою очередь, пропускает эти дополнительные проверки (за исключением собственного rate limiting), поскольку под капотом привязка D1 Binding является Service Binding к D1 Eyeball Worker. Привязка D1 Binding каждого пользовательского воркера несёт в себе закодированную информацию, авторизующую доступ к конкретной базе данных D1, которую D1 Eyeball Worker проверяет и пропускает запрос.
На следующей диаграмме показано выполнение запроса через HTTP API.
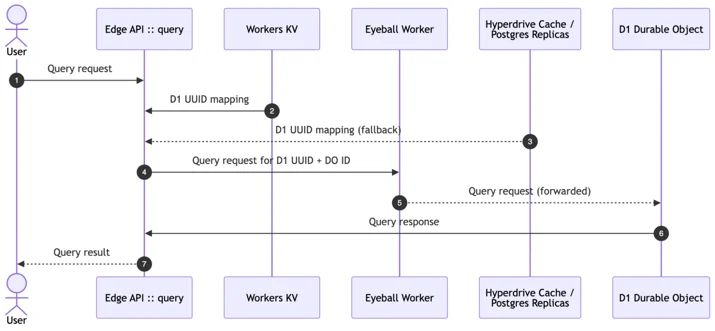
-
Пользователь отправляет запрос через HTTP API.
-
Edge API Worker сначала пытается загрузить сопоставление из UUID D1 в метаданные базы данных из Workers KV.
-
В редких случаях элемент не удаётся найти в Workers KV — либо из-за того, что запись завершилась неудачей, как описано ранее, либо из-за проблем с доступностью. В этом случае мы обращаемся к Hyperdrive, направляя запрос к репликам Postgres. Перед обращением к репликам Hyperdrive сначала проверяет свой кэш в месте вызова, затем свой кэш вблизи кластера Postgres, и только при промахе обоих кэшей запрашивает реплики Postgres для получения сопоставления.
-
Получив сопоставление, Edge API Worker вызывает Eyeball Worker через Worker Service Bindings, передавая нужные идентификаторы.
-
Eyeball Worker выполняет валидацию и перенаправляет запрос в Durable Object D1.
-
Durable Object D1 выполняет SQL-запрос и возвращает результат через Eyeball Worker в Edge API Worker, который возвращает его пользователю.
// Edge API Worker
const parsed = parseQueries(request);
const cachedDB = await withRetries(getCachedDatabase(parsed.dbUuid));
const response = await env.EYEBALL_WORKER.query({
db: cachedDB,
queries: parsed.queries,
});
return response;
Если вам интересно, почему мы используем newUniqueId() при создании базы данных, а не адресуем Durable Objects по «имени», чтобы исключить шаги 2 и 3, — ответ в том, чтобы избежать дополнительного обращения к центральному сопоставлению «имя» → «идентификатор Durable Object» при выполнении запросов. Одного идентификатора Durable Object недостаточно: нам также нужны другие метаданные, помогающие выбрать нужное пространство имён Durable Object Namespace в нашем Eyeball Worker. Таким образом, мы заменили бы одно обращение двумя.
В большинстве случаев, в том числе во многих наших собственных приложениях, адресация Durable Objects по имени прекрасно работает и устраняет необходимость в сопоставлении ваших идентификаторов с идентификатором Durable Object — начните с этого подхода и переходите к уникальным DO ID только при необходимости.
Вы также можете задаться вопросом: зачем использовать Workers KV, если у нас уже есть кэширование Hyperdrive?
Workers KV — это долговременное хранилище данных, а не просто кэш: если элемент вытесняется из граничного кэша KV, чтение обслуживается из собственного хранилища KV, а не из Postgres. Это выводит Postgres за рамки плоскости данных. В случае катастрофической очистки кэша миллион баз данных, одновременно пытающихся получить информацию о маршрутизации, привёл бы к метастабильным сбоям.
Напомним: запросы от пользовательского воркера с привязкой D1 Binding не требуют разрешения метаданных сопоставления UUID D1, поскольку сама привязка содержит эту информацию внутри — запросы идут напрямую в Eyeball Worker и Durable Object.
Подробнее о выполнении запросов и о том, как устроены Durable Objects под капотом, читайте в нашей статье о репликации чтения D1.
Теперь рассмотрим асинхронные процессы, поддерживающие D1.
Применение ограничений на использование хранилища
Любая платформа, достигающая определённого масштаба, рано или поздно сталкивается с необходимостью применять ограничения биллинга и использования. На момент написания статьи D1 имеет ограничение хранилища в 5 ГБ на аккаунт на бесплатном тарифе и 1 ТБ на Workers Paid (может быть увеличено по запросу).
В целом применение ограничений на использование и биллинговые системы хорошо подходят для согласованности в конечном счёте и асинхронной обработки. В следующих разделах мы рассмотрим, как D1 реализует применение этих ограничений.
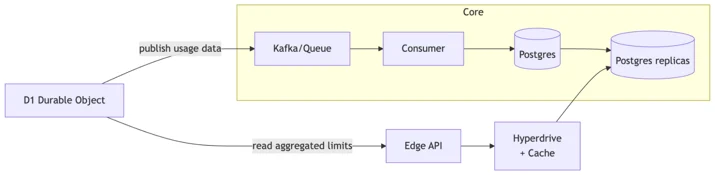
Асинхронная обработка обновлений с помощью очередей
Первый шаг — каждый Durable Object публикует обновления об использовании хранилища в очередь, аналогичную Kafka, для пакетной и асинхронной обработки. Плоскости управления не нужно обрабатывать каждое обновление синхронно: допустимо, если всплеск нагрузки не отразится немедленно и информация об использовании немного устареет. Главное — не перегружать Postgres и не затрагивать пользователей D1. Мы обеспечиваем это, ограничивая число потребителей очереди, а следовательно, и нагрузку на запись в Postgres.
Система потребителей очереди работает внутри центральных дата-центров Cloudflare («Core»), тогда как Durable Objects распределены по всему миру на грани сети. Использование агрегируется локально на каждом граничном сервере, а затем публикуется во внутреннюю систему очередей.
Руководящий принцип здесь — использование очереди для сглаживания и пакетирования записей в наш центральный региональный Postgres.
Пакетирование дельт использования и предварительные агрегации
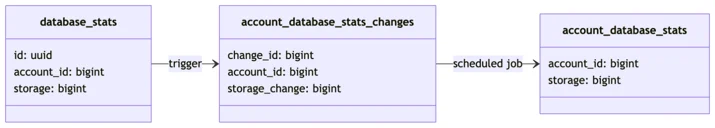
Потребитель очереди записывает последний зафиксированный размер каждой базы данных в таблицу Postgres. Однако для принятия решений об ограничениях нам нужна сумма всего использования хранилища по аккаунту. При проверке использования в момент применения ограничения мы не можем позволить себе выполнять SELECT sum(storage) FROM database_stats WHERE account_id = ?. Стоимость такого запроса линейно растёт с числом баз данных в аккаунте. Это не масштабируется для аккаунтов с миллионами баз данных D1, как у некоторых платформ агентного кодинга, построенных на D1.
В идеале нам нужна таблица поиска, позволяющая напрямую переходить от идентификатора аккаунта к суммарному использованию хранилища. Решение — использовать инкрементальное поддержание представлений (incremental view maintenance) для предварительного вычисления итога и его обновления при изменениях хранилища базы данных.
Назовём эту таблицу account_database_stats.
Теоретически потребитель очереди мог бы обновлять database_stats и account_database_stats при каждом поступающем обновлении. На практике это привело бы к значительной конкуренции за блокировку записи на одну строку для крупных аккаунтов. Вместо этого мы добавляем третью таблицу account_database_stats_changes, которая работает как очередь изменений. Это журнал всех изменений, который может содержать несколько записей для одного аккаунта. Мы затем периодически агрегируем обновления из этой таблицы в account_database_stats. Поток выглядит так:
-
Потребитель очереди записывает информацию об использовании в таблицу
database_statsдля конкретной базы данных. -
Триггер вычисляет разницу в размере хранилища для этой базы данных и помещает дельту в таблицу
account_database_stats_changes(одна строка на дельту). -
Запланированное задание выполняется каждую секунду, потребляет всё из
account_database_stats_changesи обновляетaccount_database_statsсуммой этих дельт.
Конкретно, запланированное задание выполняет следующий запрос:
WITH updates AS MATERIALIZED (
DELETE FROM account_database_stats_changes
RETURNING *
),
changes AS MATERIALIZED (
SELECT
account_id,
SUM(storage_change) AS storage
FROM updates
GROUP BY account_id
)
INSERT INTO account_database_stats (account_id, storage)
SELECT
account_id,
storage
FROM changes
ON CONFLICT (account_id) DO UPDATE
SET storage = account_database_stats.storage + EXCLUDED.storage;
Запрос получает список обновлений из account_database_stats_changes, агрегирует их по аккаунту, а затем записывает дельты в таблицу на уровне аккаунта. Это позволяет избежать конкуренции за запись в конкретные строки, поскольку мы агрегируем изменения перед записью.
Обобщённое табличное выражение (Common Table Expression, CTE) DELETE … RETURNING атомарно потребляет ожидающие изменения и передаёт удалённые строки следующему CTE. Postgres выполняет CTE с модификацией данных ровно один раз и до конца. Затем запрос группирует эти изменения по аккаунту и применяет одно агрегированное обновление на аккаунт, снижая конкуренцию при записи.
Этот шаблон проектирования схемы используется многими другими командами Cloudflare и позволяет масштабироваться до миллионов ресурсов на аккаунт без того, чтобы каждый дополнительный ресурс удорожал типовые операции.
Стоит отметить, что итог является согласованным в конечном счёте. Это не первоклассное инкрементальное поддержание представлений, как в некоторых других базах данных. Мы уже используем очередь для передачи обновлений от Durable Objects в Postgres, так что согласованность в конечном счёте нас устраивает.
Кэшированное чтение через Hyperdrive
Итак, у нас есть таблица поиска для суммарного хранилища каждого аккаунта. Что дальше?
Каждый Durable Object D1 периодически запрашивает сведения об использовании аккаунта через упомянутый ранее периодический пульс. Мы выполняем запрос SELECT storage FROM account_database_stats WHERE account_id = ? к репликам Postgres через Hyperdrive и сравниваем результат с правами доступа и лимитами тарифа аккаунта. Если суммарный объём превышает лимит, мы запрещаем все операции записи, которые увеличили бы размер базы данных.
Запрос направляется к репликам Postgres через Hyperdrive с использованием встроенного кэша Hyperdrive. Ключ кэша Hyperdrive формируется из запроса и всех значений параметров, а TTL истечения составляет несколько секунд. Используя идентификатор аккаунта в качестве единственного параметра, все базы данных этого аккаунта будут использовать одно кэшированное значение — именно то, что нам нужно.
И вот изящный трюк с кэшированием. Кэшируемые чтения через Hyperdrive по умолчанию имеют истечение 60 секунд, и конфигурация кэша Hyperdrive применяется ко всем запросам. Для некоторых запросов нам нужны кэшированные значения с меньшим TTL. Добавляя параметр dynamic_ttl к запросу, мы генерируем другой ключ кэша каждые X секунд, что позволяет быстрее читать свежие значения.
-- $2 = Math.floor(Date.now() / (X * 1000))
SELECT storage, $2 as dynamic_ttl
FROM account_database_stats WHERE account_id = $1
Может возникнуть соблазн сделать запрос, принимающий идентификатор аккаунта и идентификатор базы данных в качестве параметров. Это позволило бы найти итог по аккаунту и вычесть итог для текущей базы данных, получив точный ответ на вопрос «сколько хранилища разрешено использовать этой базе данных до начала применения ограничений?», что позволило бы начинать применять ограничения раньше.
Однако это означало бы, что идентификатор базы данных вошёл бы в ключ кэша Hyperdrive, что крайне ухудшило бы показатели попаданий в кэш. Для аккаунтов с миллионами активных баз данных ключ кэша на основе аккаунта означает, что большинство пульсов используют одни и те же кэшированные данные аккаунта из Hyperdrive и никогда не достигают Postgres.
Применение ограничений реагирует на изменения использования чуть медленнее, чем могло бы, но это приемлемо.
Отдельно от описанного выше потока у нас есть процесс, который периодически делает снимки информации об использовании хранилища из Postgres в кластер ClickHouse, что позволяет получить исторический обзор использования хранилища во времени. Эти события ClickHouse также являются источником истины для целей биллинга использования хранилища.
Применение ограничений на использование строк на грани сети
D1 также применяет ограничения на ежедневное использование для клиентов бесплатного тарифа. Используемый здесь паттерн отличается и заслуживает отдельного упоминания.
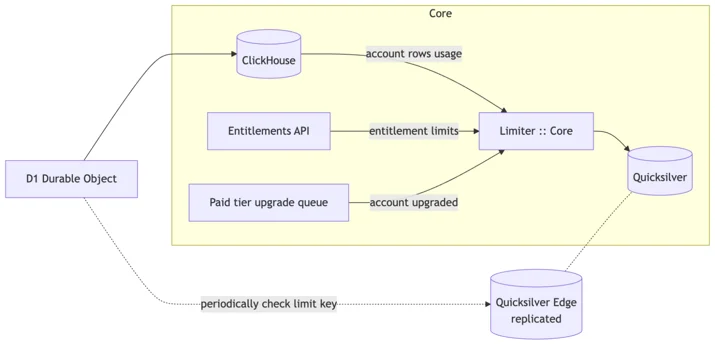
Каждый раз, когда в Durable Object выполняется SQL-запрос, мы отслеживаем количество прочитанных и записанных строк (включая обновления индексов при необходимости) для выполнения запроса. По завершении выполнения запроса мы публикуем событие об использовании, которое попадает в отдельный кластер ClickHouse. Эти события лежат в основе биллинга по числу строк.
Центральный компонент, назовём его «Limiter», работает в наших дата-центрах Core и периодически запрашивает события использования из ClickHouse с начала дня:
SELECT account_id, sum(rows_read) as reads, sum(rows_written) as writes
FROM requests
WHERE timestamp > toStartOfDay(now())
GROUP BY account_id HAVING reads > ? or writes > ?
ClickHouse справляется с подобными запросами лучше, чем Postgres, и мы также выигрываем от того, что не перегружаем наш кластер Postgres аналитическими запросами.
Для каждого аккаунта, превысившего лимит, мы проверяем его права доступа и тариф (это ограничение применяется только к пользователям бесплатного тарифа). Если аккаунт превысил лимит, мы отправляем ему письмо (с дедупликацией в течение дня) и устанавливаем ключ в Quicksilver — нашем внутреннем глобально распределённом хранилище ключ-значение с быстрой репликацией менее чем за секунду, — с датой истечения в конце дня. Если аккаунт переходит на Workers Paid, мы получаем сообщение в очереди и удаляем ключ в Quicksilver.
Каждый Durable Object D1 периодически проверяет Quicksilver на грани сети, чтобы узнать, ограничен ли его аккаунт, и если да — отклоняет все последующие запросы до снятия ограничения.
Разработчики на Developer Platform могут использовать Workers KV Instant, построенный поверх Quicksilver.
Этот паттерн полностью исключает нагрузку на региональный Postgres во всём этом потоке и использует правильный инструмент для правильной задачи. Аналитические запросы в ClickHouse обрабатываются эффективнее, чем в Postgres.
Этот паттерн распространён по всей компании, но отличается от подхода, который мы используем для применения ограничений на хранилище. В будущем мы, возможно, перенесём другие механизмы применения ограничений на использование этого паттерна.
Заключение
Архитектура D1 построена вокруг разделения задач плоскости управления и выполнения запросов на горячем пути.
Каждое архитектурное решение следует нашим руководящим принципам: сокращение централизованных региональных узких мест, использование кэширования и реплик для чтения в сочетании с согласованностью в конечном счёте там, где это возможно, для масштабирования пропускной способности чтения, а также выбор правильного хранилища для каждой задачи: Postgres — для транзакционных метаданных, ClickHouse — для аналитики, Workers KV — для глобально реплицированных данных маршрутизации.
Если вы создаёте платформу вайб-кодинга и хотите предоставить своим пользователям управляемые базы данных SQLite — быстро, экономично и надёжно — рассмотрите использование D1.
Если вы создаёте приложения на Workers и Developer Platform, паттерны и компромиссы, рассмотренные здесь, отражают реальные решения, принятые для D1. Используйте их как основу для своих приложений.
Ознакомьтесь с документацией D1 и расскажите нам о том, что вы создаёте, в канале D1 в Discord!
Благодарности
Огромная благодарность внутренним командам Databases и Hyperdrive компании Cloudflare, которые помогли нам выявить проблемные паттерны использования и предложили улучшения.