Всё началось с вопроса от нашей команды по безопасности и комплаенсу: «Можете показать, что именно изменилось в продакшене в прошлый вторник в 15:00?»
Мы не могли. Во всяком случае, не с уверенностью.
Мы — Dodo Payments, компания, строящая платёжную и биллинговую инфраструктуру. Мы обрабатываем реальные деньги для бизнеса в разных странах. Это означает, что соответствие стандарту PCI DSS для нас не опционально — оно жизненно необходимо. А PCI требует того, чего у нас не было: полной, поддающейся аудиту истории каждого изменения в продакшен-окружении.
Но комплаенс был лишь поводом. Глубинные проблемы лежали куда серьёзнее.
С чего всё началось: почему нам нужны были перемены
Когда строишь платёжную инфраструктуру, ночами не даёт покоя пять вещей.
Масштабируемость (Scalability). Трафик не растёт линейно. Продавец запускает флеш-распродажу, и вдруг вам нужно обрабатывать объём в 10 раз выше обычного. Инфраструктура должна масштабироваться автоматически, предсказуемо и без ручного вмешательства в два часа ночи.
Надёжность (Reliability). Каждый неудавшийся запрос — это неудавшийся платёж. Неудавшийся платёж — потерянная выручка клиента. Потерянная выручка — потеря доверия. В платежах надёжность — не фича, это и есть продукт.
Журналы аудита и комплаенс. PCI DSS, SOC 2 и различные региональные нормативы требуют одного и того же: докажите, что вы точно знаете, что работает в продакшене, кто, когда и зачем это изменил. «Кажется, мы что-то задеплоили на прошлой неделе» здесь не подходит.
Мониторинг инфраструктуры. Нельзя устранить то, чего не видишь. Когда растёт задержка или растут показатели ошибок, нужно узнать об этом немедленно — и иметь достаточно контекста, чтобы быстро поставить диагноз.
Безопасность и управление уязвимостями. Платёжные системы — высокоценная цель. Каждая зависимость, каждый образ контейнера, каждое конфигурационное решение — потенциальная точка атаки. Нужно знать, что запущено и есть ли там уязвимости.
Наша ранняя инфраструктура не справлялась ни с одним из этих требований.
Проблемы, с которыми мы столкнулись
В начале наш процесс деплоя был… назовём его «творческим»:
-
у инженеров был прямой доступ к
kubectlв продакшене; -
деплои производились через CI-пайплайны, которые пушили изменения напрямую в кластеры;
-
конфигурация хранилась частично в Git, частично в головах инженеров;
-
откат означал «найти последний рабочий коммит и молиться».
Был стандартный набор инструментов: CI-задачи, bash-скрипты и общий Slack-канал, где перед запуском команд кто-нибудь писал «деплою в прод».
Работало. До поры до времени.
Конфигурационный дрейф (configuration drift) был повсюду. Продакшен редко совпадал с тем, что лежало в Git. Кто-то делал «быстрый фикс» прямо в кластере, забывал закоммитить, и при следующем деплое это затиралось. Когда команда по комплаенсу спрашивала, что запущено в продакшене, нам приходилось вручную инспектировать кластер — и надеяться, что с последней проверки ничего не изменилось.
Нормального журнала аудита не было. Когда что-то ломалось, мы часами разбирались, что изменилось. Это код? Конфиг? Событие масштабирования? Кто одобрил? Аудиторы PCI не принимают ответ «мы почти уверены, что всё было в порядке».
Масштабирование было ручным и реактивным. Мы замечали высокую нагрузку на CPU, заходили в дашборд и вручную увеличивали количество реплик. К тому моменту клиенты уже успевали почувствовать замедление.
Мониторинг был фрагментированным. Логи шли в одно место, метрики — в другое, трейсы — никуда. Чтобы разобраться в инциденте по всем сервисам, нужно было открыть пять разных инструментов и надеяться, что временны́е метки совпадут.
Отслеживания уязвимостей не существовало. У нас не было систематического способа понять, какие образы контейнеров запущены, какие версии зависимостей они содержат и нет ли среди них известных CVE. Проверки безопасности были ручными и редкими.
Деплои пугали. Инженеры стали пакетировать изменения, потому что каждый деплой казался рискованным. Это делало деплои ещё рискованнее — в них накапливалось больше изменений. Страх порождал ещё больший страх.
Нам нужна была инфраструктура, которая была бы проверяема по умолчанию, масштабировалась без вмешательства, наблюдалась end-to-end и была безопасна по дизайну. Нам нужно было заново выстроить всю историю с деплоями.
Знакомство с GitOps
Основная идея GitOps проста: Git — единственный источник истины для вашей инфраструктуры. Хотите что-то изменить — меняйте это в Git. Система наблюдает за Git и приводит реальность в соответствие с тем, что там объявлено.
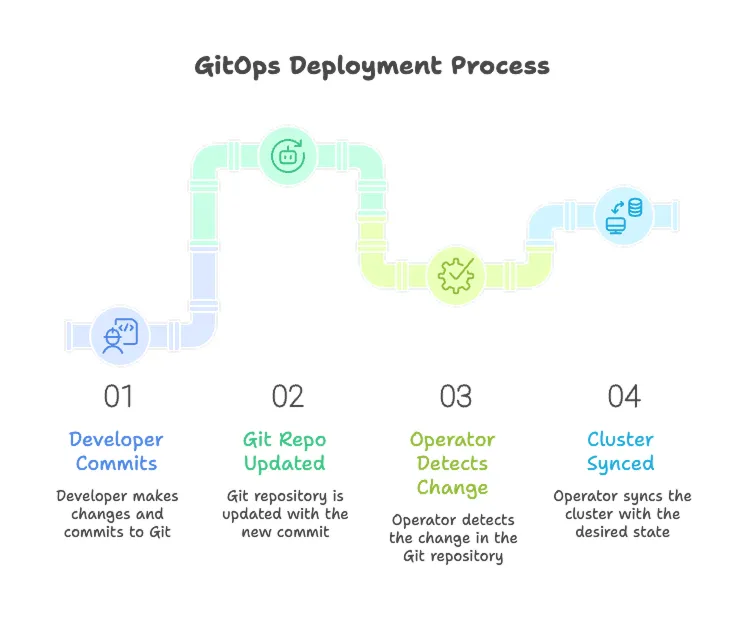
Это принципиально отличается от традиционного CI/CD, где пайплайн пушит изменения в инфраструктуру. В GitOps оператор, работающий внутри кластера, тянет желаемое состояние и согласовывает с ним реальность.
Почему это важно?
Журнал аудита — бесплатно. Каждое изменение — это Git-коммит. Хотите узнать, кто что изменил и когда? git log. Хотите откатить? git revert.
Обнаружение дрейфа встроено. Оператор непрерывно сравнивает фактическое состояние с желаемым. Если кто-то вносит изменение прямо в кластер, оператор его откатывает. Никакого «применить и забыть».
Декларативность везде. Вы описываете что хотите получить, а не как этого достичь. Оператор сам вычисляет дельту и применяет её.
Для глубокого погружения в принципы GitOps отличной отправной точкой будет сайт gitops.tech.
Почему ArgoCD
Мы рассматривали три основных варианта для GitOps-оператора: Flux, ArgoCD и кастомное решение.
ArgoCD победил по нескольким причинам.
Интерфейс, который реально полезен. ArgoCD предоставляет веб-интерфейс, показывающий состояние приложений, статус синхронизации, дерево ресурсов и логи. Когда что-то идёт не так, видно точно, какие ресурсы рассинхронизированы и почему. Это не просто приятная мелочь — это существенно сокращает время отладки.
Приложения из нескольких источников (multi-source applications). Нам нужно было объединять Helm-чарты из внешних репозиториев с нашими собственными override-значениями и дополнительными манифестами. Функция multi-source в ArgoCD решает это чисто.
Зрелый и проверенный в боевых условиях. ArgoCD — graduated-проект CNCF, который используют тысячи организаций. Сообщество активно, документация добротная, а когда мы сталкивались с крайними случаями, кто-то уже, как правило, проходил через них раньше.
Понятные политики синхронизации. Автоматическая синхронизация с самовосстановлением и pruning даёт именно то поведение, которое нам нужно: Git всегда является истиной, а кластер всегда сходится к соответствию с ней.
Структура репозитория
Мы остановились на выделенном инфраструктурном репозитории, содержащем всю конфигурацию деплоя. Код приложений живёт в отдельных репозиториях; infra-репо содержит только Kubernetes-манифесты и конфигурацию развёртывания.
infra/
├── apps/
│   ├── root/         # ArgoCD Application definitions
│   ├── dev/          # Development environment
│   │   └── services/
│   │       ├── service-a/
│   │       ├── service-b/
│   │       └── ...
│   └── prod/         # Production environment
│       └── services/
│           ├── service-a/
│           ├── service-b/
│           └── ...
Каждое приложение следует единой структуре:
service-a/
├── namespace.yaml
├── deployment.yaml
├── service.yaml
├── ingress.yaml
├── serviceaccount.yaml
├── secrets-sync.yml
└── hpa.yaml (prod only)
Эта согласованность важна. Когда кому-то нужно разобраться, как деплоится сервис, он точно знает, где смотреть. Когда нужно добавить новый сервис, копируем существующий и вносим правки.
Разделение dev и production
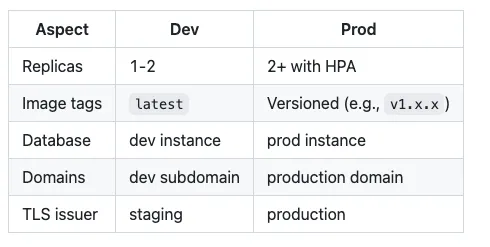
Мы запускаем два отдельных Kubernetes-кластера: один для разработки, другой для продакшена. Они разделяют одну структуру репозитория, но имеют разные конфигурации.
Различия сделаны намеренно:
Почему отдельные кластеры, а не неймспейсы?
Мы рассматривали вариант с неймспейсами внутри одного кластера, но отказались по нескольким причинам.
Радиус взрыва (blast radius). Ошибка конфигурации в dev не должна влиять на продакшен. Отдельные кластеры обеспечивают жёсткую изоляцию.
Управление затратами. Dev-кластер может использовать более дешёвые типы узлов и агрессивно масштабироваться вниз. Прод требует надёжной, правильно подобранной инфраструктуры.
Тестирование инфраструктурных изменений. Можно тестировать изменения на уровне кластера (обновления service mesh, изменения пулов узлов) в dev перед применением в продакшене.
Комплаенс. Обработка платежей предъявляет жёсткие требования. Разделение окружений упрощает прохождение аудитов.
Как ArgoCD синхронизирует наши приложения
Каждое приложение определяется как ресурс ArgoCD Application. Вот концептуальная структура:
Application: service-a
├── Source: git repository
│   └── Path: apps/prod/services/service-a
├── Destination: production cluster
├── Sync Policy:
│   ├── Automated: true
│   ├── Self-heal: true (revert manual changes)
│   └── Prune: true (delete removed resources)
└── Ignore Differences:
    └── Secrets (managed externally)
Политика автоматической синхронизации означает, что ArgoCD применяет изменения, как только они попадают в основную ветку. Ручного вмешательства не требуется. Если кто-то изменяет что-то прямо в кластере, самовосстановление откатывает это в течение нескольких минут.
Для сложных приложений — баз данных или сторонних инструментов — мы используем функцию multi-source в ArgoCD:
Application: complex-app
├── Source 1: Helm chart from upstream repo
├── Source 2: Values file from infra repo
└── Source 3: Additional manifests (ingress, service mesh config)
Это позволяет использовать внешние Helm-чарты, сохраняя собственные кастомизации и дополнительные ресурсы.
Паттерн сайдкара с прокси базы данных
Каждый сервис, которому нужен доступ к базе данных, работает с сайдкаром (sidecar) прокси базы данных. Мы приняли этот паттерн рано, и он себя оправдал.
Pod
├── Application container (port 8080)
├── Database proxy sidecar (port 5432)
└── Service mesh sidecar (injected)
Прокси базы данных берёт на себя:
-
безопасные подключения к базе без её публичного открытия;
-
аутентификацию на основе IAM через Workload Identity;
-
пулинг соединений и поддержание активных соединений (keepalives).
Мы используем Workload Identity для аутентификации прокси. Каждый сервис имеет Kubernetes ServiceAccount, привязанный к облачному IAM-идентификатору:
ServiceAccount: service-sa
└── Annotation: bound to cloud IAM service account
Это означает, что никаких ключей сервисного аккаунта, болтающихся где попало. Прокси аутентифицируется с использованием идентичности пода, которой управляет облачный провайдер автоматически.
Для CronJob’ов мы используем нативный паттерн сайдкара, введённый в Kubernetes 1.28, где прокси базы данных запускается как init-контейнер с restartPolicy: Always. Это гарантирует, что прокси работает на протяжении всего времени выполнения задачи.
Управление секретами
Секреты — самая сложная часть любого пайплайна развёртывания. Их нельзя хранить в Git (очевидно), но они нужны в подах.
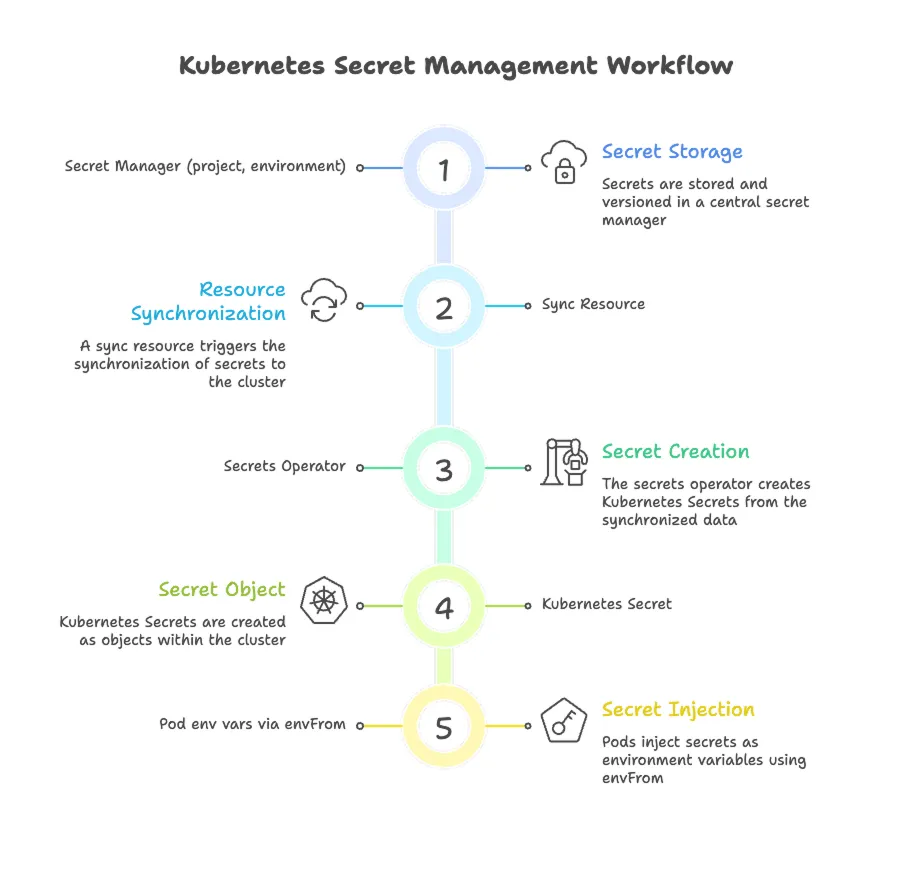
Мы используем внешнее решение для управления секретами. Вот как это работает:
-
секреты хранятся в менеджере секретов, организованном по проектам и окружениям;
-
в каждом кластере работает Kubernetes-оператор;
-
кастомные ресурсы сообщают оператору, какие секреты синхронизировать;
-
оператор автоматически создаёт и обновляет Kubernetes Secrets.
Преимущества этого подхода:
-
секреты версионированы и проверяемы в менеджере секретов;
-
изменения распространяются автоматически (для ротации секрета не нужен повторный деплой);
-
ArgoCD игнорирует данные секретов (через
ignoreDifferences), поэтому не конфликтует с оператором; -
инженерам никогда не нужно работать с секретами в открытом виде.
Горизонтальное автомасштабирование подов
Продакшен-сервисы работают с HPA (Horizontal Pod Autoscaler), масштабирующимися по CPU и памяти:
HPA: service-hpa
├── Min replicas: 2
├── Max replicas: 10
├── Target CPU: 70%
├── Target Memory: 70%
└── Scale-down stabilization: 150 seconds
Окно стабилизации предотвращает «флаппинг» (flapping) во время пиков трафика. Лучше иметь немного избыточную мощность, чем быстрые циклы масштабирования вверх-вниз.
Dev-окружения не используют HPA — там фиксированное количество реплик, чтобы затраты были предсказуемы.
Корректное завершение работы
Платёжные сервисы не могут просто умереть. Завершение пода может прервать транзакцию в процессе выполнения, а это недопустимо.
Каждый деплой включает конфигурацию корректного завершения работы (graceful shutdown):
Lifecycle:
  preStop: sleep 5 seconds
TerminationGracePeriod: 60 seconds
Задержка preStop даёт сайдкару service mesh время слить соединения. 60-секундный grace period даёт приложению время завершить обрабатываемые в данный момент запросы до принудительного завершения.
Процесс развёртывания
Вот что происходит, когда инженер хочет задеплоить изменение:
-
Изменение кода: инженер пушит в репозиторий приложения.
-
Сборка в CI: CI-пайплайн собирает новый Docker-образ, тегирует его, пушит в container registry.
-
Обновление манифеста: инженер (или автоматика) обновляет тег образа в infra-репо.
-
ArgoCD обнаруживает: в течение 3 минут ArgoCD замечает изменение в Git.
-
Синхронизация: ArgoCD применяет новые манифесты к кластеру.
-
Rolling update: Kubernetes выполняет rolling-деплой.
-
Проверка здоровья: ArgoCD проверяет, что новые поды здоровы.
Для dev-окружения шаг 3 часто автоматизирован — мы обновляем до latest и полагаемся на политику Always при pull образа. Для прода мы используем явные теги версий и требуем PR для их изменения.
Откат так же прост: откатываем коммит в Git, и ArgoCD синхронизируется обратно к предыдущему состоянию.
Что мы сделали неправильно
Мы слишком поздно зафиксировали теги образов
Несколько месяцев наше dev-окружение работало с тегами latest повсюду. Всё шло нормально, пока не перестало — сторонняя зависимость опубликовала ломающее изменение, и dev внезапно сломался так, как прод не ломался.
Теперь мы фиксируем версии везде, даже в dev. Тег latest используется только для сервисов, которые мы сами контролируем и активно разрабатываем. Сторонние образы всегда используют конкретные версии.
Мы недооценили важность resource requests
Планирование в Kubernetes настолько хорошо, насколько хороши ваши resource requests. Изначально мы выставляли консервативные запросы, чтобы максимизировать утилизацию узлов, — это приводило к проблемам «шумного соседа» и непредсказуемой производительности.
После нескольких инцидентов мы перешли к более щедрым resource requests, особенно по памяти. Лучше предсказуемая производительность с некоторым расходом, чем OOM kill во время пиков трафика.
Результаты
Шесть месяцев спустя после перехода на GitOps:
Частота деплоев выросла в 4 раза. Инженеры деплоят несколько раз в день, потому что это ощущается безопасным.
Время отката сократилось с часов до минут. git revert + ожидание синхронизации.
Ноль инцидентов из серии «что изменилось?». Каждое изменение в продакшене имеет Git-коммит с контекстом.
Время онбординга сократилось вдвое. Новые инженеры понимают процесс деплоя, просто прочитав infra-репо.
Комплаенс-аудиты упростились. Аудиторы обожают Git-логи.
Операционные накладные расходы реальны — ArgoCD требует мониторинга, infra-репо нуждается в обслуживании, и есть кривая обучения. Но для нашего масштаба и наших требований оно того однозначно стоит.
Стоит ли переходить на GitOps?
GitOps имеет смысл, если:
-
вы запускаете несколько сервисов в Kubernetes;
-
в вашей команде деплоят несколько человек;
-
комплаенс и журналы аудита важны;
-
вы хотите избавиться от страха перед деплоями;
-
вам надоели сюрпризы в духе «в стейджинге работало».
GitOps может оказаться избыточным, если:
-
у вас один монолит с редкими деплоями;
-
вы соло-разработчик, способный держать состояние в голове;
-
вы ещё не работаете с Kubernetes;
-
ваша команда маленькая и координировать деплои легко.
Честный ответ: инвестиция в GitOps окупается при определённом масштабе. Ниже этого масштаба вполне работают более простые решения. Для нас, управляющих платёжной платформой с жёсткими требованиями к безопасности, проверяемости и надёжности, — GitOps не опционален. Это инфраструктура.
Ключевые выводы
Git как источник истины устраняет конфигурационный дрейф и обеспечивает автоматические журналы аудита. Никаких расследований «что изменилось?».
Отдельные кластеры для dev и prod дают жёсткую изоляцию, которую неймспейсы обеспечить не могут. Дополнительные затраты стоят спокойствия.
Единая структура директорий для сервисов снижает когнитивную нагрузку. Когда всё выглядит одинаково, разбираться в проблемах быстрее.
Workload Identity лучше ключей сервисного аккаунта. Пусть облачный провайдер занимается аутентификацией вместо того, чтобы вы управляли учётными данными сами.
Внешнее управление секретами держит секреты вне Git, не жертвуя автоматизацией. Не изобретайте здесь своё решение.
Конфигурация graceful shutdown обязательна для платёжных сервисов. Закладывайте её с первого дня.
Фиксируйте версии образов. Даже в dev. Тег latest рано или поздно вас подведёт.